本地跑大模型有多难?开源工具把5步压缩成双击安装

开源图形化向导把本地大模型安装压缩为三步双击,让门槛从「配环境」转向「看显存」。
针对本地运行大模型「装环境、下权重、配依赖」环环相扣且报错难懂的痛点,一个开源项目提供了纯图形化的安装向导,把流程压缩为双击即可完成。向导会先自动检测显卡型号、显存、磁盘空间和已装组件,随后只列出显存跑得动的模型并标注推荐,本机已有模型会被自动发现复用,避免重复下载。安装过程中支持上下文长度 4000 到 64000 实时切换、显存占用当场估算、下载进度显示与断点续传,下载后还会额外加载一次做显存复检,失败时明确说明停在哪一步、原因及处理方式并支持一键重试。装完生成桌面快捷方式与控制台,可增删模型、开关自启、开启局域网共享和一键卸载,全程离线免费开源。
为什么本地跑大模型这么难?
想在本地运行大模型的人,大多经历过这样的挫败:装虚拟环境、装推理引擎、下载模型权重、配置环境变量、接入智能体框架——环环相扣,任何一步卡住,后面的流程就走不下去。
更麻烦的是报错信息。对非技术用户来说,终端里滚出来的红色文字几乎等于天书。你明明只是想「在本地跟AI聊个天」,却被CUDA版本不匹配、依赖冲突和路径问题拦在门外。
据B站UP主分享,他做的开源项目正是从这个痛点切入:把整套流程压缩成一个纯图形化的安装向导,号称「双击一下」就能完成。
文中提到的几个术语值得稍作解释。CUDA 是 NVIDIA 推出的并行计算平台与编程接口,绝大多数本地推理引擎都依赖它调用 GPU 算力。它和显卡驱动、推理引擎之间有严格的版本对应关系,版本错配几乎是本地部署最常见的失败原因。依赖冲突指多个软件包要求同一个库的不同版本,Python 生态中尤为普遍,通常由虚拟环境隔离来缓解。模型权重则是模型训练后保存下来的参数文件,动辄数十 GB,需要下载到本地才能推理。这几个环节彼此耦合,正是「环环相扣、一步卡住全盘皆输」的根源。
三步走完安装:从检测硬件到生成快捷方式
这个向导的逻辑并不复杂,但每一步都在解决具体问题。
打开向导后,它自动读取显卡型号、显存大小、磁盘空间和已安装组件,然后告诉你接下来只需要三步。装完桌面直接生成启动快捷方式,不需要记住命令行参数。
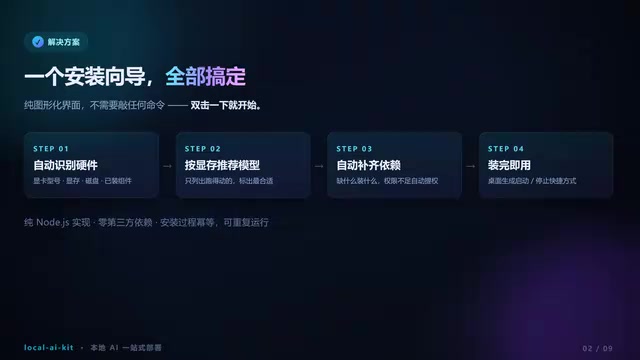
装完之后的控制台可以随时增删模型、开关开机自启、开启局域网共享,也支持一键卸载。用完即走,不会在系统里留下难以清理的残留。
选模型:只列跑得动的,自动发现已有模型
选模型这一步,向导做了两件减法。
第一,它只列出你显存跑得动的模型,最适合的还会标上「推荐」。第二,本机已有的模型会被自动发现并直接复用,不需要重新下载几十GB的权重文件。
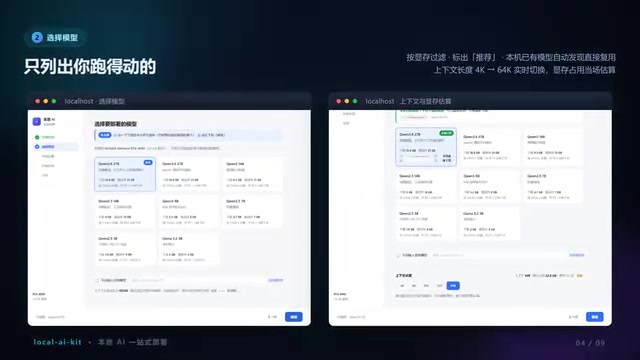
上下文长度支持从4000到64000实时切换,显存占用当场估算。存放位置环节带磁盘用量和空间预警,不够就拦住,不让你带着一个必然失败的任务往下走。显卡驱动过旧时,它也会在下载之前提示。
显存(VRAM)是显卡自带的高速内存,模型权重、上下文缓存和中间计算结果都要装在里面,因此它往往比算力更早成为瓶颈。模型能以什么精度加载、能开多长的上下文,基本由显存大小决定。上下文长度指模型一次能「记住」的 token 数量,从 4000 到 64000 的跨度意味着长文档处理能力和显存占用会同步放大——这也是向导要实时估算显存占用的原因。能按显存反向筛选并给出「推荐」标记,实际是把「我该选哪个模型」这个高频困惑,转换成了一次可计算的匹配。
下载与验证:断点续传、显存复检、失败可重试
下载模型时,界面显示整体进度、实时速度和预计剩余时间。中断了不要紧,重新双击就接着下。
下载完成后还有一道保险:额外加载一次模型,确认显存装得下。如果失败,它不会只甩一句报错,而是写清楚停在哪一步、原因是什么、你可以怎么做,并支持一键重试。
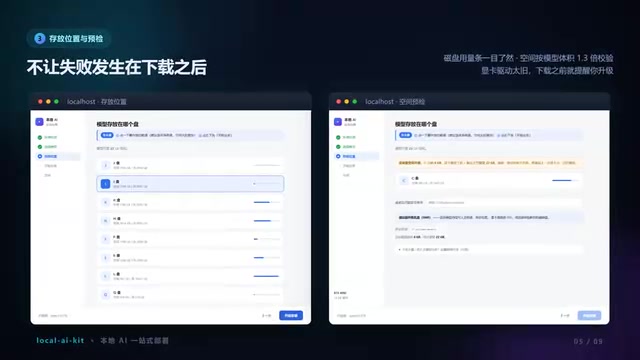
这个设计思路值得关注:它把「失败处理」当作流程的一部分,而不是把异常抛给用户。对不熟悉命令行的人来说,能看懂「哪里错了、怎么改」比单纯看到错误码重要得多。
断点续传指下载中断后可从已完成的部分继续,而不必从头开始。对几十 GB 的权重文件来说,这是刚需——一次网络抖动就可能让数小时的下载付诸东流。显存复检则是在正式加载前再做一次实际验证:模型文件大小与运行时真实占用并不完全等价,量化方式、并行策略和上下文设置都会影响最终需求。提前试加载一次,可以把「看起来能跑、跑起来就崩」的问题挡在进入使用之前,也避免了用户面对一个没有明确归因的崩溃现场。
装完之后:控制台管理模型与局域网共享
安装完成,桌面会多出三个图标。其中的控制台是日常管理入口。
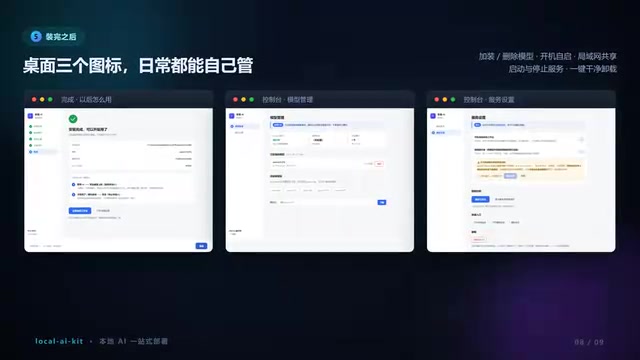
在控制台里,你可以随时加装或删除模型、开关开机自启、开启局域网共享,也能干净地一键卸载。整个过程不连网、不花钱、不限次数,数据全程留在自己的显卡上。
项目完全开源。作者在视频里放了二维码,扫描即可找到下载入口——解压、双击、安装,就这三步。
这类工具意味着什么
本地大模型的门槛正在从「会不会配环境」转向「有没有足够的显存」。这个开源向导做的事情,是把环境配置的复杂度封装起来,让硬件检测、模型推荐、下载管理和失败恢复都由程序自动完成。
它没有让本地推理在技术上变简单,但让操作流程变得足够直白:双击、点下一步、开始用。对想尝试本地模型又不想折腾命令行的人来说,这可能是当下最省力的入口之一。
当然,工具能覆盖的仍是安装与运行层面。模型选择、参数调优和智能体框架接入,仍然需要用户自己判断。开源项目后续能否跟上推理引擎的更新节奏,也值得持续观察。
局域网共享指让同一网络下的其他设备(如手机、笔记本)也能访问这台机器上的模型服务,等于把本地显卡变成一个小型私有推理服务器,数据不出内网。推理引擎则是真正执行模型计算的核心组件,例如 llama.cpp、Ollama、vLLM 等,它们迭代频繁,接口和默认参数时常变动。这正是文中「能否跟上更新节奏」的关键所在:一个封装型工具的价值,很大程度上取决于它能否持续适配底层引擎的变化,否则一旦上游升级,好用的向导也可能迅速失效。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。