#推理引擎
共 19 篇相关文章

LLM推理引擎怎么选?七大主流方案全解析
七个主流LLM推理引擎怎么选?本文整理Llama CPP、MLXLM、XLama V3、Hugging Face Transformers、VLLM、SGLang、LMDeploy和TensorRT-LLM的优化方向与适用场景,帮你按CPU、GPU并发、显存受限和NVIDIA数据中心快速定位合适方案。

本地跑大模型工具怎么选?五大主流方案一次讲清
一文讲清llama.cpp、Ollama、LM Studio、vLLM、MLX LM五大本地大模型运行工具的定位与差异:从GGUF格式、OpenAI兼容API到分页注意力与苹果统一内存,给出开发原型、普通用户和生产部署的选型建议。

Flide引擎:精确状态分叉,决策推理提速9.5倍
Flide是一种高效精确的推理引擎,通过ForkAttention在GPU索引中实现决策请求的精确状态分叉,在保持输出概率精确性的同时,相比vLLM和SGLang最高提速9.5倍,为LLM智能体决策推理提供新基础。

vLLM v0.33.0 版本发布:一次值得关注的推理引擎更新
vLLM 发布 v0.33.0 版本,本文梳理该版本发布页面的基本信息,分析 vLLM 在大模型推理栈中的定位,并就缺少详细更新日志情况下的升级策略给出建议。

Cloudflare GLM-5.3泄漏用户提示词:200 OK背后的内存残留
Cloudflare GLM-5.3因SGLang内存页未清理bug,向155条响应中泄漏了其他用户的提示词,且全部返回200 OK。复盘揭示测试只查状态码不验内容的盲区,自托管用户需升级SGLang 0.5.22。
本地运行AI模型全指南:推理引擎与工具栈解析
系统梳理本地运行AI大模型的完整工具栈:从PyTorch、GGML等计算库,到llama.cpp、vLLM、SGLang等推理引擎,再到Ollama、LM Studio等封装层,结合实测数据说明各工具的性能差异与选型逻辑。
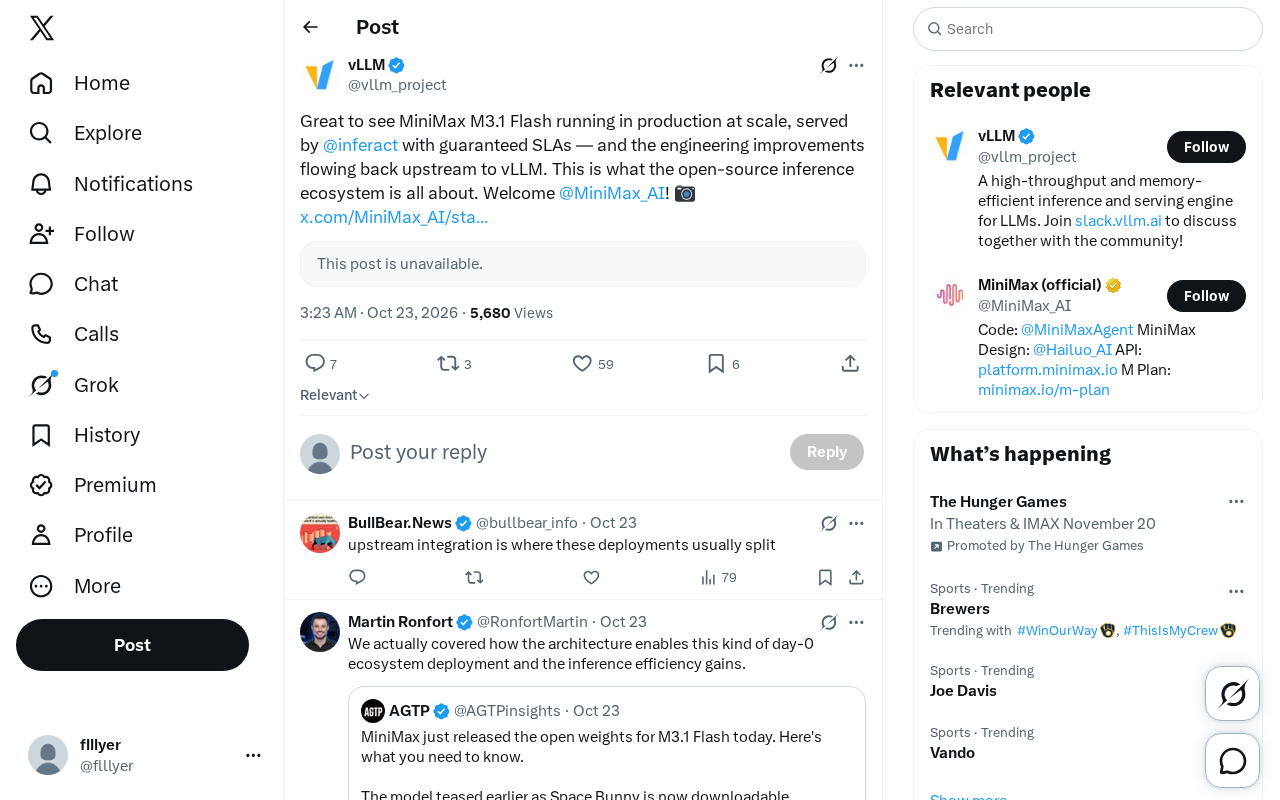
MiniMax M3.1 Flash 落地生产:开源推理生态的里程碑
MiniMax M3.1 Flash 已在生产环境大规模运行,由 @inferact 提供带 SLA 保障的推理服务,工程改进回流 vLLM 上游。本文分析其对开源推理生态的意义及对开发者选型的启示。

本地大模型部署三条路线:个人、企业、专用引擎怎么选
本地大模型部署分三条路线:个人端 Ollama、LM Studio、LLaMA.cpp 如何取舍;企业端 vLLM 与 SGLang 的内存复用模式差异;专用引擎 NIFL、Halogen、Strix 的适用边界。用三个问题帮你选对工具。
Liquid AI发布RIPL推理引擎:LFM延迟降至50毫秒内
Liquid AI 发布实时推理引擎 RIPL,单张 B200 上 LFM2.5-1.2B 的 p95 延迟比 Qwen3.5-0.8B 在 vLLM 上低 14.4 至 28.4 倍。本文分析专用推理引擎与小模型实时落地的技术逻辑。

DeepSeek开源DeepInfer推理引擎:能跑什么、缺什么
DeepSeek 开源了 API 背后的推理引擎 DeepInfer,但它离线专用、仅支持 V4.1-Flash 模型、仅支持 Blackwell 或 Ascend 硬件。本文拆解这三个限制条件、真正受益的团队画像,以及这次开源在策略上的信号意义。

DeepSeek开源推理引擎DeepInfer:单集群日赚2200万美元,81天回本
DeepSeek开源推理引擎DeepInfer,单集群日处理155T token,日收入2200万美元,毛利率约80%,81天回本。本文分析其性能数据、技术逻辑及对AI推理行业的潜在冲击。

DeepSeek开源推理引擎:大模型部署门槛再降低
DeepSeek开源其推理引擎,开发者可本地复现官方推理路径。本文分析推理引擎开源的实际价值、社区反应与实操建议,探讨其对私有化部署和性能调优的影响。

vLLM vs Ollama vs llama.cpp:LLM推理引擎终极选型指南
深度对比 vLLM、Ollama、llama.cpp 三大 LLM 推理引擎:从 PagedAttention 显存管理、GGUF 量化到并发吞吐实测,给出单卡、Apple Silicon 与企业 GPU 集群的完整选型与硬件配置建议。
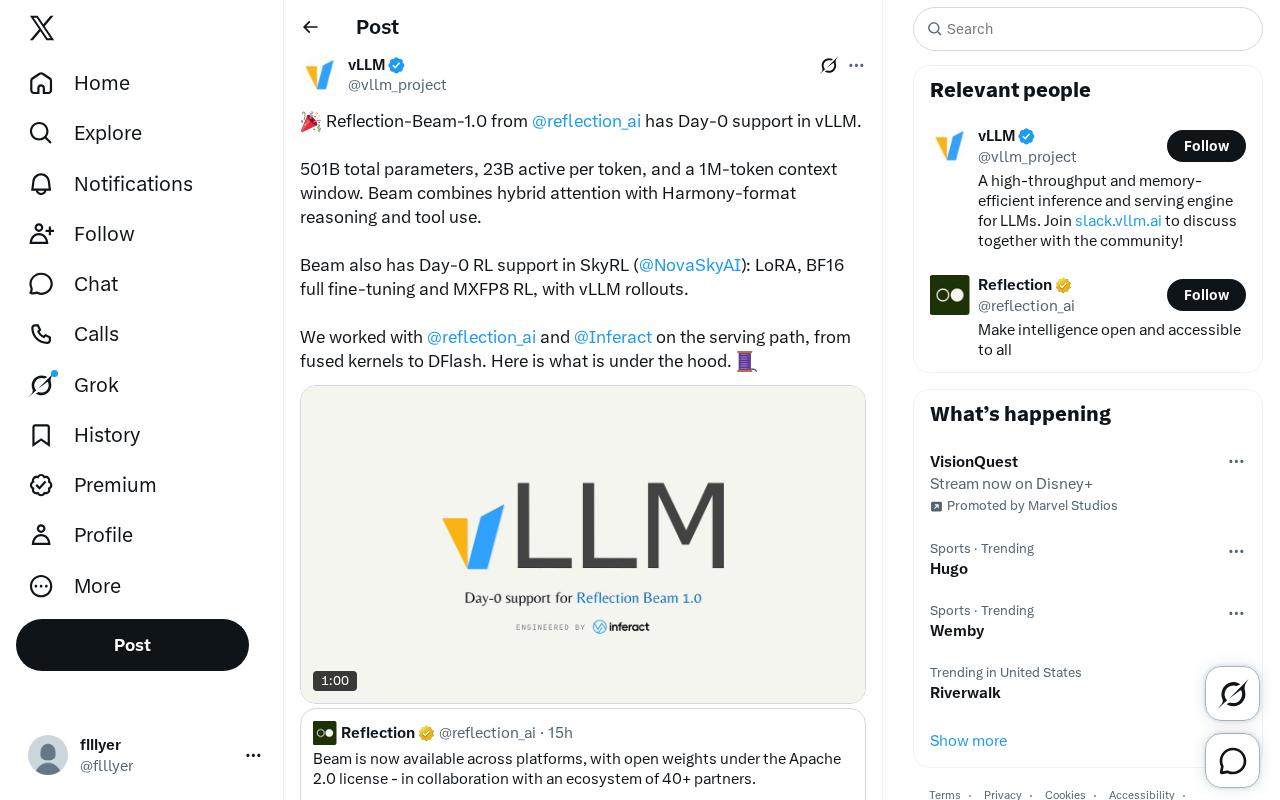
Reflection-Beam-1.0发布:501B参数MoE模型首日支持vLLM
Reflection-Beam-1.0发布:501B总参数、23B激活的MoE模型,支持1M token上下文与Harmony格式推理,获vLLM Day-0推理支持和SkyRL Day-0强化学习训练支持,混合注意力架构与融合kernel优化细节解析。

单卡RTX 5090跑出2788 tokens/s:扩散LLM加速框架ORL全开源
扩散语言模型加速框架ORL全开源:用On-Policy残差学习提升收敛速度,配合dlmrt推理引擎在单张RTX 5090实现2788 tokens/s,HumanEval pass@1从82.9%升至89.6%,并提供完整训练与评估代码。
本地部署大模型实战:Ollama、llama.cpp 与 vLLM 深度对比
深度对比 Ollama、llama.cpp 与 vLLM 三大本地大模型部署引擎:易用性、显存要求、量化选择、吞吐性能与成本账,附决策路径与故障排查,帮你选对推理后端。
vLLM v0.31.1rc0发布:按缓存层级暴露缓存Prompt Token指标
vLLM 发布 v0.31.1rc0 候选版本,新增按缓存层级(cache tier)暴露缓存 prompt token 的指标功能(PR #56318),为大规模 LLM 推理服务的成本优化与性能监控提供更细粒度的可观测性数据。

vLLM 亮相 PyTorchCon:开源推理基础设施的集体发声
vLLM 核心维护者团队集体亮相 PyTorchCon 北美大会,Simon Mo 发表开源推理基础设施主题演讲,Red Hat AI 团队分享智能体推理与注意力机制,展现开源大模型推理栈的技术风向。
