BERT预测政党归属:解析奥地利议会演讲新方法

微调BERT预测奥地利议员政党归属,从概率分布揭示政党演讲风格演变。
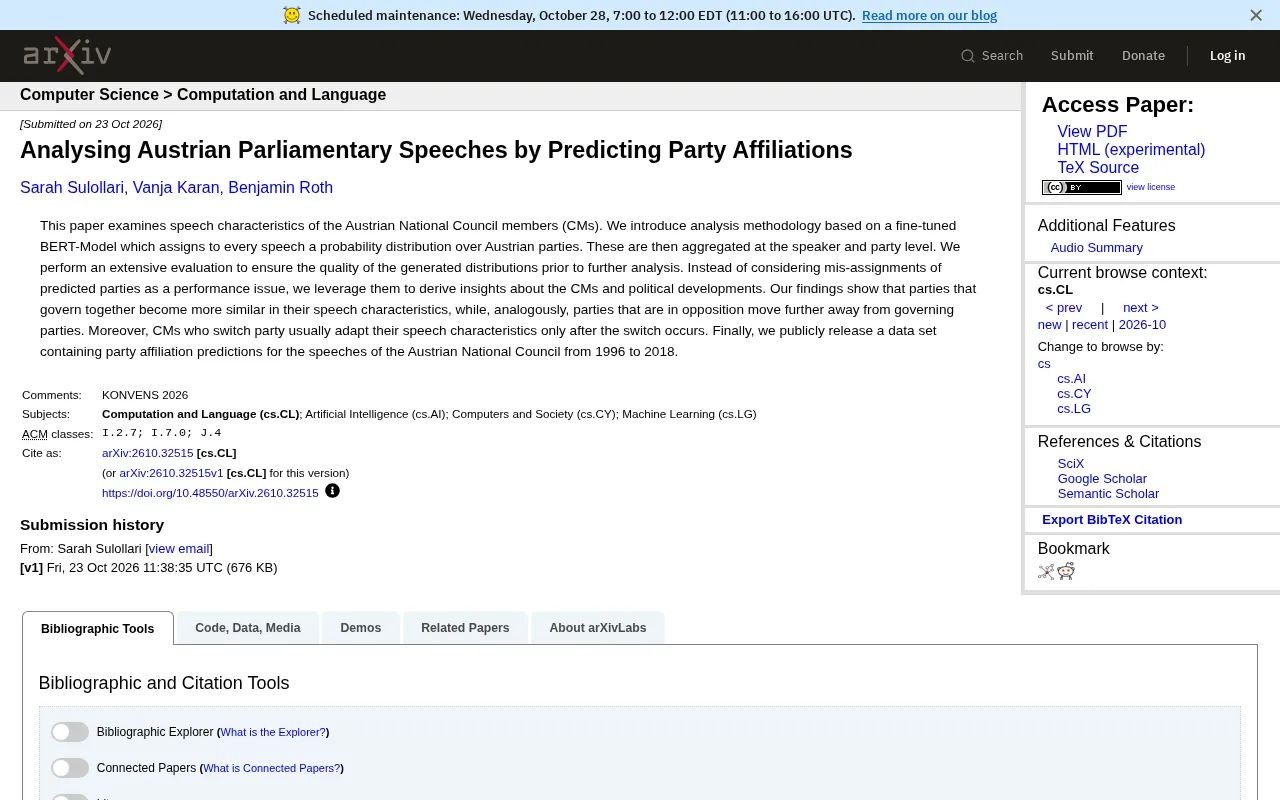
一篇arXiv论文提出基于微调BERT的方法,通过预测奥地利国民议会演讲者的政党归属,分析政党演讲风格的动态变化。模型为每篇演讲输出政党概率分布,并在演讲者和政党层面聚合,形成量化画像。研究将预测错误视为分析工具,发现执政联盟政党风格趋同、反对党与执政党分化、转党议员语言调整滞后等现象,并公开1996至2018年的预测数据集,展示了NLP在政治文本分析中的潜力。
当NLP遇见政治:用BERT解码奥地利议会演讲
政治演讲中隐藏着怎样的政党密码?一篇来自arXiv的论文提出了一种基于微调BERT模型的分析方法,通过预测奥地利国民议会成员的政党归属,揭示政党演讲风格的演变规律。这项研究不仅公开了1996至2018年的预测数据集,更将模型“误判”转化为洞察政治动态的线索。
方法论:从概率分布到政党画像
研究团队微调了一个BERT模型,使其能够为每篇演讲输出一个关于奥地利政党的概率分布。这些分布随后在演讲者和政党层面进行聚合,形成对个人和党派整体演讲特征的量化描述。
关键创新在于,研究者没有将预测错误视为单纯的性能问题,而是将其作为分析工具。模型对某篇演讲的“困惑”可能恰恰反映了演讲者与所属政党风格的偏离,或是政治立场变化的早期信号。
为确保分布质量,团队进行了广泛评估,验证了模型输出的可靠性,为后续分析奠定了坚实基础。
BERT(Bidirectional Encoder Representations from Transformers)是Google于2018年提出的预训练语言模型,其核心是Transformer编码器堆叠,通过掩码语言建模和下一句预测任务在大规模无标注文本上预训练,从而获得深层的双向上下文表示。在具体任务中,通常只需在预训练模型顶部添加轻量分类层,并用任务数据微调(fine-tuning)全部或部分参数,即可取得优异效果。本研究中,微调后的BERT对每篇演讲输出一个softmax概率分布,覆盖奥地利主要政党,该分布反映了模型对演讲政党归属的置信度。与硬分类不同,概率分布保留了不确定性信息,使得研究者能够量化演讲与各党风格的接近程度,为后续聚合分析提供更丰富的信号。
核心发现:执政联盟趋同,反对党渐行渐远
通过对聚合后的演讲特征进行分析,研究揭示了几个有趣的政治现象:
- 执政伙伴风格趋同:联合执政的政党在演讲特征上会逐渐相似,反映出共同治理下的语言融合。
- 反对党与执政党分化:与之相对,反对党与执政党的演讲风格差距会随时间扩大,凸显政治对立在语言层面的体现。
- 转党者的滞后适应:议员更换政党后,其演讲特征并不会立即改变,而是经历一个滞后调整期,说明个人语言习惯具有惯性。
这些发现基于对模型预测分布的深入挖掘,而非简单的分类准确率,体现了“错误也有信息量”的研究哲学。
在议会制国家中,执政联盟通常由两个或多个政党联合组成,共同承担政府责任。由于需要协调政策立场并对外展现团结,联盟伙伴在议会辩论中的修辞策略和议题框架会逐渐趋近,这种现象在政治学中被称为“联盟语言趋同”。相反,反对党无需承担治理责任,其核心策略是区分自身与执政党,通过强调意识形态差异来动员选民,因此语言风格会随时间与执政党拉开距离。本研究利用BERT概率分布的聚合特征,从数据驱动角度验证了这些理论预期,并首次在奥地利多党制语境下提供了量化证据。
公开数据集:助力政治文本分析
论文同时发布了涵盖1996至2018年奥地利国民议会演讲的政党归属预测数据集,为政治学、计算语言学等领域的研究者提供了宝贵资源。该数据集不仅包含预测结果,还可用于复现和扩展研究。
局限与展望
尽管方法有效,但研究也隐含一些局限:BERT模型对长文本的处理能力、奥地利多党制下的小党样本不平衡等问题可能影响预测精度。未来工作或可引入更多上下文信息,或结合其他语言模型提升鲁棒性。
总体而言,这项研究展示了NLP在政治分析中的潜力——不仅能分类,更能通过模型的不确定性揭示微妙的政治变迁。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。