BharatSynthQA:印度寺庙遗产问答数据集,LLM表现如何?

研究发布印度寺庙问答数据集BharatSynthQA,揭示LLM文化遗产知识短板。
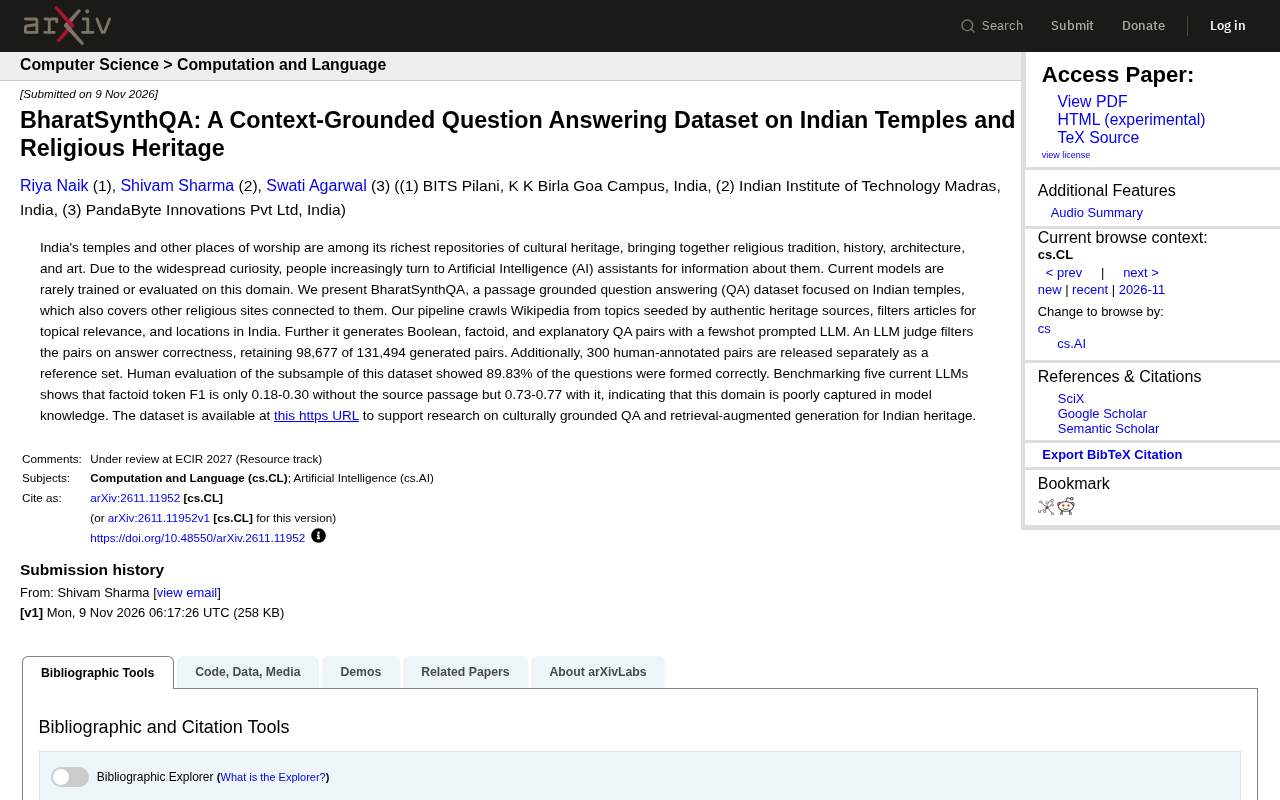
文章介绍研究论文提出的BharatSynthQA,这是首个聚焦印度寺庙及相关宗教场所的段落 grounded 问答数据集。其构建流程为:从权威遗产来源获取种子主题,爬取并过滤维基百科文章,再用少样本提示的大语言模型生成布尔型、事实型和解释型问答对,并通过LLM评审器过滤答案正确性,最终从131,494个生成对中保留98,677个,另发布300个人工标注参考对。人工评估显示89.83%的问题构造正确。对五个主流LLM的基准测试表明,无源段落时事实型token F1仅0.18-0.30,提供源段落后升至0.73-0.77,说明该领域知识在模型内部捕获不足,检索增强生成十分必要。数据集已在Hugging Face开源。
为什么需要专门的文化遗产问答数据集?
印度寺庙及其他宗教场所是该国文化遗产中最丰富的宝库之一,融合了宗教传统、历史、建筑与艺术。随着公众好奇心的增长,越来越多人转向AI助手获取相关信息。然而,当前模型很少在这一领域接受训练或评估。据研究论文《BharatSynthQA: A Context-Grounded Question Answering Dataset on Indian Temples and Religious Heritage》指出,现有模型对印度寺庙领域的知识掌握薄弱,亟需专门的数据集来推动相关研究和应用。
BharatSynthQA 数据集构建方法
研究团队提出了BharatSynthQA,一个基于段落的问答数据集,聚焦印度寺庙,并涵盖与之相关的其他宗教场所。其构建流程包括:从权威遗产来源获取种子主题,爬取维基百科文章,按主题相关性和印度地点进行过滤。随后,利用少样本提示的大语言模型生成布尔型、事实型和解释型问答对。通过LLM评审器对答案正确性进行过滤,最终从131,494个生成对中保留了98,677个。此外,还单独发布了300个人工标注的问答对作为参考集。
数据质量与人工评估
对数据集子样本的人工评估显示,89.83%的问题构造正确。这表明自动化生成加LLM过滤的流程能够产出较高质量的问答对,为后续研究提供了可靠基础。
少样本提示(few-shot prompting) 指在调用大语言模型时,于指令中先给出少量(通常几个)输入-输出示例,再给出待处理的新输入,使模型按示例的格式与风格完成生成。相比零样本提示,它无需更新模型参数即可显著提升输出格式的稳定性和任务遵循度,因此常被用于批量合成结构化数据。LLM 评审器(LLM-as-a-judge) 则是让另一个大模型依据给定标准对生成结果进行打分或判别,用以替代部分人工审核。两者结合可在低成本下实现规模化数据生产,但评审器本身的偏差与漏判仍需人工抽样校验,这也是该研究单独发布人工标注参考集并进行人工评估的原因。
布尔型、事实型与解释型 是三类难度递进的问答形式:布尔型问题答案为是/否,主要检验模型对陈述性知识的判别;事实型问题要求给出具体实体、年代、地点等短答案,可用 token F1 等指标量化;解释型问题则要求生成因果、背景或意义层面的连贯说明,通常需要人工或模型评判其完整性与准确性。按题型分层构建与评估,有助于区分模型是缺乏事实记忆,还是缺乏组织解释的能力,也使基准结果更具诊断价值。
当前LLM在该领域的表现
研究团队对五个当前主流LLM进行了基准测试,结果揭示了模型在文化遗产领域的知识短板。在事实型问题上,不提供源段落时,token F1得分仅在0.18-0.30之间;而提供源段落后,得分提升至0.73-0.77。这一显著差距表明,该领域知识在模型内部知识中捕获不足,检索增强生成(RAG)对于此类文化 grounded 的问答任务至关重要。
Token F1 是问答与阅读理解任务中常用的自动评估指标,按词元(token)级别计算预测答案与标准答案的重合程度:先统计二者的公共词元数,再据此计算精确率(预测答案中正确词元占比)和召回率(标准答案中被覆盖词元占比),最后取两者的调和平均。它对词序不敏感、对长度差异较宽容,适合答案为一小段文本的抽取式问答;但也可能给语义错误却词汇重合的答案打高分,因此常需与人工评估或语义相似度指标配合使用。文中 0.18-0.30 与 0.73-0.77 的对比,即是在同一指标下衡量模型有无源段落时的答案质量差异。
数据集开放与意义
BharatSynthQA数据集已在Hugging Face上公开(https://huggingface.co/datasets/theshivam7/bharatsynth-qa),以支持印度遗产相关的文化 grounded 问答和检索增强生成研究。该工作不仅填补了印度寺庙领域QA数据集的空白,也为评估和改进LLM在文化遗产方面的表现提供了基准。对于AI研究者、文化保护工作者以及开发者而言,这一资源有望推动更精准、更具文化敏感性的AI助手发展。
相关推荐
Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。
AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。