编码智能体的Harness设计:一项实证研究揭示了什么
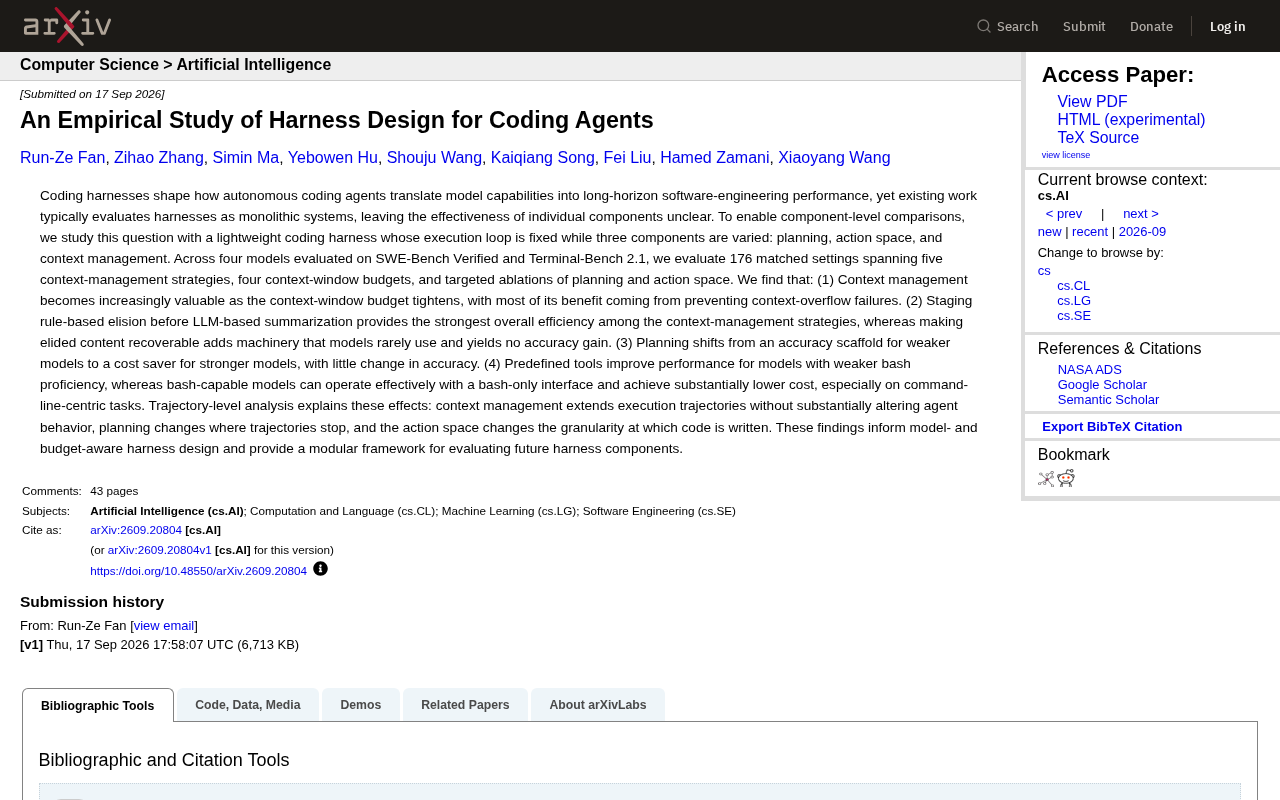
Harness(工程框架)与模型同等重要,是决定AI编码智能体真实表现的关键变量。
本文围绕一项关于编码智能体"Harness设计"的实证研究展开分析。Harness指包裹在大语言模型外围的工程框架,负责工具调用、上下文管理、错误反馈循环及多步规划等关键机制。研究揭示,同一模型配上不同的harness,在SWE-bench等真实编码基准上的成功率可能天差地别,说明智能体的能力是"模型×框架"的乘积而非单纯由模型决定。文章进一步指出,核心设计维度包括工具接口粒度、上下文压缩策略、反馈格式化质量以及规划与执行的分离方式。随着基础模型能力趋于同质化,harness层的工程差异将成为产品竞争力的真正分水岭,优化框架往往比更换模型拥有更高的投入产出比。
什么是编码智能体的 Harness 设计
当我们谈论 AI 编码智能体(Coding Agents)时,往往把注意力集中在底层大模型的能力上。但一项关于 Harness Design(脚手架/框架设计)的实证研究提醒我们:模型只是拼图的一块,围绕模型构建的"外壳"——即 harness——同样在很大程度上决定了智能体的实际表现。
Harness 指的是包裹在大语言模型外围的那一层工程结构,它负责如何组织提示词、如何管理上下文、如何调用工具(读文件、执行命令、编辑代码)、如何处理错误反馈,以及如何在多步任务中维持状态。同一个模型,配上不同的 harness,在真实编码任务上的成功率可能天差地别。
为什么 Harness 值得被单独研究
过去一年,SWE-bench 等基准测试让业界看到了智能体解决真实 GitHub issue 的潜力。但很多人忽略了一个事实:榜单上的分数不仅反映模型强弱,也反映了 harness 的工程质量。一个精心设计的框架,能让中等能力的模型跑出优异成绩;而糟糕的框架,则会浪费顶级模型的能力。
这项实证研究的价值就在于,它把 harness 作为独立变量来考察,试图回答一个被长期模糊化的问题:在智能体的最终表现中,究竟有多少来自模型本身,多少来自围绕它的工程设计。
核心设计维度
从 harness 设计的角度看,几个关键决策会反复出现:
- 工具接口的粒度:是给智能体提供一整套 shell 命令的自由度,还是封装成结构化的高层动作(如"编辑某文件的某行")。
- 上下文管理策略:如何在有限的上下文窗口内塞进最相关的代码片段,何时压缩、何时检索。
- 反馈循环设计:编译错误、测试失败、运行日志如何回传给模型,格式化的质量直接影响智能体能否自我纠错。
- 规划与执行的分离:是让模型一步到位,还是先规划再逐步执行。
这些看似是工程细节,实则是决定智能体成败的核心变量。
SWE-bench 是目前最广泛使用的编码智能体基准测试之一,由普林斯顿大学于2023年提出。它从真实的 GitHub 开源仓库中采集了数百个已关闭的 issue,要求智能体阅读问题描述后自动生成代码补丁,并通过仓库原有的测试套件来验证正确性。这一设计的核心价值在于"真实性":任务不是人工构造的编程题,而是开源社区中实际发生过的 Bug 修复与功能新增,涵盖 Django、Flask、Pytest 等主流项目。正因如此,SWE-bench 的分数被认为比 HumanEval 等传统代码生成基准更能反映智能体在生产环境中的实际能力。然而,不同参赛方提交的系统除了模型本身不同,其 harness 架构(如何检索相关文件、如何组织提示、如何处理测试反馈)也存在巨大差异,导致分数难以被直接归因于某一单一因素。
上下文窗口管理是 harness 设计中技术难度最高的环节之一。大型代码仓库动辄包含数十万行代码,而当前主流模型的上下文窗口即便达到 128K token,也远不足以容纳完整代码库。harness 通常需要结合多种检索策略来筛选相关代码片段:静态分析(如调用图、依赖关系)、基于向量嵌入的语义检索、以及 BM25 等关键词匹配。不同策略的召回质量直接决定模型能否"看到"修复 Bug 所需的上下文。此外,随着多轮对话推进,历史工具调用记录会迅速消耗 token 预算,harness 需要设计压缩或截断策略,在保留关键信息的同时控制成本——这本身就是一个需要权衡的工程决策,没有放之四海皆准的最优解。
实证研究能带来的启示
实证研究的意义在于用数据代替直觉。相比"某某框架感觉更好用"这样的经验之谈,系统性的对比实验能揭示哪些设计选择真正带来了提升,哪些只是锦上添花甚至适得其反。
对于开发者而言,这类研究的实用价值很直接:如果你在自建编码智能体,与其盲目追逐最新最强的模型,不如先审视自己的 harness 是否浪费了现有模型的能力。很多时候,优化工具反馈的格式、改进上下文的组织方式,比更换模型带来的收益更大、成本更低。
对行业的更广意义
这项研究呼应了一个正在形成的共识:智能体的能力是"模型 × 框架"的乘积,而非单纯由模型决定。随着基础模型能力趋于同质化,harness 层面的工程差异可能成为产品竞争力的分水岭。
对创业公司和开源项目来说,这意味着护城河未必在于能否用上最强模型,而在于能否把手头的模型"榨干"。谁把 harness 设计做到极致,谁就能在同等算力和模型条件下交付更可靠的编码智能体。
需要说明的是,本文基于 Hacker News 上流传的这项研究标题及讨论展开分析,原始素材信息有限,具体的实验数据与结论建议读者查阅原论文以获取完整细节。
"模型 × 框架"的乘积视角在学术界也逐渐获得重视。2024年前后涌现出多项研究,专门探讨 agent scaffolding(智能体脚手架)对最终性能的贡献比例。部分实验发现,在相同模型下,经过精心设计的 harness 可将 SWE-bench 解决率提升10至20个百分点,这一幅度甚至超过了从 GPT-3.5 升级到 GPT-4 所带来的增益。这一发现对资源有限的团队尤具现实意义:租用更强模型的 API 成本是持续性的,而一次性的 harness 优化投入则可以长期复用。当然,模型能力与框架设计之间也存在交互效应——某些 harness 策略只在模型具备足够强的指令跟随能力时才能发挥作用,因此两者并非完全可以互换,而是相互依赖的协同关系。
结论
Harness 设计正在从幕后走向台前。它提醒整个行业:AI 编码智能体的进步不只依赖更大的模型,也依赖更聪明的工程外壳。理解并优化这一层,或许是当下投入产出比最高的方向之一。
相关推荐
Robinhood高管将亮相TechCrunch Disrupt 2026谈现代金融消费者
Robinhood产品营销副总裁Abhishek Fatehpuria将亮相TechCrunch Disrupt 2026,分享如何赢得现代金融消费者。早鸟报名9月25日前最高省200美元。
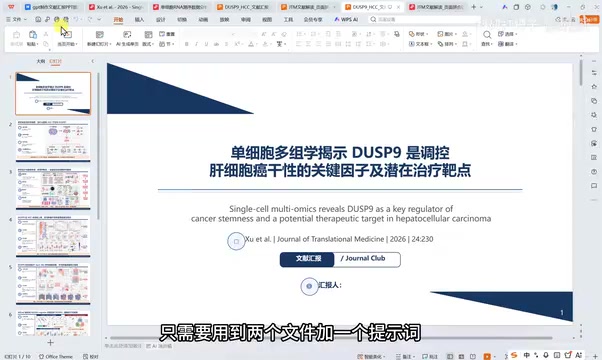
用ChatGPT批量生成可编辑学术PPT:科研人的效率工具实战
分享用ChatGPT批量生成可编辑学术PPT的完整流程:只需文献PDF、PPT模板和一段提示词,先出图再拼合转可编辑,半小时完成美观汇报PPT,并对比了ChatGPT与Codex的适用场景。
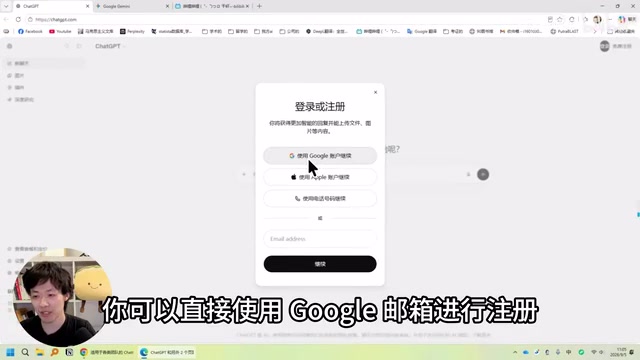
GPT-6满血版使用教程:通过GPT-work开启Ultra最高思考强度
本文详解如何付费使用GPT-6满血版:从Apple ID注册、Plus/Pro套餐充值,到通过GPT-work客户端工作模式开启GPT-6 Ultra最高思考强度与完整权限,并附网页版隐藏解锁路径。