别再盲目信任AI服务商:两种可验证的方案

Engy与SayGM分别用密码学证明和硬件TEE解决托管大模型的模型真实性与隐私两大信任问题。
调用托管大模型存在两个难以核查的信任盲区:服务商可能悄悄替换模型,且用户无法技术性约束prompt的流向。文章介绍了基于Bittensor的两个子网各自的应对方案。Engy(SN53)通过Merkle root固定开源模型权重,并为每次响应附带TOPLOC激活指纹证明,由验证节点抽样比对,无需可信硬件即可在消费级GPU上提供可验证推理。SayGM(SN28)则将网关部署在Intel TDX可信执行环境内,TLS在飞地内终结,运营方自身也无法读取请求内容,并提供远程证明端点作为硬件签名的可查证据。两者互补——前者证明「运行了什么模型」,后者限制「谁能看到请求」——但均未彻底消除信任,只是将其转移到密码学证明或硬件背书等可部分核查的机制上。
调用托管大模型时,你其实在无条件信任两件无法亲自核查的事情。
第一,账单上写的模型,未必就是真正回答你的那个模型。服务商完全可以在同一个名称下偷偷换成更小的量化版本或更廉价的蒸馏模型,你根本看不出来。你的 Agent 表现悄悄变差,结果你却去怪自己的提示词。
第二,你的 prompt 到底流向了哪里。大多数网关给你的只是一份隐私政策——而政策是企业说自己会怎么做的承诺,不是对它实际能做什么的技术约束。
对于那些把越来越多任务交给个人 AI Agent 的人来说,这两个问题的代价会随着信任的深入而放大。两个基于 Bittensor 的子网各自瞄准其中一个问题:Engy(SN53)和 SayGM(SN28)。它们解决的问题不同,下面拆解各自的思路与适用场景。
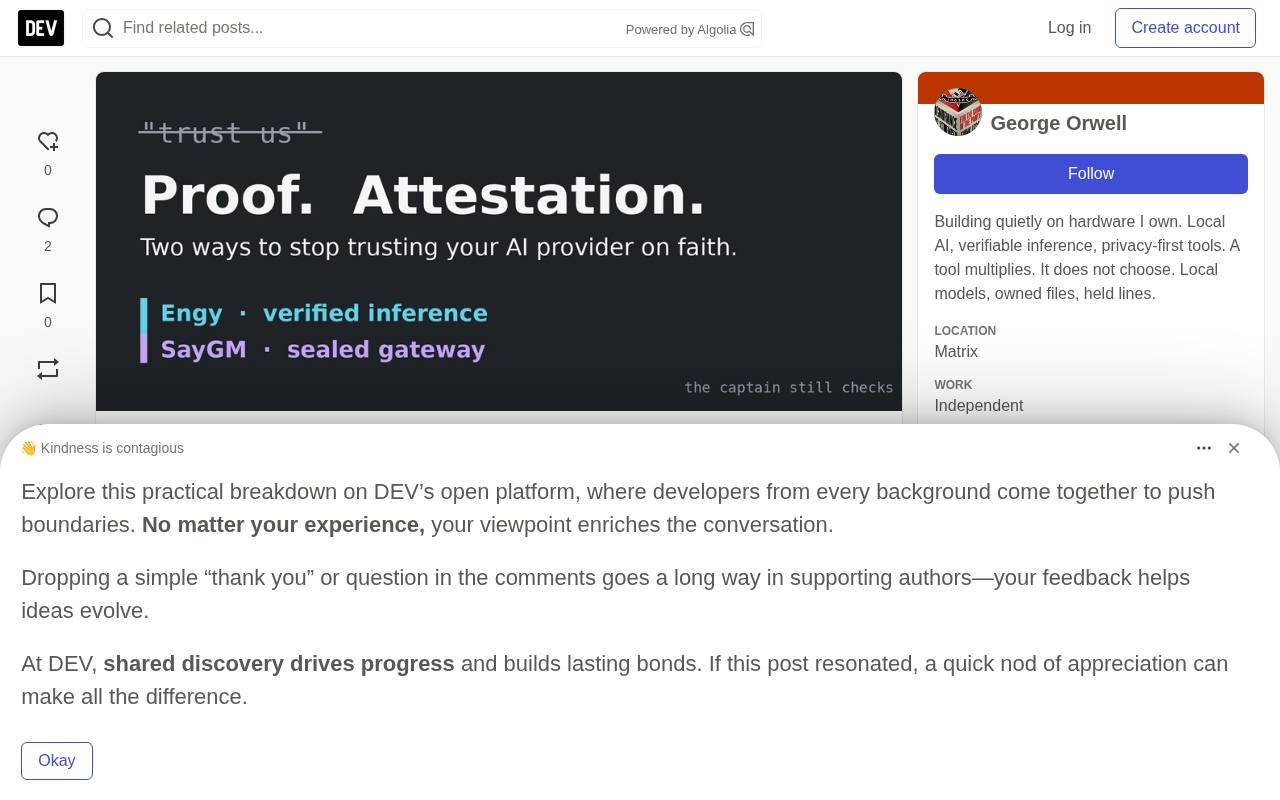
Engy:证明你付费的模型就是实际运行的模型
Engy 是一个兼容 OpenAI 接口的推理 API,服务 GLM、Kimi、DeepSeek广告、Qwen 等前沿开源权重模型。它的核心价值在于「验证」。
按照项目说明,每个模型的权重和量化方式都通过一个公开的 Merkle root 被固定下来。每一次响应都会携带一个 TOPLOC proof——这是对模型内部激活值的一种紧凑指纹。验证节点会抽样重新计算这些证明,并与固定的 checkpoint 比对,未通过验证的矿工会被扣分。
项目 README 里的表述很直接:「不需要 TEE,不需要可信硬件。证明锁定的是数学运算,而不是机器本身。」正是这一点,让它可以在一个无需许可的算力集群(包括消费级 GPU)上提供服务,而不必要求你去信任拥有 GPU 的人是谁。
此外,Engy 声称所有账户默认采用零数据留存策略。
Merkle root 是一种来自密码学数据结构「Merkle 树」的概念。Merkle 树把一大批数据块逐层两两哈希,最终汇聚成一个固定长度的根哈希值(即 Merkle root)。只要任何一个数据块被改动,根哈希就会完全不同,且无法伪造。用它来「固定」模型权重,意味着将模型的全部参数文件计算成一个公开可查的指纹——如果运行的是不同版本,指纹对不上,篡改就无处遁形。
TOPLOC proof 则是一种针对大模型推理设计的轻量级完整性证明技术。其核心思路是:在前向传播过程中,对模型若干层的内部激活值(intermediate activations)计算一个紧凑的承诺值(commitment)。由于特定输入在特定模型上产生的激活值是确定性的,验证方只需重算同一批 token 的局部激活,就能判断服务商跑的是不是声称的那个模型,而无需重演整次完整推理。这比传统的「结果比对」更难欺骗——因为换一个更小的模型产出相似输出并不难,但伪造中间层的激活指纹则困难得多。
SayGM:连运营方自己都看不到内容的网关
SayGM 是一个可直接替换的网关,支持 Claude、GPT、Gemini 以及一批开源模型。它同时暴露 OpenAI 兼容、Anthropic 原生和 Gemini 原生三种 API,因此现有代码大多只需换一个 base URL 和 key 即可接入。
关键在于它的运行环境:网关跑在 Intel TDX 可信执行环境(TEE)内部。TLS 在飞地(enclave)内终结,意味着路由和护栏逻辑发生在 SayGM 自己的运营方和宿主机都无法读取请求的地方。网关还提供一个远程证明(remote attestation)端点,让这个主张附带硬件签名的证据,而不只是一页政策文档。
有两个层级值得了解:
- 前沿模型(Claude、GPT、Gemini):请求通过网关密封传输,之后由模型提供方按其自身 API 条款处理——这和你直接调用它们没有区别。
- 机密模型(带
-tee后缀,如kimi-k3-tee):开源权重模型同样在 TEE 内运行,因此 prompt 从头到尾保持密封。
在价格上,费率通过机器可读的模型目录实时公布,且上限不超过模型厂商的标价。SayGM 自己的 OpenRouter 对比页面显示,在它比较的九个模型中,在计入 OpenRouter 5.5% 的充值手续费后,平均节省约 29%。作者明确标注这是 SayGM 的对比数据而非自己实测,具体因模型而异,且目录中部分模型价格会高于 OpenRouter。
可信执行环境(TEE,Trusted Execution Environment) 是 CPU 厂商在硬件层面划出的一块隔离区域,称为「飞地(enclave)」。飞地内的代码和数据在运行期间对操作系统、虚拟机监控器乃至服务器物理所有者都不可见,即便拥有 root 权限也无法读取其内存。Intel TDX(Trust Domain Extensions)是英特尔面向云场景推出的新一代机密计算技术,粒度是整个虚拟机,比早期的 SGX 更适合运行完整的应用程序栈。
远程证明(Remote Attestation) 是 TEE 体系的配套机制:飞地可以向外部请求方提供一份由 CPU 硬件私钥签名的报告,证明「当前确实在某型号芯片的 TEE 内运行,且运行的代码哈希值为 X」。这份报告可通过 Intel 的证书链进行验证,从而把「相信服务商的承诺」替换为「验证硬件签名的密码学证据」。TLS 在飞地内终结,意味着 HTTPS 的解密也发生在这块不可见的隔离区域内,网关运营方所在的宿主机层面拿到的只有密文。
什么场景下用哪一个
两者并不竞争:一个证明「运行了什么」,另一个限制「谁能看到请求」。作者给出的实用判断如下:
- 想精确知道是哪个开源模型回答的,例如做评测、长时间 Agent 运行,或任何「悄悄换模型」会毁掉结果的场景——选 Engy。
- 需要 Claude、GPT 或 Gemini,但希望路由层被密封——选 SayGM。
- 想用开源模型且要最强的隐私保障——选 SayGM 的
-tee模型。 - 想要便宜、可验证的开源模型 token 做后台 Agent 工作——选 Engy。
最小接入代码
两者都能用标准的 OpenAI Python SDK,只需改 base_url、key 和模型名。
Engy:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.engy.ai/v1",
    api_key=os.environ["ENGY_API_KEY"],
)

resp = client.chat.completions.create(
    model="glm-5.2",
    messages=[{"role": "user", "content": "hello"}],
)
print(resp.choices[0].message.content)
SayGM:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.saygm.com/v1",
    api_key=os.environ["GM_API_KEY"],
)

resp = client.chat.completions.create(
    model="kimi-k3-tee",  # 机密层:端到端 TEE
    messages=[{"role": "user", "content": "hello"}],
)
print(resp.choices[0].message.content)
需要注意,在 SayGM 上模型 ID 没有提供商前缀。Claude 模型走 Anthropic 原生的 /v1/messages 端点,因此调用它们要用 Anthropic SDK。GET /v1/models 会告诉你每个模型的层级以及支持哪些 API 形态。
局限与权衡:没有一个真正消除信任
必须清醒认识到:这两种方案都没有「消除」信任,它们只是把信任转移到你(至少部分地)可以核查的地方。
Engy 的局限:
- 验证是抽样和概率性的,项目方直接承认这一点——它不是对每一次前向传播的完整证明。更强的重算审计仍在指纹校验之上逐步推出。
- 作为买家,你并不会在每次调用时自己验证证明。在当前稳定化阶段,由 Engy 运行 GPU 支撑的主验证节点来做检查。
- 它只支持开源权重模型。如果你需要 Claude 或 GPT,这个工具不适用。
- 验证只能证明「哪个模型运行了」,它不是隐私保障。隐私方面你依赖的仍是它的零留存政策。
SayGM 的局限:
- 对前沿模型,提供方(Anthropic、OpenAI、Google)仍以明文看到你的 prompt。SayGM 对此坦诚——密封覆盖的是网关,而非模型提供方。
- 文档称更底层的证明验证接口仍在为一般买家使用做准备。你现在可以获取 attestation,但要自己核验需要一些 TDX 的专业知识。
- 目录是精选的(数十个模型,而非数百个)。如果你需要冷门模型,更大的聚合器仍有用武之地。
- TEE 把信任转移到了硬件厂商。这比一页政策文档好得多,但它仍然是一种信任。
结语:可以核查的「收据」
两者都不完美,但它们都把「相信我们」换成了你能检查的东西:一个绑定公开权重的证明,或一份由芯片签名的证明。正如作者所说,一个无法展示其运算过程的模型,不过是「配了键盘的传言」。对于无人值守、还要处理个人数据的 Agent 来说,拿到可核查的「收据」才是关键——信任可以给,但船长总要亲自检查。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。