别再手写提示词:AI Agent 的图工程工作流拆解

Graph Engineering实为控制图编排,两条实现路径与设计要点解析。
文章澄清了Graph Engineering讨论中混杂的控制图、知识图谱和循环之图三个概念,指出真正焦点是控制图/SOP编排。随着Agent使用从人工提示转向系统触发,循环和编排者模式成为趋势,可靠性变得关键。控制图的核心构件节点、边、状态中,节点的内涵已从简单动作演变为独立Agent。实现路径有代码即图(如LangGraph)和模型即图(SOP提示词化)两种,后者需注意拆分Agent节点、代码优先、定义输入输出schema和设计状态载体。实战案例展示了日度坏设计分诊和变更发布工作流,强调为Agent配备可测试工具是循环奏效的关键。
过去几周,"Graph Engineering"这个词在开发者社区里被反复提及,但讨论越热闹,概念反而越模糊。据B站UP主在视频中的梳理,问题的根源在于人们把三种完全不同的"图"混在同一个话题里:控制图、知识图谱,以及"循环之图"(Graph of Loops)。这位创作者认为,Peter那条引发讨论的推文真正指向的是控制图——即用SOP式的流程编排让Agent输出更可靠的结果。至于知识图谱,它属于实体关系建模与检索优化的范畴,与Agent工作流是两条平行线;而"循环之图"则是更前沿、尚未有标准答案的开放问题。
从"人提示Agent"到"系统提示Agent"
真正推动控制图需求的,是Agent使用方式的一次结构性转变:团队正在从人手动给Agent写提示词,转向由某种机制代替人去触发Agent。创作者总结了两种正在被头部AI原生公司试验的模式。
第一种是循环(Loop)。触发源可以是时间(每天拉取最新的GitHub issue并修复)、目标(持续优化前端直到性能达到设定目标)或事件(每封新邮件唤醒Agent)。循环设计中最关键的决策,是划清"Agent可以自主做什么"和"必须由人介入什么"的边界。
第二种是编排者(Orchestrator)模式。用户不再直接与执行Agent对话,而是与一个掌握全局上下文的编排者对话,由它拉起一组Agent执行任务并全程监控。视频中引用了Claude Code创建者Boris的说法:他现在主要与一个能与其他Agent对话的Agent交流,而非亲手提示每一个执行单元——"我的Agent在与其他Agent对话"。这意味着人始终被抬升到实际工作之上的一层,不再逐步骤盯守。
代价是可靠性变得空前重要。你不再检查每个执行步骤,就必须有足够的信心相信Agent交付的东西是对的。
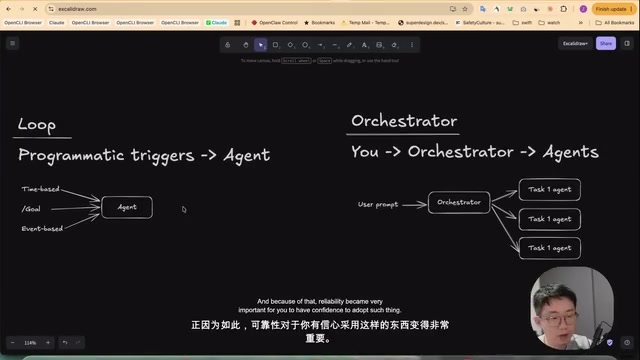
循环(Loop) 是Agent工程中一种让系统自主触发Agent运行的模式,区别于传统由人手动输入提示词的一次性调用。其触发源通常有三类:时间驱动(如定时任务)、目标驱动(持续迭代直至满足指标)和事件驱动(如新邮件、新issue)。循环设计的核心挑战在于划定Agent自主决策与人工介入的边界,这直接决定了系统的可靠性与可控性。在循环中,Agent往往需要具备自我评估或外部验证能力,以判断是否达成目标或需要继续迭代,否则容易陷入无效重复或偏离目标。
控制图的三个基本部件,以及"节点"的含义之变
控制图并非新概念,基于图的流程自动化已存在数十年,核心构件始终是三个:节点(执行的动作)、边(这一步之后走向哪里)、状态(在节点之间流转的数据)。
真正的变化发生在"节点"的内涵上。传统工作流里,一个节点就是一个简单动作,比如跑个脚本、做一次条件判断;几年前低代码平台把大模型引入为节点,从而能处理更多长尾场景;而今天,一个节点本身就可以是一个能力极强的Agent。
创作者用几个熟悉的例子说明"图"其实早就在我们身边。Claude Code或Codex的目标(goal)功能本质上就是一张图:接收用户提示,进入Agent循环,结束后由模型判断目标是否达成,未达成则把新消息送回Agent,依靠的是Agent循环加上停止钩子系统。Andrej Karpathy的自动研究项目同样是图——prompt写在program.md中,指示Agent用实验想法修改train.py、跑实验、评估指标,变好就保留改动,变差就回滚再试下一个想法,状态就是train.py和记录所有尝试的results.tsv。有意思的是,这个图完全靠提示词实现,没有花哨机制,甚至当时还没有loop或goal功能,只是告诉Agent"永远重复这个过程"。
深度研究类Agent也是同一模式:接收提示、由编排者规划主题、分发子Agent并行研究、检查信息是否足够、不足则回到上一步、足够则生成报告。
LangGraph 是一个用于构建有状态、多步骤Agent工作流的开源框架,它将流程建模为图结构,其中节点代表计算步骤(如调用模型、执行工具),边定义控制流(包括条件分支和循环)。LangGraph的核心优势在于显式管理状态(state)和提供确定性控制,适合需要复杂编排和持久化的场景。与传统的低代码工作流不同,LangGraph允许开发者用代码精细定义每个节点的逻辑和状态转移,从而在保持灵活性的同时提升可靠性。它常被用于实现多Agent协作、规划-执行循环等模式,是“代码即图”路线的典型代表。
两条实现路径:代码即图,与模型即图
看完这些例子可以得出一个结论:图的落地方式并不唯一。
一条路是代码即图,用传统编程或专门框架(如LangGraph,或Claude Code的动态工作流、Codex的code模式)来构建和控制流程,控制力强、确定性高。
另一条路是模型即图,把SOP写进提示词——文本、JSON或Mermaid图都行——现代模型完全有能力理解并遵循这类流程描述,把它做成Agent可以调用的技能(skill)即可。很多开发者其实已经在这么做了。
现代Agent运行环境还提供了大量原语来支撑这种做法:能跑bash意味着可以执行预定义脚本处理确定性步骤;子Agent与Agent团队通信协议让主Agent能拆解SOP并派活;钩子(hooks)可以在运行时注入真正的确定性检查点,goal功能的实现就是典型范例。
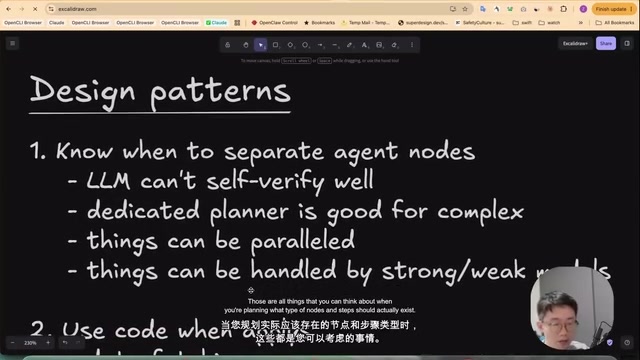
用模型即图时,值得注意的四个设计要点
创作者结合团队实践给出了几点经验。其一,知道何时拆分出独立的Agent节点。 再强的模型也不擅长自我验证,所以验证器通常要单独成为一个节点;依据OpenAI与Anthropic的研究,复杂任务中一个专注研究、推理与思考的规划者Agent往往是必要的。同时要识别哪些步骤可以并行、哪些可以交给更强或更弱的模型。
其二,能用代码的地方就用代码。 复杂数据获取、启动开发服务器、结果评估与端到端测试,这类高频且确定的工作交给脚本,能明显提升可靠性、加快速度、减少无谓错误。
其三,为每个Agent节点定义清晰的输入与输出。 输出最好有schema约束,边界清楚了,流程才稳定。
其四,设计好状态。 无论走哪条路,都需要一个让不同Agent快速了解当前进展的载体。最简单的方式是一个Markdown文档记录最新状态,再配一份每个Agent或每轮追加的日志。
模型即图 是一种将标准操作流程(SOP)直接编码为自然语言提示词、JSON或Mermaid图,并依赖现代大模型的理解与遵循能力来驱动Agent执行的方法。其核心思想是:模型本身具备解析流程描述、按步骤行动的能力,因此无需外部框架强制控制流,只需将流程作为上下文提供给Agent即可。这种做法降低了工程复杂度,便于快速迭代,尤其适合流程相对简单或探索性强的任务。然而,其可靠性依赖于模型的指令遵循能力,且难以保证确定性,因此常需配合钩子(hooks)或脚本注入检查点来增强稳健性。
输出schema 是指对Agent节点输出结果的结构化约束,通常以JSON Schema等形式定义,明确字段名称、类型和必填项。在模型即图的流程中,为每个Agent节点设定输出schema能强制模型生成符合预期格式的内容,减少解析错误和歧义,同时便于下游节点或脚本可靠地消费数据。schema约束还有助于验证Agent是否完成了指定任务,例如检查必填字段是否缺失。结合验证器节点,schema可以作为自动化质量检查的基础,从而在缺乏人工逐步监督的情况下仍保持流程的稳定性。
实战案例:日度坏设计分诊与变更发布
创作者团队做了一个vibe design平台Super Design,并单独维护了一个状态跟踪与知识库仓库。日常改动代码时,他们多数时候在这个仓库里启动Agent,而不是直接进业务仓库——因为这里沉淀了每一次实例、每一张支持工单、每一个发布的工程单。
其中"每日坏设计分诊"是一个典型的模型即图例子。目标很明确:每天有大量用户在设计,需要把Agent生成的糟糕设计或用户投诉沉淀下来,形成可用于改进模型的评测数据集。流程是:每天先依据启发式指标从数据库拉出可能的坏设计候选;如果没有则结束;有则先用脚本做程序化检查(报错、排版全乱、不响应等),这些直接入列;其余的设计则由一组子Agent分批处理,截图、对照用户真实请求、判断结果是否达标;最后主Agent对当天的坏设计排序并发布成报告。这个图靠一个skill加上若干脚本实现:skill里写明流程和该调用哪个脚本,给判断型Agent规定输出schema,再为整个循环定义输出契约和护栏。
另一个例子走代码即图路线。动态工作流允许Agent直接写JavaScript,调用agent、pipeline(带依赖关系的串行阶段)和parallel(并行分发)等原语,拼出任意形状的图。团队的"变更发布"工作流分三个阶段:搭建与实现、验证、以及在验证通过后简化并提交PR。代码里为每类Agent定义schema,一个Agent会话结束时按schema输出结果,下一步就能基于上一步的关键信息构造提示词——比如先出大纲、再依大纲写正文。
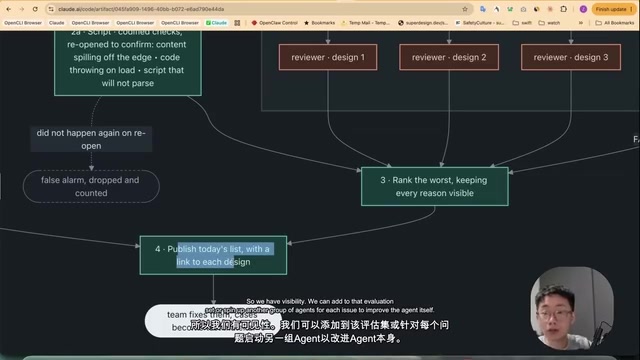
需要强调的是,把任务拆成图并不能自动奏效,你必须给Agent配备能真正测试的工具。 创作者认为这是多数人最容易漏掉、也最常导致循环失效的一步。团队公开的仓库里提供了一套验证器搭建skill可供参考。
选哪种方法?
两条路输出形态不同,但都有效。模型即图的产出可以是被每轮循环或临时唤醒的skill,代码即图的产出是可直接运行的JavaScript。创作者个人在多数场景下偏向模型即图,原因是当前的动态工作流或code模式下每开一个Agent会话都无法续接上一轮对话,体验上略麻烦;但如果任务体量极大,代码即图会更有优势。
至于多个循环并存时误差与改进如何复合放大,那是另一个尚未被解答的问题——也是他计划在下一期讨论的"循环之图"。
相关推荐

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。
Mistral Large 4开放权重,AI早报盘点模型与生态新动向
Mistral Large 4开放权重,1万亿参数MoE架构支持MacStudio本地运行;Meta测试生成技术进入生产环境;税务基准测试头名通过率仅10.8%;加拿大政府入股Cohere;豆包工作开放第三方模型调用。本期AI早报盘点模型、生态、资本与政策动向。
Mistral Large 4开源:1T参数欧洲版千问挑战DeepSeek
Mistral Large 4正式开源,1T总参数、52B激活参数,主打编程与网络安全,NVFP4量化版本权重约610G。本文解析其与DeepSeek V4 Flash的对比、API定价、Demo真实性与本地部署价值。