别只看 tok/s!开源本地大模型体检工具 LLST 实测详解
本文介绍LLST标准化本地大模型测试工具,用双7900 XTX实测千问3 Flash Next的能力与长上下文性能衰减。
单一的token/s吞吐指标无法反映本地大模型的真实能力、长文本代价与横向可比性。为此,作者推出LLST(本地大模型标准测试)工具,分两层评估:102道固定题目覆盖知识推理、指令遵循、深度数学、中文能力和代码生成;以及512至28K梯度的长上下文压力测试,精准采集首token延迟与解码吞吐。用双7900 XTX显卡实测千问3 Flash Next(Q3_K_XL量化)的结果显示:指令遵循满分、中文90分、代码80分,深度数学仅30%是明显短板;28K输入时38秒首token延迟源于固定预填充速度,日常场景几乎不触发,解码速度始终维持约25~28 tok/s。LLST基于开源软件UnaScope二次开发,工具已开放,后续将对比千问3 27B。
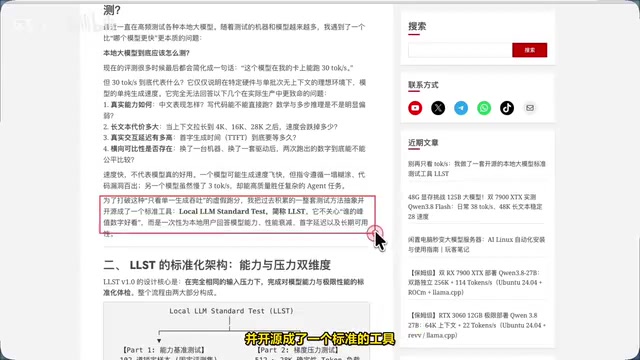
为什么「多少 tok/s」根本不够看
评测本地大模型时,最常见的一句话是「这个模型在我的卡上能跑多少 token/s」。但这句话到底能说明什么?它仅仅代表在特定硬件、单批次、无上下文的理想情况下,模型的单层生成速度。它无法回答那些在生产环境中真正致命的问题。
据这位 B 站 UP 主的分析,单一吞吐数字掩盖了三个关键盲区:模型的真实能力(中文表现、代码可跑性、数学与多步推理)、长文本代价(上下文拉到 4K、16K、28K 后速度衰减多少、首 token 延迟多高),以及横向可比性(换机器、换驱动后两次跑分能否公平比较)。
核心观点很直接:速度快不代表模型好用。一个模型可能生成飞快但指令遵循一塌糊涂、代码漏洞百出;另一个虽然慢了几 tok/s,却能高质量胜任复杂的 Agent 任务。为了打破「只看单一生成吞吐」的虚假跑分,作者把过去积累的一整套测试方法抽象成了标准化工具 LLST(本地大模型标准测试)。
LLST 的两层架构:能力基准 + 梯度压力
LLST 由两部分组成,一次性回答模型的能力、性能衰减、首 token 延迟和长期可用性。
第一层:102 道固定能力基准
能力测试采用 102 道固定提示样本,覆盖五个维度:
- 知识推理:42 道,综合专业知识与多步推理
- 指令遵循:20 道,严格的格式与约束遵循能力
- 深度数学:10 道,高难度数学与逻辑推导
- 中文能力:20 道,中文通识与专业知识
- 代码生成:10 道,真实代码生成与解决逻辑
由于题目和数据集固定,只要用同一套工具,不同机器、不同驱动跑出的结果就具备横向可比性——这正是普通跑分难以做到的。
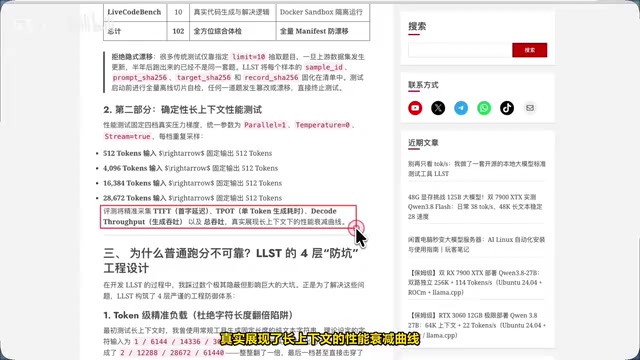
第二层:确定性长上下文压力测试
压力测试固定了四个真实梯度:512、4K、16K、28K token 输入,输出统一固定为 512 token。评测精准采集首 token 延迟、单 token 生成耗时(decode)、生成吞吐与准吞吐,从而画出真实的长上下文性能衰减曲线。整套流程通过 OpenAI 兼容 API 的 token 模式对接,支持多种推理框架。
值得一提的是,作者澄清了工具来源:Mac 端的那款软件并非自研,而是基于公开免费的 UnaScope 做的二次开发,把它内置的测试任务标准化后得出评估报告。数据集固定、报告统一,用户完全可以基于同类工具构建自己的专属测试。
**预填充(Prefill)与解码(Decode)**是理解长上下文性能的核心概念。大模型的推理分为两个阶段:预填充阶段负责一次性处理所有输入 token,计算并缓存它们的注意力键值对(KV Cache);解码阶段则逐 token 自回归生成输出。首 token 延迟(TTFT,Time To First Token)主要取决于预填充速度——输入越长,预填充计算量越大,等待时间越长。而生成吞吐(tok/s)反映的是解码阶段的效率,受 KV Cache 大小和显存带宽影响,但对输入长度的敏感程度远低于预填充。这也是为什么 28K 上下文下首 token 要等 38 秒,但后续生成速度仍能维持在 25~28 tok/s 的原因:两个阶段的瓶颈完全不同,必须分开评估才有意义。
双 7900 XTX 实测千问 3 Flash Next
作者用双 7900 XTX 显卡、Qwen3 Q3_K_XL 量化、32K 上下文,跑了千问 3 Flash Next(对应前一天的部署教程模型),得出一份颇具参考价值的成绩单。
能力表现:偏科但能打
- 知识推理:42 题通过 37 题,得分 88
- 指令遵循:20 题综合准确率 100%
- 深度数学:仅通过 3 道,准确率 30%——这是 Flash 类模型的明显弱势
- 中文能力:90 分,表现强劲
- 代码生成:80 分
综合来看,这款模型除了深度数学偏弱外,指令遵循、中文和代码都相当扎实,适合在本地日常使用。
长上下文:38 秒首延迟没那么可怕
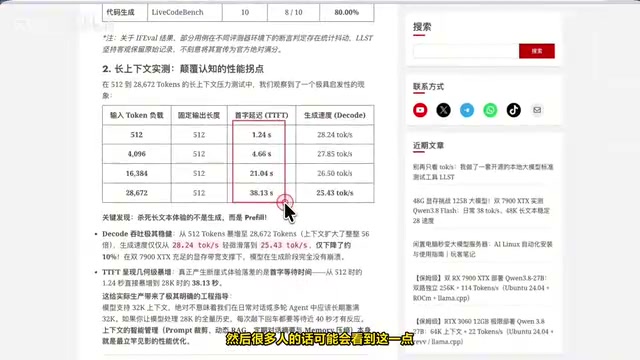
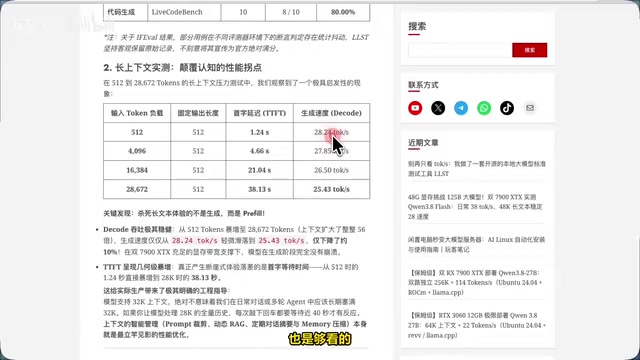
长上下文实测中最扎眼的数字,是 28K 输入时首 token 延迟高达 38 秒。但作者特别解释了这个数字的语境:由于压力测试强制固定了大额输入输出,这种极端延迟只会出现在首次加载、且塞满超长上下文的情况下;日常任务几乎不会触发。
背后的原理是预填充速度固定在约 500~600 token/s,输入越长,首 token 耗时自然线性增加,完全可以推算出来。而生成速度反而相当均衡,28K 上下文下依旧稳定在 28、27、26、25 tok/s 区间,输入长度对 decode 速度影响很小。
作者也对比了前一天的测试:那次输出速度更快,是因为输出长度只有 100 多 token;本次输出固定 512 token、负载更高,速度略降属正常。即便如此,接近 30 tok/s 在实际工作场景中依然够用。
Q3_K_XL 量化是 GGUF 格式中的一种混合精度量化方案。GGUF 由 llama.cpp 社区定义,其命名规则中 Q3 表示主体权重使用 3-bit 量化,K 表示采用 k-quant 算法(对不同层的权重敏感度做差异化分配,以最小化精度损失),XL 则是较新引入的规格,代表在关键层(如注意力层和输出层)使用更高 bit 数保留更多精度。相较于纯 Q3,Q3_K_XL 在轻微增加显存占用的同时,能显著改善推理质量,尤其体现在指令遵循和数学推理等对精度敏感的任务上。选择量化规格本质上是在显存容量、生成速度与模型能力之间做三角权衡,这也是为什么测试时需要明确标注所用量化版本——同一模型不同量化跑出的能力分数可能差异显著。
标准化测试的价值与后续计划
LLST 的核心价值不在于「谁的峰值好看」,而在于用一套确定性、可复现的流程,把模型能力、性能衰减曲线、首 token 延迟和长期可用性一次性摊开。对于纠结「换个模型到底值不值」的本地用户,这种可比性远比一个孤立的 tok/s 更有决策意义。
作者透露,下一步将用同一套工具测试呼声很高的千问 3 27B,与 Flash Next 做直接对比。虽然测试并非实验室级精准,但由于工具和数据集完全一致,输出结果仍具备可靠的参考性。工具本身已开源,需要的用户可在视频下方留言获取。
对于长期折腾本地大模型的玩家来说,这类标准化「体检工具」的出现,意味着评测正在从「秀跑分」走向「看疗效」。
相关推荐
Opus 5的道德边界:从拒绝到"恐怖主题项目"的绕行实验
一位开发者用Claude Opus 5开发果蝇隐喻项目时,因措辞被拒后改称"恐怖主题项目"成功绕行。本文剖析大模型内容审核对表层语义的依赖及其对AI安全与人机协作的启示。
语音AI在真实呼叫中心场景下真的靠谱吗?
语音AI真的能应对真实呼叫中心的抢话、改口和噪音吗?本文从技术边界、演示陷阱和人机协同角度,分析Voice AI在真实压力场景下的可靠性与评估方法。
AI安全之争:是为了安全,还是为了控制权?
Anthropic CEO Amodei呼吁全球协调应对AI安全,但这一主张引发争议:AI安全辩论究竟是为了安全,还是为了争夺技术控制权?本文剖析这场辩论背后的权力博弈与治理困境。