并行采样的轮数复杂度分离:混合前后的KL散度之差

并行采样中,改变KL散度的计算顺序可使所需轮数从对数平方骤降至双对数量级。
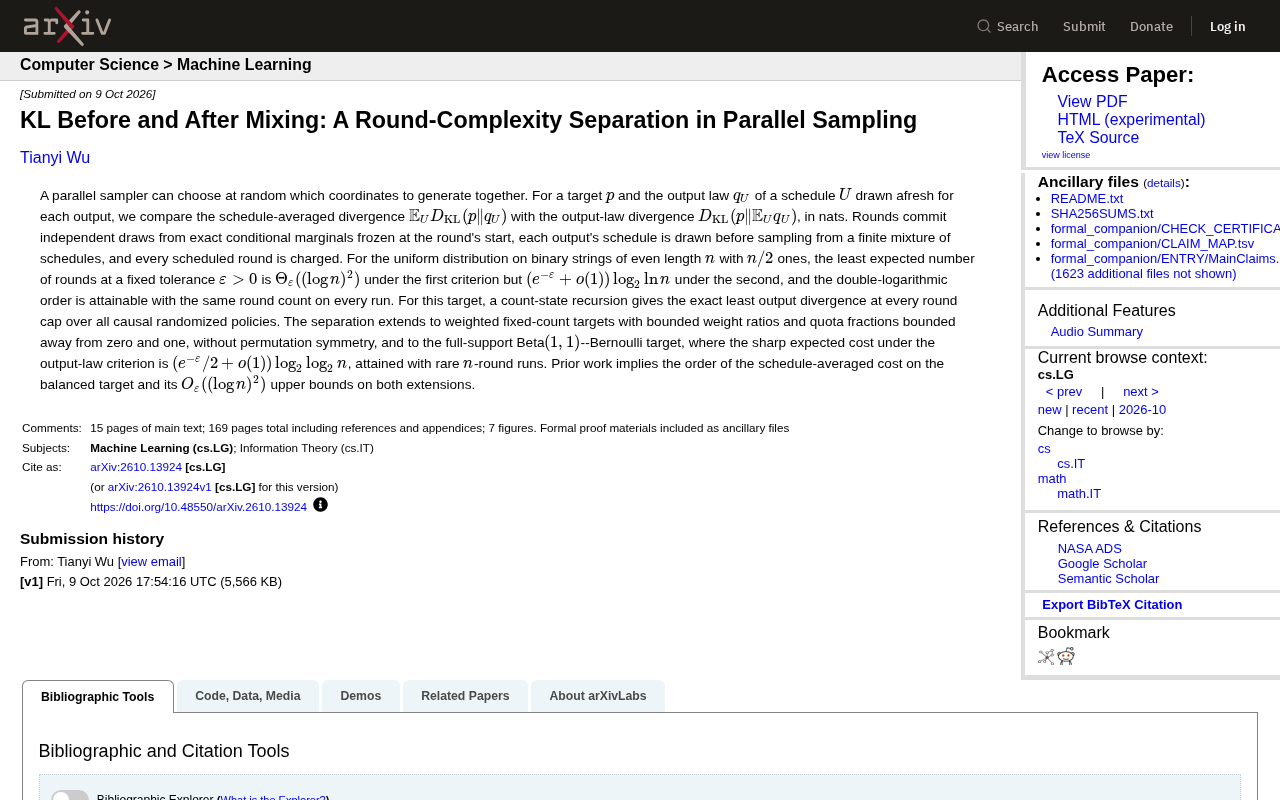
这篇论文研究并行采样中两种误差度量方式的根本差异:**调度平均散度**要求每个调度路径单独逼近目标,而**输出律散度**只要求所有调度混合后的分布逼近目标。以长度为 $n$、含 $n/2$ 个1的均匀分布(平衡目标)为基准,前者需要 $\Theta((\log n)^2)$ 轮,后者仅需双对数量级轮数——两者之间存在严格的渐近复杂度分离。分离的根源在于:随机化调度允许不同运行路径产生互补偏差,这些偏差在混合中相互抵消,使整体分布以远少的轮数达到目标精度。作者通过计数状态递归给出精确刻画(而非松散上下界),并将结果推广至带权重固定计数目标和Beta(1,1)-Bernoulli目标。对实践的启示是:评估并行采样器质量时,度量的选择本身至关重要;若关心整体输出保真度,允许单路径偏差、依赖随机化纠偏,可能换来数量级的效率提升。
从一个简单的采样问题说起
并行采样(parallel sampling)是现代生成模型加速推理的核心技术之一。它的基本思想是:不必逐个坐标生成样本,而是允许采样器随机选择哪些坐标一起生成,从而把本应串行的多步计算压缩进更少的"轮"(rounds)里。问题在于——这种压缩究竟能走到多快?不同的误差度量方式,会给出截然不同的答案。
这篇研究正是围绕这一点展开。它针对目标分布 $p$ 与某个调度方案 $U$ 产生的输出分布 $q_U$,比较了两种衡量误差的方式:一种是调度平均散度 $\mathbb{E}U D{\mathrm{KL}}(p|q_U)$,即先算每个调度下的KL散度再取期望;另一种是输出律散度 $D_{\mathrm{KL}}(p|\mathbb{E}_U q_U)$,即先把所有调度的输出分布混合起来再算KL散度。两者的顺序之差——"混合前"还是"混合后"——带来了惊人的复杂度鸿沟。
**KL散度(Kullback-Leibler Divergence)**是衡量两个概率分布差异的标准工具。对于分布 $p$ 和 $q$,$D_{\mathrm{KL}}(p|q) = \sum_x p(x)\log\frac{p(x)}{q(x)}$,它度量的是"用 $q$ 近似 $p$ 时损失的信息量"。KL散度非负,当且仅当两分布完全相同时取零,且是非对称的——$D_{\mathrm{KL}}(p|q) \neq D_{\mathrm{KL}}(q|p)$。在采样质量评估中,选择 $D_{\mathrm{KL}}(p|q_U)$ 意味着以目标分布 $p$ 为基准衡量采样器输出的偏差;而Jensen不等式保证了 $D_{\mathrm{KL}}(p|\mathbb{E}_U q_U) \leq \mathbb{E}U D{\mathrm{KL}}(p|q_U)$,即"先混合再度量"总是不大于"先度量再平均",这正是两种度量产生量级鸿沟的数学根源。
两种度量,两种命运
论文的核心模型设定值得先厘清。每一轮采样会从该轮开始时冻结的精确条件边缘分布中进行独立抽取;每个输出的调度方案在采样前从有限的调度混合中抽出;并且每一个被安排的轮次都要计入成本。这是一个相当严格的"因果随机化策略"框架。
在这个框架下,作者选取了一个经典目标:长度为偶数 $n$、恰好含 $n/2$ 个 1 的二进制串上的均匀分布(即平衡目标)。结论是:在固定容差 $\varepsilon>0$ 下,
- 按调度平均散度衡量,所需的最少期望轮数为 $\Theta_\varepsilon((\log n)^2)$;
- 按输出律散度衡量,则骤降至 $(e^{-\varepsilon}+o(1))\log_2\ln n$。
前者是对数的平方量级,后者却是双对数量级。这意味着仅仅改变误差度量的定义顺序,采样所需的轮数就从 $(\log n)^2$ 坍缩到 $\log\ln n$ 级别——这是一个巨大的渐近分离。更关键的是,这个双对数的量级可以在每一次运行中以相同的轮数达到,而非仅在期望意义上成立。
**因果随机化策略(causal randomized schedule)**是本文的核心分析框架,理解它对把握结论的适用范围至关重要。"因果"指的是:在第 $t$ 轮决定采样哪些坐标时,只能依赖前 $t-1$ 轮已经生成的信息,而不能预见未来的随机性。"随机化"则允许调度本身带有随机性——即以某种概率分布从多个候选调度方案中抽取。这与确定性调度(每次运行固定相同的坐标顺序)形成对比:随机化赋予了策略"让不同运行路径产生互补偏差"的能力,而正是这种能力在输出律度量下被充分利用,驱动了双对数量级的轮数节省。该框架排除了诸如"根据之前坐标的取值动态调整采样精度"等更强的自适应策略,因此所有结论都是在相对受限的合理模型下成立的。
为什么混合顺序如此重要
直觉上,调度平均散度要求每一个单独的调度 $q_U$ 都要逼近目标 $p$,这是一个逐实例的苛刻要求。而输出律散度只要求把所有调度混合后的平均分布 $\mathbb{E}_U q_U$ 逼近 $p$——不同调度可以各自偏差,只要它们的偏差在混合中相互抵消即可。
这正是随机化策略发挥威力的地方。通过让不同的调度产生互补的偏差,混合分布可以用远少的轮数达到同样的逼近精度。换句话说,"随机选哪些坐标一起生成"这件事本身,在输出律度量下蕴含了额外的近似能力,而这种能力在逐调度度量下被完全浪费掉了。
从方法论上看,作者为平衡目标构造了一个计数状态递归(count-state recursion),能够在任意轮数上限下、对所有因果随机化策略精确给出最小的输出散度。这不是一个松散的上下界夹逼,而是精确刻画,这让分离结果的严格性大大增强。
分离结果的普适性
一个自然的疑问是:这种分离是否只是平衡目标的特殊产物,依赖于它的排列对称性?论文给出了否定的回答。
分离结果被推广到了两类更一般的场景:
- 带权重的固定计数目标:只要权重比有界、配额比例远离 0 和 1,即使没有排列对称性,分离依然成立;
- 全支撑的 Beta(1,1)–Bernoulli 目标:在输出律准则下,其精确期望成本为 $(e^{-\varepsilon}/2+o(1))\log_2\log_2 n$,这一代价是通过罕见的 $n$ 轮运行来实现的。
最后这一点尤其耐人寻味:双对数量级的期望成本之所以可能,是因为策略允许在极小概率下执行完整的 $n$ 轮采样。正是这些罕见的"长尾"运行,在期望意义上压低了整体轮数——这揭示了随机化策略中期望成本与最坏情况成本之间的微妙张力。
Beta(1,1)-Bernoulli目标是指:$n$ 个独立的 Bernoulli 随机变量,其成功概率 $\theta$ 本身服从 Beta(1,1) 分布(即 $[0,1]$ 上的均匀分布)。边缘化掉 $\theta$ 后,这个联合分布对任意二进制串赋予正概率,且分布的形态与平衡目标有本质差异——它没有固定的汉明重量约束,也不具备排列对称性(不同位置的边缘分布在给定 $\theta$ 后虽然独立同分布,但 $\theta$ 的随机性引入了位间相关性)。将分离结果推广到这一目标,说明双对数量级的轮数优势并非依赖于"恰好 $n/2$ 个1"这一组合约束,而是在更广泛的全支撑分布下同样成立,从而增强了理论结论的普适意义。
与已有工作的关系
作者也诚实地标明了与先前研究的边界。此前的工作已经隐含了平衡目标上调度平均成本的量级,以及两类推广目标上 $O_\varepsilon((\log n)^2)$ 的上界。本文的新贡献在于首次在输出律准则下给出了双对数量级的精确刻画,并由此确立了两种度量之间的严格轮数复杂度分离。
对并行采样实践的启示
尽管这是一篇偏理论的工作,它对并行采样的工程实践仍有潜在启发。当我们评估一个并行采样器的质量时,"用什么度量"并非中性选择——如果最终关心的是采样器输出分布的整体保真度(即混合后的分布),那么理论上存在远比逐调度逼近更高效的策略空间。
这也提醒从业者:在设计加速采样方案时,追求每个调度路径都高度逼近目标,可能是过度保守的目标。允许单路径偏差、依靠随机化调度在整体上纠偏,或许能换来数量级的轮数节省。当然,如何把这种渐近的理论优势转化为可实现的实际算法,仍是开放的工程挑战。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。