渐进式披露让Agent提速2.3倍:上下文工程新思路

渐进式披露通过按需分层加载上下文,让Agent运行提速2.3倍。
文章从Hacker News的一则讨论出发,介绍「渐进式披露」这一源自交互设计的策略如何被移植到AI Agent开发中。当前许多Agent框架习惯在系统提示词里塞入全部工具schema、参考文档与冗长历史,导致每轮推理的输入token居高不下。文章分析上下文膨胀拖慢Agent的三条路径:推理延迟随token线性增长、长上下文引发注意力稀释与「lost in the middle」现象、无效工具描述造成干扰与误调用。对应的实践手段包括分层工具目录、按需检索文档、历史压缩摘要与分阶段系统提示,本质是把一次性全量加载改为按需渐进加载。作者对2.3倍提速持谨慎态度,认为其有场景局限性,但指出上下文优化的收益可与换用更快模型相当,并提醒落地时需警惕额外决策开销与信息遗漏风险。
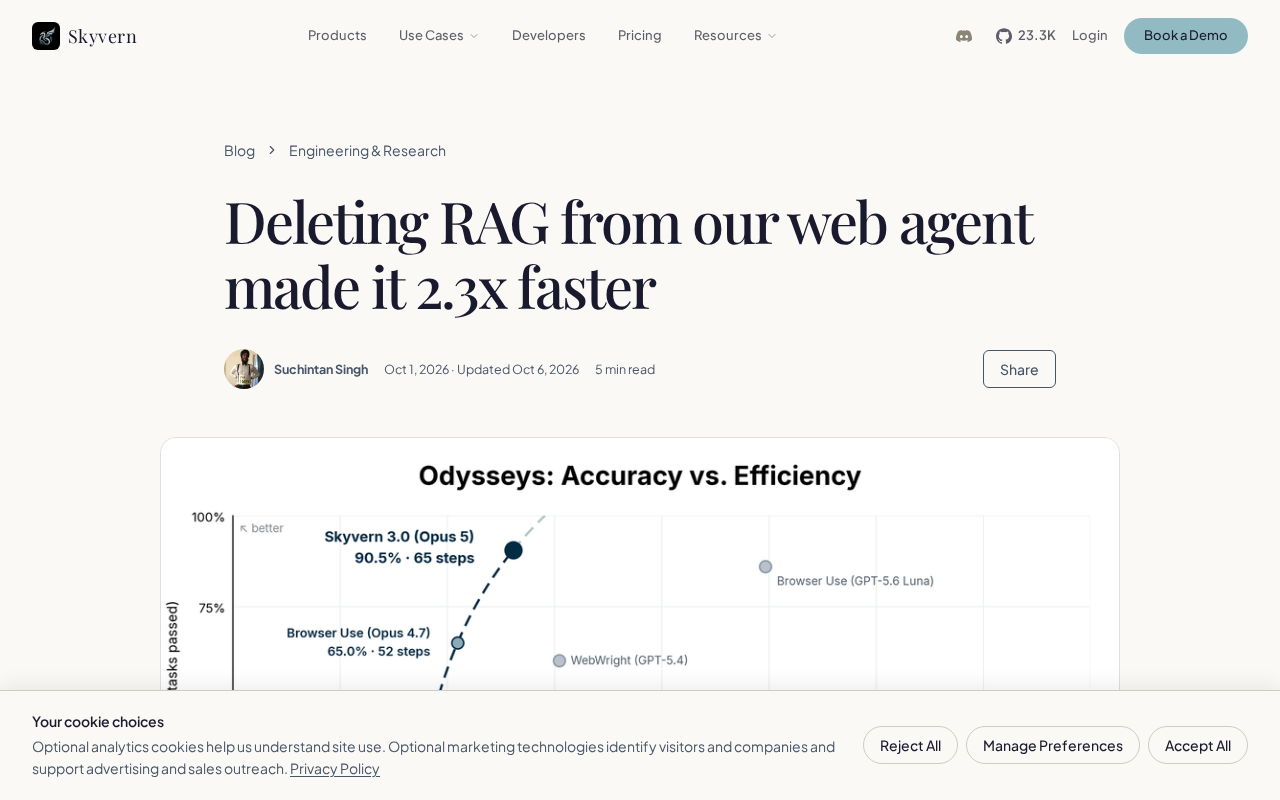
在AI Agent的开发实践中,一个常被忽视的性能瓶颈正逐渐浮出水面:上下文管理。来自Hacker News的一则讨论指出,通过「渐进式披露」(Progressive Disclosure)策略,可以让Agent的运行速度提升2.3倍。这个数字背后,指向的是上下文工程(Context Engineering)这一正在成形的方法论。
什么是渐进式披露?
渐进式披露并非AI领域的新概念,它最早来自交互设计——指界面只在用户需要时才逐步展示信息,避免一次性倾泻所有选项。将其移植到Agent语境中,核心思想变成了:不要让Agent在每一轮推理时都背负全量的工具描述、文档内容和历史记录,而是按需、分层、分阶段地加载信息。
这与当前主流做法形成鲜明对比。许多Agent框架习惯在系统提示词中塞入所有可用工具的完整schema、全部参考文档和冗长的对话历史,导致每次调用LLM时输入token数量居高不下。上下文越长,推理延迟越高,且模型对关键信息的注意力也越容易被稀释。
为什么上下文膨胀会拖慢Agent
Agent的性能损耗主要来自三个层面。
推理延迟的线性增长
大模型的推理时间与输入token数大致呈正相关。当工具数量从5个增长到50个,仅工具描述本身就可能占据数千token。每一轮ReAct循环都要重复传输这些「静态负担」,延迟自然水涨船高。
ReAct循环是Agent领域最经典的推理-行动范式,由Reasoning(推理)与Acting(行动)两个阶段交替组成:模型先输出一段思考,决定调用哪个工具及参数,执行后拿到观察结果,再进入下一轮思考。每一轮循环都需要把「系统提示 + 历史轨迹 + 新观察」整体重新送入模型,因此上下文的静态部分会被反复计费和反复推理。这也是为什么工具schema这类固定内容对延迟的影响具有乘数效应——它并非只传输一次,而是随循环轮数线性累加。理解这一点,就能明白压缩静态上下文为何能带来远超预期的加速比。
注意力稀释与决策质量下降
更隐蔽的问题在于,过长的上下文会让模型难以聚焦真正相关的信息。业界常说的「lost in the middle」现象表明,模型对上下文中部内容的利用率明显偏低。当工具列表和文档堆满提示词,Agent选择正确工具、引用正确片段的准确率会下降,进而引发更多的试错循环——这本身就是巨大的时间开销。
Lost in the middle 是斯坦福等机构在2023年提出的一项实证发现:当把关键信息放置在长上下文的不同位置时,模型对开头和结尾内容的召回率明显高于中部,呈U型曲线。这意味着即便模型声称支持超长上下文窗口,也不代表它能均匀地利用其中每一处信息。对Agent而言,工具schema与文档往往被堆在提示词中部,恰好落在利用率最低的区间。缓解手段包括把最关键指令前置或后置、对注入内容做显式编号与摘要标记,以及通过减少总量来缩短「中部」的跨度。
无效工具的干扰
一个拥有几十个工具的Agent,在特定任务中往往只需要其中两三个。剩余工具的描述不仅浪费token,还可能诱导模型调用不相关的工具,产生额外往返。
渐进式披露的实践路径
据该Hacker News讨论的思路,实现渐进式披露可以从几个方向入手。
分层工具目录。 先向Agent暴露工具的类别和简短描述,当Agent表达出某类意图后,再加载该类下具体工具的完整schema。这类似于人类使用文档时先看目录、再翻具体章节。
按需检索文档。 不把全部知识库塞进提示词,而是让Agent通过检索工具主动获取片段,仅将命中的相关内容注入上下文。RAG本身就是这一思路的体现,但渐进式披露强调在Agent的每一步决策中动态控制注入量。
历史压缩与摘要。 长对话中,早期的交互细节可以压缩为摘要,只在需要回溯时展开原文。这能显著控制上下文的增长曲线。
分阶段系统提示。 将系统提示拆分为基础指令和任务相关指令,后者根据当前任务阶段动态挂载。
这些手段的共同点是把「一次性全量加载」改为「按需渐进加载」,本质上是在上下文这一稀缺资源上做更精细的调度。
2.3倍加速意味着什么
2.3倍的提速数字需要谨慎看待——它很可能来自特定任务、特定模型配置下的实测,未必能直接迁移到所有场景。但这个量级提示我们,上下文优化带来的收益可能不亚于换用更快的模型或增加硬件。
对开发者而言,这意味着在追逐更大上下文窗口的同时,反向思考「如何少用上下文」同样有价值。更长的上下文窗口解决的是「能不能装下」的问题,渐进式披露解决的是「该不该装」的问题。两者并不矛盾,而是互补:窗口再大,无节制地填充也会牺牲速度和准确率。
从成本角度看,减少输入token直接降低API调用费用,同时也减少推理能耗。对于高频调用的生产级Agent,这种优化会随时间持续放大。
落地时的注意事项
渐进式披露并非没有代价。分层加载引入了额外的决策步骤——Agent需要先判断「我需要哪类信息」,这本身消耗一轮推理。如果分层设计得过于复杂,节省的token可能抵不过新增的往返开销。
另一个风险是信息遗漏:如果目录描述不够准确,Agent可能意识不到某个有用工具的存在,从而走上弯路。因此,分层目录的命名和摘要质量至关重要,它实际上承担了「信息路由」的职责。
实践中的稳妥做法是从小处着手:先统计Agent实际调用中各工具的命中率,识别出高频工具与长尾工具,对长尾部分做延迟加载。用真实调用数据驱动分层设计,比凭直觉划分类别更可靠。
小结
渐进式披露把交互设计的经典原则带入了Agent工程,提醒我们上下文是一种需要精打细算的资源。2.3倍的提速数字或许有场景局限性,但其背后的方向值得每位Agent开发者认真对待:在提示词里少放一点,在恰当的时机多问一句,往往比堆砌更多信息更有效。
背景补充
工具schema通常采用JSON Schema格式描述,包含工具名称、功能说明、每个参数的名称、类型、是否必填、枚举取值与描述等字段。一个中等复杂度的工具,其完整schema往往在100至300 token之间,参数多、描述详尽的企业级工具甚至可达500 token以上。当Agent挂载数十个工具时,仅这部分内容就可能消耗上万token,且每轮循环重复传输。渐进式披露的做法是先只暴露工具名与一句话描述(可压缩至十余token),待意图明确后再加载完整schema,从而把大部分token消耗推迟到真正需要的时刻。
RAG(检索增强生成) 的常规形态是在用户提问后一次性检索Top-K片段并全部拼接进提示词,检索粒度与注入量在调用前就已固定。渐进式披露则把检索变成Agent可主动调用的工具:模型先形成查询、观察返回的标题或摘要,再决定是否深入某一条目。二者的差异在于控制权归属——前者由外部流程静态决定注入什么,后者由模型在推理过程中动态决定。这也意味着检索接口需要返回分层结果(如标题列表、片段摘要、完整原文三级),才能支撑逐步下钻的交互模式。
相关推荐
Underdog Saluki 27B:2-Bit量化下的工具调用实战指南
深入解读 Underdog Saluki 27B 基于 GSQ-RCO 的 2-bit 量化方案,涵盖 GGUF 头部结构、内存占用分析与原生 llama.cpp 下的 BFCL 工具调用实测要点,助你评估低比特量化模型的实用边界。
OpenAI与Anthropic限制智能电视逆向工程,引发AI伦理争议
OpenAI与Anthropic限制智能电视逆向工程项目REA,引发AI安全与开放研究争议。本文分析事件背景、隐私隐患及AI公司的使用政策,探讨平衡之道。

GPU-unlock:解锁 Nvidia 3000 系显卡的 FP/BF16 指令发射率
gpu-unlock 项目探索 Nvidia 3000 系显卡在 FP16/BF16 计算上的指令发射率限制,本文解读其测量方法、解锁思路、社区争议以及对 GPU 性能优化的实际意义。