Bio-PM编码器空间合成IMU数据,跨被试HAR精度显著提升

在Bio-PM冻结编码器token空间合成IMU数据,使LOSO宏F1从0.729升至0.809。
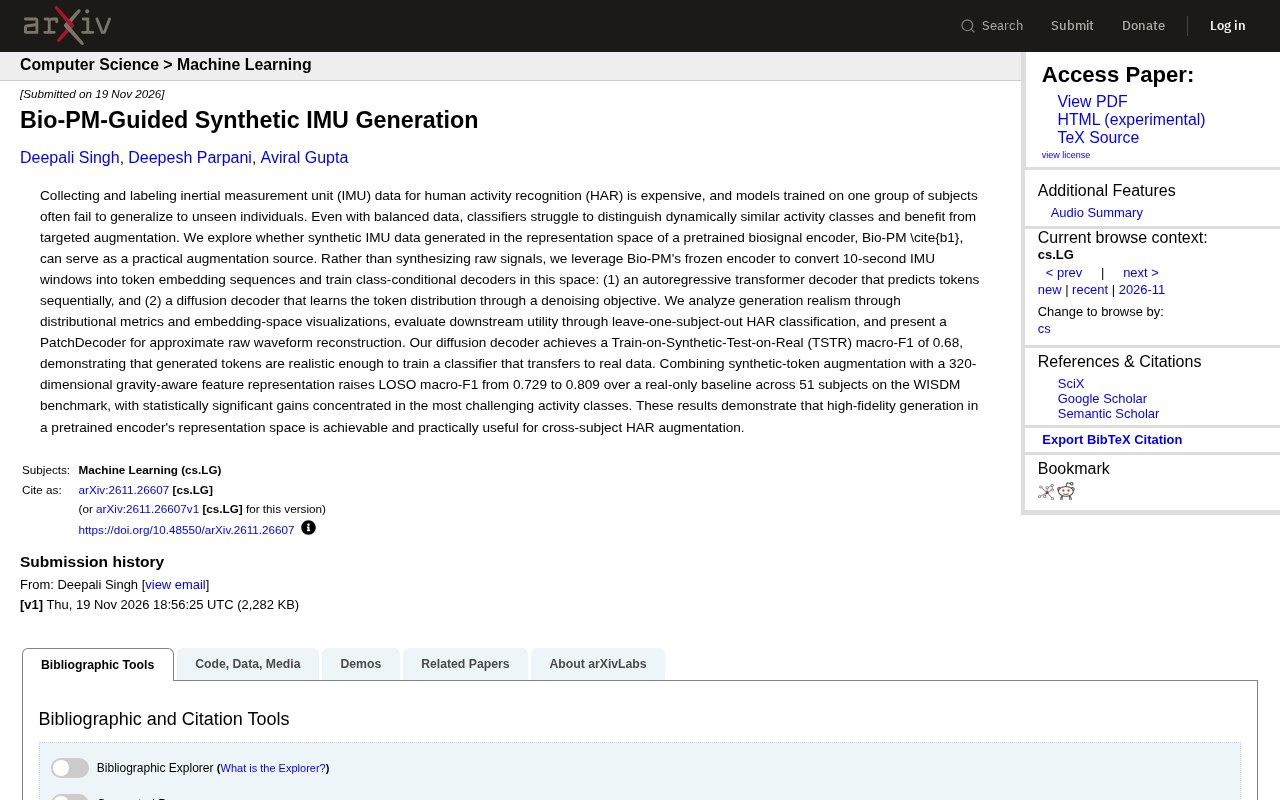
本文介绍一项新研究:为缓解人体活动识别中IMU数据稀缺与跨被试泛化难题,作者不在原始信号层面合成,而是在预训练生物信号编码器Bio-PM的冻结表示空间中生成token序列。方法上训练自回归Transformer与扩散两类类条件解码器,并用PatchDecoder近似重建波形。评估包括分布度量、嵌入可视化和留一被试(LOSO)分类。结果显示扩散解码器在TSTR设置下宏F1达0.68;将合成token增强与320维重力感知特征结合后,WISDM 51名被试的LOSO宏F1从0.729提升至0.809,增益集中于最具挑战性的活动类别且统计显著。作者指出该路径成本低、可行,但仍依赖特定编码器与数据集,波形重建仅为近似,部署前需评估编码器泛化性与计算开销。
为什么合成IMU数据值得关注
人体活动识别(HAR)依赖惯性测量单元(IMU)数据,但收集和标注这类数据成本高昂,且模型在训练集被试上表现良好,换一批人就容易失效——跨被试泛化是长期痛点。即便数据类别均衡,分类器仍难以区分动态相似的活动。一项新研究提出:不在原始信号层面合成,而是在预训练生物信号编码器 Bio-PM 的表示空间中生成 token 序列,作为实用的数据增强来源。
跨被试泛化(cross-subject generalization) 是HAR中的核心评估范式:模型在部分被试的数据上训练,在未见过的被试上测试(即留一被试,LOSO)。由于每个人的步态、肢体长度、佩戴习惯不同,IMU信号分布存在显著的个体差异,模型容易过拟合训练被试的特定模式。LOSO宏F1是衡量该能力的常用指标——宏F1对每个活动类别单独计算F1后取平均,因此对少数类和难分类别更敏感,能反映增强是否真正帮助了困难样本而非被多数类掩盖。
方法:在冻结编码器空间中训练解码器
研究团队利用 Bio-PM 的冻结编码器,将 10 秒 IMU 窗口转换为 token 嵌入序列,然后在此空间训练两类类条件解码器:
- 自回归 Transformer 解码器:按顺序预测 token;
- 扩散解码器:通过去噪目标学习 token 分布。
此外,作者还提出 PatchDecoder,用于近似重建原始波形。评估维度包括分布度量和嵌入空间可视化(判断生成真实感),以及留一被试(LOSO)HAR 分类(判断下游实用性)。
据论文报告,扩散解码器在“合成训练-真实测试”(TSTR)设置下取得 0.68 的宏 F1,说明生成的 token 足够真实,可训练出能迁移到真实数据的分类器。
Bio-PM(生物信号预训练模型) 是一类在大规模生理/生物信号上自监督预训练的编码器,能够将原始时序信号映射为具有语义结构的token嵌入序列。文中“冻结编码器”意味着生成阶段不更新编码器参数,只在固定的表示空间上训练解码器,这既降低了训练成本,也保证了生成样本与真实样本处于同一特征分布。
自回归Transformer解码器按序列顺序逐个预测下一个token,类似GPT式生成;扩散解码器则从噪声出发,通过多步去噪逼近目标token分布。两者都是类条件生成(class-conditional),即给定活动类别标签生成对应token,从而可按需合成均衡或补足难类的数据。
TSTR(Train on Synthetic, Test on Real) 是评估生成数据实用性的标准设置:仅用合成数据训练分类器,再在真实数据上测试。TSTR宏F1越高,说明合成token越接近真实分布,具备可迁移的判别信息。
关键结果:增强后LOSO宏F1从0.729升至0.809
在 WISDM 基准的 51 名被试上,将合成 token 增强与 320 维重力感知特征表示结合,LOSO 宏 F1 从仅真实数据的 0.729 提升到 0.809,且统计显著的增益集中在最具挑战性的活动类别上。这意味着表示空间合成确实能缓解跨被试泛化难题,尤其对难分类样本有效。
320维重力感知特征表示是一种手工设计的IMU特征工程方法,通常将加速度信号分解为重力分量与线性加速度分量,并在多个时间窗上提取统计量(均值、方差、频域能量等),最终拼接为固定维度的特征向量。相比端到端深度模型,这类特征对个体差异更鲁棒,常作为HAR的强基线。本文将其与合成token增强结合,说明表示空间合成样本可与传统特征表示互补,带来额外增益。
WISDM是HAR领域广泛使用的公开数据集,包含多名被试在行走、跑步、上楼、下楼、坐、站等活动下的手机/手表IMU记录。其被试数量较多,适合进行LOSO评估;宏F1的提升在51名被试上统计显著,且增益集中于难分类别,表明增强并非简单放大了易分类样本。
启示与局限
这项工作验证了“在高保真预训练编码器表示空间中生成”的可行性,为 IMU 数据稀缺场景提供了低成本增强路径。不过,当前结果仍依赖特定编码器与数据集,生成 token 到原始波形的重建只是近似,实际部署时需评估编码器泛化性与计算开销。
相关推荐
Anthropic上市:AI泡沫还是买入机会?
Anthropic在纳斯达克上市,开盘价较发行价高出约三分之一,市场给出两万亿美元级别的隐含估值。拆解813亿美元募资、1.5万亿美元发行估值与两万亿美元市场估值三个数字的差异,分析Claude业务增长与5.67亿美元季度营业亏损并存的基本面,并给出下一份财报该关注的检查清单。
FBI的AI黑客警告,为何系于微软一句话
FBI公告称AI工具Artex攻击超2250家组织,但引用链显示该数字源自微软报告中"尝试登录"的表述。尝试与成功入侵之间的差距,揭示了这场AI驱动攻击的真实规模与日志证据的局限。
Fable 5.2 助攻:浏览器里的月球火星探索游戏 Getsumen Express 诞生记
开发者利用 Fable 5.2 平台打造浏览器游戏《Getsumen Express》,玩家可探索月球火星、扫描真实地标、射击外星人并乘坐星际列车。游戏基于 Three.js 与 WebGPU 开发,成本约 730 美元,展示了 AI 辅助开发的潜力。