BiRefNet移动端NPU部署难题:高通芯片为何难跑亚秒级分割?
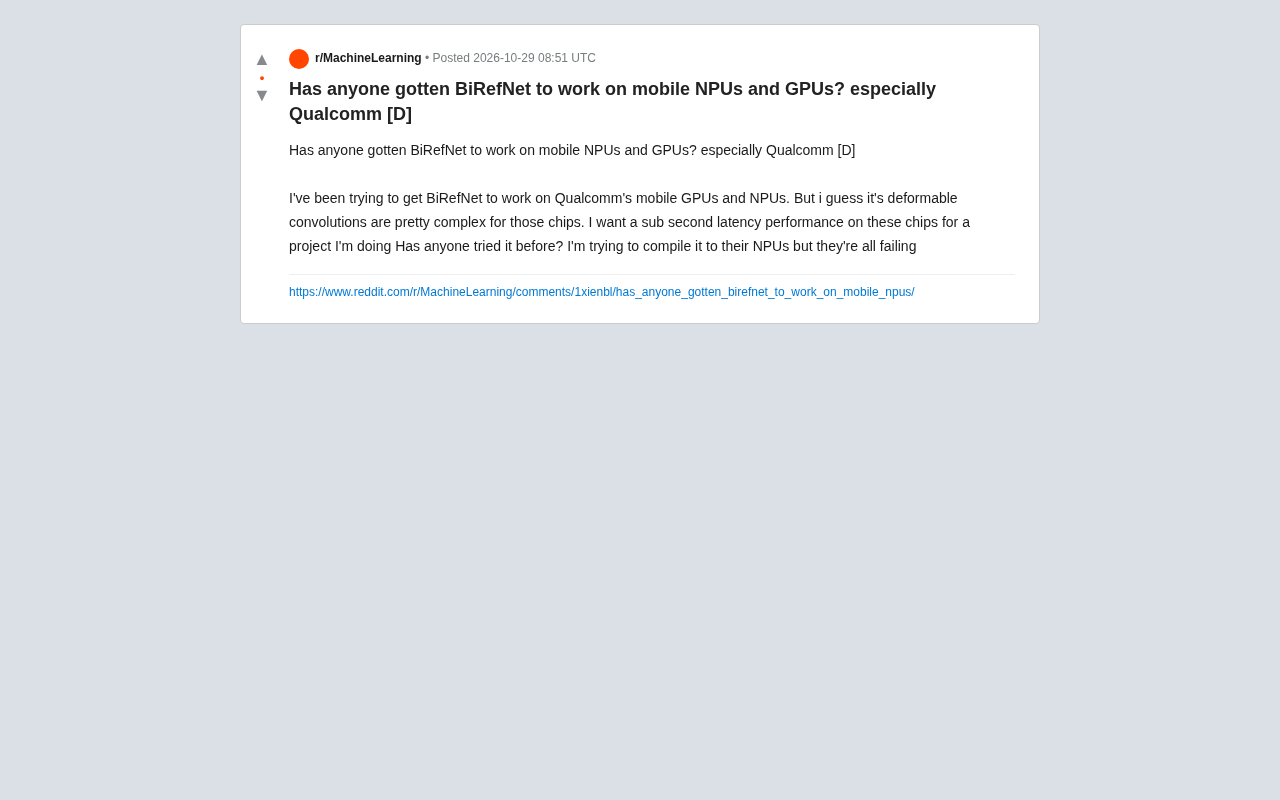
BiRefNet因可变形卷积难以部署到移动NPU/GPU,亚秒级延迟目标面临硬件与算子适配的双重挑战。
文章围绕开发者在Reddit求助将BiRefNet部署到高通移动GPU和NPU失败的事件展开。BiRefNet以高分辨率分割和边缘细节见长,但其大量使用的可变形卷积需要动态偏移预测和双线性插值,属于动态算子,高通Hexagon NPU的算子支持有限,工具链在编译阶段即报错;移动GPU虽能灵活实现插值与动态索引,但受算力和带宽限制,亚秒级延迟仍难达成。文章梳理了量化、降分辨率、算子替换、知识蒸馏与GPU/NPU混合执行等优化方向及其精度权衡,指出社区尚无BiRefNet在移动NPU成功部署的公开案例,并建议开发者先用QNN分析算子、考虑ONNX Runtime回退机制,必要时重新评估模型选型。
在移动端实现实时高质量图像分割,一直是端侧AI落地的难点。最近,有开发者在Reddit上发帖求助,称其尝试将BiRefNet模型部署到高通移动GPU和NPU上,但编译到NPU时全部失败,GPU上的表现也不理想,而他的项目目标是在这些芯片上实现亚秒级延迟。这个帖子引发了不少关注,因为它触及了端侧AI部署的一个核心矛盾:先进的模型架构与移动芯片的硬件特性之间往往存在鸿沟。
BiRefNet是什么?为何在移动端遇阻
BiRefNet是一种用于高分辨率图像分割的模型,以其出色的边缘细节和透明物体处理能力著称。其架构中大量使用了可变形卷积(deformable convolutions),这种操作允许卷积核在采样时具有空间自适应性,从而更好地捕捉不规则形状。然而,可变形卷积正是移动端NPU和GPU的“噩梦”。
与标准卷积不同,可变形卷积需要动态计算采样位置,这涉及额外的偏移量预测和双线性插值步骤。这些操作在桌面级GPU上尚可高效执行,但在移动NPU上,由于缺乏对动态索引和插值操作的硬件加速支持,往往导致算子无法映射到NPU的指令集,从而编译失败。该开发者提到“编译到NPU时全部失败”,很可能就是遇到了不支持的算子。
可变形卷积(Deformable Convolution) 最早由 Dai 等人于 2017 年提出(Deformable ConvNets),其核心思想是在标准卷积的规则采样网格上,为每个采样点额外学习一个二维偏移量(offset),使卷积核能够自适应地聚焦于目标的不规则几何结构。具体实现中,偏移量由一个额外的卷积层从输入特征图预测得到,采样位置随之变为非整数坐标,因此需要通过双线性插值从特征图上取得对应位置的数值。
这一机制显著增强了模型对形变、旋转和非刚性物体的建模能力,在分割、检测等任务中常带来精度提升。但代价是引入了数据依赖的动态索引与插值运算,破坏了标准卷积的静态计算图特性。对于依赖固定算子映射和静态调度编译的移动端推理框架而言,这类动态算子往往无法被有效图化或硬件加速,是端侧部署中公认的高风险算子。
高通NPU的算子支持限制
高通的Hexagon NPU(以及此前的DSP)对算子的支持相对有限,主要优化了常规卷积、池化、激活等静态图算子。对于可变形卷积、网格采样(grid_sample)等动态算子,通常需要回退到CPU或GPU执行,或者由开发者手动实现近似版本。该开发者试图直接将BiRefNet编译到NPU,但工具链(如高通SNPE或QNN)可能无法识别这些复杂算子,导致编译阶段就报错。
即使编译通过,NPU的并行计算架构也更适合规则的数据流,可变形卷积带来的不规则内存访问会严重降低利用率。因此,想要在NPU上实现亚秒级延迟,目前看来挑战极大。
高通 SNPE 与 QNN 是高通提供的两代端侧推理工具链。SNPE(Snapdragon Neural Processing Engine)是较早的 SDK,支持将 Caffe、TensorFlow、ONNX 等模型转换并调度到 CPU、GPU(Adreno)或 DSP/NPU(Hexagon)上执行;QNN(Qualcomm AI Engine Direct)则是较新的底层 API,提供更细粒度的后端控制,并逐步取代 SNPE 成为高通端侧 AI 的主要部署路径。
两者的共同点是采用“算子白名单 + 图划分”的工作方式:工具链会逐一检查模型中的算子是否被目标后端支持,不支持的算子会被切分出来回退到 CPU 执行,或在转换/编译阶段直接报错。因此,当模型中包含可变形卷积、grid_sample 等非标准算子时,常见现象是编译失败,或产生大量碎片化的子图而丧失 NPU 加速收益。开发者通常需要借助工具链的算子分析功能预先识别这些“断点”。
GPU上的表现与优化空间
相比NPU,移动GPU(如Adreno系列)对可变形卷积的支持稍好一些,因为GPU的着色器程序可以灵活实现插值和动态索引。但移动GPU的算力和带宽有限,BiRefNet本身计算量较大,尤其是高分辨率输入时,亚秒级延迟仍然难以达到。该开发者没有透露具体延迟数据,但表示“想要亚秒级性能”,暗示当前GPU上的表现可能离目标还有距离。
一些可能的优化方向包括:降低输入分辨率、使用模型量化(如FP16或INT8)、将可变形卷积替换为轻量级替代方案(如深度可分离卷积加空间注意力),或者采用知识蒸馏训练更小的学生模型。但这些改动都可能影响分割精度,需要权衡。
模型量化 是端侧部署中最常用的压缩手段之一。FP16 量化将权重和激活从 32 位浮点降到 16 位,通常精度损失很小,且现代移动 GPU 普遍支持 FP16 运算,可获得明显的带宽与算力收益。INT8 量化则进一步将数值映射到 8 位整数,需要借助校准数据集统计激活值的动态范围,并可能引入量化误差,对分割边缘细节较为敏感的任务需谨慎评估。
需要注意的是,可变形卷积中的双线性插值和动态偏移预测对量化较为敏感,低比特量化可能放大插值误差。实践中常采用混合精度策略:对偏移预测和插值相关层保留 FP16,其余层使用 INT8,以在延迟与精度之间取得平衡。
社区是否有成功案例?
截至发帖时,该开发者尚未得到明确回复。在公开资料中,也鲜有BiRefNet在移动端NPU上成功部署的案例。这反映出一个现实:许多前沿模型在设计时优先考虑精度,对端侧部署的友好性不足。不过,社区中已有一些针对移动端优化的分割模型(如MobileSAM、FastSAM),它们通过简化架构或采用更高效的算子来实现实时性,或许可以作为替代方案或改进参考。
对于必须使用BiRefNet的场景,另一种思路是混合执行:将可变形卷积部分放在GPU上执行,其余部分交给NPU,但这样会引入数据搬运开销,需要仔细设计流水线。
对开发者的建议
如果你也面临类似问题,可以尝试以下步骤:首先,使用高通的QNN工具链分析模型,确认哪些算子不支持;其次,考虑用ONNX Runtime的移动端部署方案,它可能提供算子回退机制;再者,关注BiRefNet的官方仓库或社区分支,看是否有针对移动端的优化版本;最后,如果亚秒级延迟是硬性要求,可能需要重新评估模型选型,选择专为移动端设计的分割网络。
端侧AI的部署从来不是简单的模型转换,而是需要深入理解硬件特性与模型结构的匹配度。BiRefNet的案例提醒我们,在追求精度的同时,部署友好性同样值得关注。
相关推荐
Gemini 4 Carbon登顶智能指数 谷歌首次开放攻防模型
谷歌Gemini 4 Carbon以59分登顶Artificial Analysis智能指数,网络安全能力首次向防御方开放;OpenAI每月返还最高500美元API额度反击,开源阵营语音、小模型与智能体工程密集迭代。

Gemini 4 Carbon登顶AI基准,成本比榜首低72%
谷歌DeepMind发布Gemini 4 Carbon,在Archital Analysis Intelligence Index B5榜单以59分登顶,Arena文本榜第一1528分,中位任务成本仅80美元,比榜首Cloud Office 1.5低72%。

Gemini 4 Carbon实测:最强AI模型?对比Claude Opus 5.5
谷歌Gemini 4 Carbon发布,Artificial Analysis榜单第一,CW Bench达71%,Vending Bench登顶。实测对比Claude Opus 5.5,前端设计惊艳但Web开发略逊,价格优势明显。