Gemini 4 Carbon实测:最强AI模型?对比Claude Opus 5.5

谷歌发布Gemini 4 Carbon,跑分登顶且低价高能,但「史上最强」仍待实测检验。
谷歌新一代前沿模型 Gemini 4 Carbon 发布,官方称其在 Artificial Analysis Intelligence Index 5.0 登顶,CW Bench 网络安全测试达 71%,Vending Bench 长程任务榜首,并宣称提示词注入成功率归零、幻觉率下降。B 站 UP 主实测显示其 3D 资产生成与前端动效进步显著,纯 Web 开发略逊于 Claude Opus 5.5,但价格仅为后者几分之一,性价比突出。文章同时提醒 Argon 跑分虚高的前车之鉴,并梳理了 Fable 5.5 泄露、Claude 功能更新、谷歌 Q3 财报及英伟达、苹果等同期动态,指出 DeepMind 暗示更强 Gemini 仍在路上。
谷歌突然发布了新一代前沿模型 Gemini 4 Carbon,官方宣称其在 Artificial Analysis 榜单排名第一,并在网络安全与长程任务上刷新记录。我们结合 B 站 UP 主的前瞻实测与官方数据,看看它到底强在哪,以及是否配得上「史上最强」的称号。
基准测试:跑分屠榜,但需警惕「虚高」历史
据谷歌公告,Carbon 在 Artificial Analysis Intelligence Index 5.0 榜单登顶,同时在网络安全和长程决策任务中创下新高。最引人注目的是 CW Bench 测试拿下 71% 的成绩,该测试要求模型有效排查并修复安全缺陷的根本原因,显示出极强的实战安全能力。
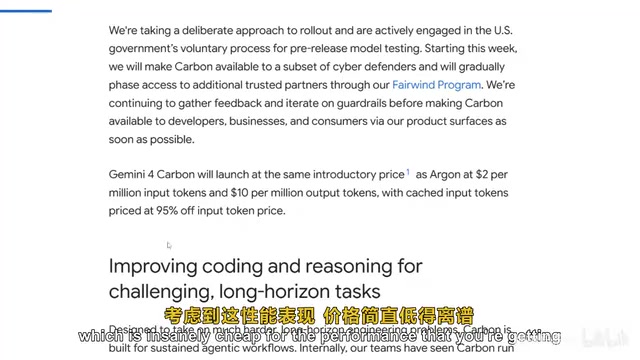
谷歌内部测试还显示,Carbon 在生成安全代码方面的成功率是上一代 Argon 的两倍以上。官方甚至断言其提示词注入攻击成功率「彻底为零」,幻觉率也明显降低。不过 UP 主提醒,Argon 发布时跑分同样亮眼,实际体验却与 Opus 差距明显,因此对 Carbon 的跑分应保持谨慎乐观。
Artificial Analysis Intelligence Index 是由独立评测机构 Artificial Analysis 维护的模型能力综合指数,通常整合推理、编程、数学、知识问答等多个维度,用加权方式折算为单一分数。它的特点是更新快、覆盖主流闭源与开源模型,因此在发布节点常被厂商引用;但其权重设计未必反映具体场景下的真实可用性,且模型可能针对公开基准做过优化。
CW Bench 是聚焦网络安全实战能力的基准,题目多来自真实漏洞场景,要求模型定位缺陷根因并给出可落地的修复方案,而非仅识别漏洞模式。它比传统代码补全测试更接近安全工程师的日常工作流,因此 71% 的分数被视为较高的实战门槛。
长程任务突破:Vending Bench 登顶
Carbon 在 Vending Bench 测试中斩获榜首,这是它最被低估的亮点。该基准评估 AI 能否自主运营模拟自动售货机业务,需管理库存、定价、财务并做出数百项环环相扣的决策,保持长期策略连贯。大多数模型在此类长周期商业模拟中败下阵来,Carbon 的登顶意味着智能体维持类商业项目自主运营的能力迈上新台阶。
长程任务(long-horizon task) 指需要模型在数十甚至数百步交互中保持目标一致、记忆上下文并动态修正策略的任务类型。与单轮问答不同,长程任务的核心难点在于误差累积:早期一个错误决策会传导至后续所有环节,因此对模型的规划、状态跟踪与自我纠错能力要求极高。Vending Bench 正是这类基准的代表,它用自动售货机经营模拟把库存、定价、现金流等变量耦合在一起,检验智能体能否在长周期内维持商业逻辑自洽,而非只完成单步操作。
实测体验:前端设计惊艳,编程略逊 Opus
UP 主实测显示,Carbon 在 3D 资产生成和前端动效上进步显著。例如仅凭代码生成奢华厨房场景,玻璃摆放、材质纹理和肉架细节都相当精细,光影虽有瑕疵但整体惊艳。滚动触发动效首页的视觉审美与细节处理也获得好评。
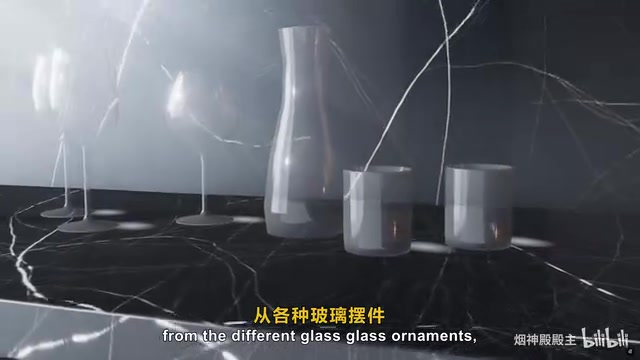
不过在纯 Web 开发领域,Carbon 仍略逊于 Claude Opus 5.5,多数编程任务则与 Opus 不相上下。考虑到其价格远低于 Opus,UP 主表示愿意将其作为日常主力模型。
3D 资产生成 指模型直接输出可渲染的三维场景或物体,通常以代码(如 Three.js、WebGL 着色器)或结构化几何描述为中间表示。它比生成 2D 图像更难,因为需要同时满足几何拓扑、材质纹理与光影一致性,且代码必须可执行。评测中「奢华厨房场景」的细节表现,反映的是模型对空间布局与材质参数的联合控制能力,而不仅是视觉审美。
定价与开放节奏:低价高能
Carbon 延续 Argon 的首发价格:每百万输入 Token 2 美元,输出 10 美元,缓存输入减免 95%。结合其性能表现,性价比极为突出。开放节奏上,谷歌先通过 FairWing 计划向网络安全防御人员开放,随后几周内逐步向所有用户推送,目前普通用户尚无法使用。
谷歌的后手:更强 Gemini 已在路上
DeepMind 预训练研究员 Zachary 在 Carbon 发布当天回复讨论时意味深长地表示「Gemini 还没上线」,暗示还有能力远超 Carbon 的模型在开发中,外界猜测可能是 Gemini 4 Ultra。同时,代号 Hydrogen 的训练检查点也被提及。谷歌显然在延续元素周期表命名体系,并保持激进迭代节奏。
同期看点:Fable 5.5 泄露、Claude 更新与硬件动态
据爆料,疑似 Fable 5.5 的模型 Obsidian 3 出现在 Frontier Code 2.0 基准中,高推理强度下得分 46.8%,仅微弱领先 Opus 5.5 的 45.5%,最大推理强度下更降至 45.5% 持平,单次推理成本却高达约 47 美元,是 Opus 5.5 同等强度下的 3.6 倍。若属实,提升幅度令人失望,早期检查点的惊艳表现未能延续。
Claude 方面,用户可在输入框输入 UltraThink 直接调整推理强度;Claude Code 推出动态工作流,支持通过可编辑的 JavaScript 文件调用多个子智能体,串行或并行执行,并可保存为斜杠命令复用。此外,有消息称 Claude 账号封禁背后存在一套隐秘积分系统。
谷歌 Q3 财报显示 AI 对增长的拉动显著:Alphabet 营收同比增长 25%,年化规模达 5000 亿美元;谷歌云营收增长 103%,第一方模型 API 每分钟处理近 320 个数据,环比增长 40%。由于需求超出基础设施承载,谷歌计划第四季度大幅增加第三方算力,资本开支从 1950 亿美元提升至 2050 亿美元。
其他动态包括:英伟达发布 300 亿参数混合专家语音识别模型 Nemotron 3.5 Transcribe,推理仅激活 40 亿参数,支持 40 种语言及说话人识别,在 Hugging Face OpenASR 英语榜平均词错误率 5.33%;Motion Bricks 系统每秒生成 15000 帧动作画面,RTX 5090 上延迟仅 2 毫秒;苹果推出首款触屏 MacBook Pro,搭载 ProLED XDR 触控显示屏,可能改变 AI 开发与创意工作流。
混合专家(MoE) 是一种模型架构:把大模型拆成多个「专家」子网络,每次推理只激活其中一部分参数,从而在总参数量很大的情况下控制计算成本。Nemotron 3.5 Transcribe 的「300 亿总参数、仅激活 40 亿」正是这一思路,使语音识别模型能在保持多语言与说话人识别能力的同时降低推理延迟和算力开销。
结语:最强之名待验证,但方向对了
Carbon 在跑分和实测中都展现出谷歌补齐短板的决心,低价策略更让其具备成为主力模型的潜力。但「史上最强」仍需真实用户大规模检验,而 DeepMind 的暗示也说明 Carbon 可能只是开始。对开发者而言,一个更便宜、更全能的 Gemini 显然值得期待。
相关推荐

泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。

74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。
Gemini 4 Argon实测:定价激进,3D能力需调教
Gemini 4 Argon 实测:限时定价 2/10 美元,百万级输出 token,3D 与逆向工程表现亮眼,但前端审美和零样本能力存短板,需多轮调教。