BitDecoding-FP4:原生FP4 KV缓存解码的算法系统协同设计
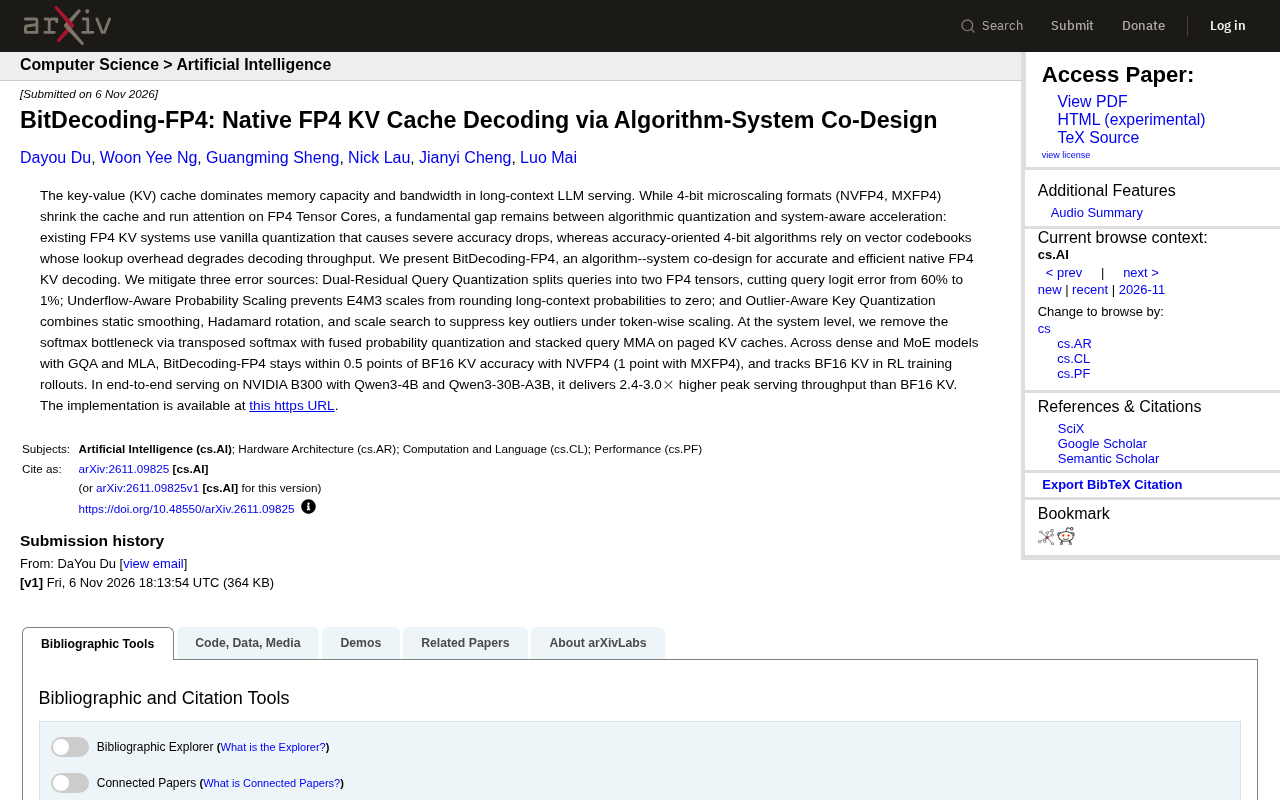
BitDecoding-FP4以算法-系统协同设计实现准确高效的原生FP4 KV解码。
长上下文LLM服务中,KV缓存随上下文线性增长,成为内存与带宽的核心瓶颈。4位微缩放格式(NVFP4、MXFP4)理论上可大幅压缩KV缓存并启用FP4张量核心注意力,但现有FP4 KV系统采用朴素量化导致精度严重下降,而高精度4位算法又依赖向量码本查表拖累译码吞吐。BitDecoding-FP4提出算法-系统协同方案:算法上以双残差查询量化将logit误差从60%降至1%,用下溢感知概率缩放防止长上下文概率被舍入为零,并以静态平滑、Hadamard旋转和缩放搜索抑制键离群值;系统上采用转置softmax融合概率量化、在分页KV缓存上堆叠查询MMA以消除softmax瓶颈。在NVIDIA B300上相比BF16 KV实现2.4至3.0倍峰值吞吐提升,NVFP4下精度差距在0.5个百分点以内。
长上下文LLM服务的KV缓存瓶颈
在长上下文LLM服务中,键值(KV)缓存占据了内存容量和带宽的绝对主导地位。随着上下文长度不断攀升,KV缓存的大小呈线性增长,成为制约推理效率的核心瓶颈。4位微缩放格式(如NVFP4、MXFP4)的出现,让KV缓存压缩和基于FP4张量核心的注意力计算成为可能,理论上能大幅降低内存占用并提升吞吐。
然而,算法层面的量化与系统层面的加速之间仍存在显著鸿沟:现有的FP4 KV系统采用朴素量化,导致精度严重下降;而面向精度的4位算法又依赖向量码本,其查表开销反而拖累了译码吞吐。BitDecoding-FP4正是为弥合这一鸿沟而提出的算法-系统协同设计方案,旨在实现既准确又高效的原生FP4 KV解码。
KV缓存是自回归推理中为避免重复计算历史token的键(Key)和值(Value)而缓存的中间张量。其大小约为 2 × 层数 × 头数 × 头维度 × 序列长度 × 每元素字节数,随上下文长度线性增长。以70B级模型、32K上下文为例,KV缓存可达数十GB,远超模型参数之外的内存预算,并直接限制批处理大小与吞吐。微缩放格式(Microscaling, MX) 是一类块浮点格式:将张量按固定块大小(如32个元素)分组,每组共享一个缩放因子(如E8M0),元素本身用低比特(如FP4的E2M1)表示。NVFP4与MXFP4是NVIDIA与OCP推动的两种4位微缩放变体,区别主要在块大小与缩放因子格式。它们使KV缓存能以4位存储,并借助FP4张量核心直接完成注意力矩阵乘,但量化误差与反量化开销是落地的主要障碍。
三大误差来源与算法创新
BitDecoding-FP4从三个维度抑制了FP4量化带来的误差,每一项都针对一个具体的误差来源。
双残差查询量化(Dual-Residual Query Quantization)
查询(Query)的量化误差会直接传导到注意力logit上。研究发现,朴素FP4量化会导致查询logit误差高达60%。BitDecoding-FP4将查询拆分为两个FP4张量,通过双残差的方式保留更多信息,将logit误差从60%大幅削减至1%。这种拆分策略在不增加额外存储开销的前提下,显著提升了查询表示的精度。
下溢感知概率缩放(Underflow-Aware Probability Scaling)
长上下文场景下,注意力概率分布往往非常稀疏,大量概率值极小。当使用E4M3格式的缩放因子时,这些长上下文概率容易被舍入为零,造成信息丢失。BitDecoding-FP4引入下溢感知的概率缩放机制,防止概率值在量化过程中下溢为零,从而保留长上下文中的关键注意力信号。
离群值感知键量化(Outlier-Aware Key Quantization)
键(Key)中的离群值会破坏逐token缩放的量化效果。BitDecoding-FP4组合了静态平滑、Hadamard旋转和缩放搜索三种技术,有效抑制键离群值的影响。其中Hadamard旋转能够将离群值分散到多个维度,而缩放搜索则进一步优化量化参数,确保在token级缩放下的量化鲁棒性。
Hadamard旋转是一种正交变换,通过对向量乘以Hadamard矩阵(或其快速变体),将能量均匀分散到所有维度。在量化中,它能把少数数值极大、主导动态范围的离群值“摊平”,使逐token或逐块的缩放因子更能代表整体分布,从而降低量化误差。该变换可逆且计算为O(d log d),在注意力中对Key应用后需在查询侧做对应变换以保持点积不变。静态平滑则是在校准阶段估计各通道的缩放系数,对Key做逐通道重缩放,把通道间的方差差异拉平。两者与缩放搜索配合:后者在候选缩放因子中搜索使量化误差最小的取值,共同提升token级缩放下的鲁棒性。
系统层优化:消除Softmax瓶颈
算法层面的精度提升需要系统层面的配合才能转化为实际吞吐。BitDecoding-FP4在系统层面针对分页KV缓存(paged KV cache)进行了深度优化。
传统注意力计算中,softmax操作往往成为译码阶段的瓶颈。BitDecoding-FP4采用转置softmax(transposed softmax),将概率量化与softmax融合,减少中间结果的写回开销。同时,在分页KV缓存上堆叠查询MMA(矩阵乘加)操作,提升了张量核心的利用率。这些系统级优化与算法改进形成闭环,共同支撑了端到端的高吞吐。
分页KV缓存(Paged KV Cache) 借鉴操作系统虚拟内存的分页思想,将KV缓存切分为固定大小的块(block),通过块表映射到非连续的物理显存。它消除了为每条序列预留连续最大长度的浪费,支持动态批处理与序列共享,是vLLM等推理系统的核心机制。但其间接寻址会让注意力核函数中的访存不规则,尤其在FP4下需要额外的反量化与缩放因子加载。转置softmax指在分块注意力计算中,将softmax的归一化方向与矩阵乘的累加方向对齐,使概率量化可以就地融合进softmax的归约过程,避免将完整概率矩阵写回显存再读出。查询MMA堆叠则是把多个查询块的矩阵乘加指令连续发射,填满张量核心流水线,掩盖分页访存与反量化的延迟。
精度与性能表现
BitDecoding-FP4在多种模型架构上验证了其精度保持能力。在稠密模型和MoE模型上,覆盖GQA和MLA两种注意力机制,使用NVFP4时,BitDecoding-FP4与BF16 KV的精度差距保持在0.5个百分点以内;使用MXFP4时,差距为1个百分点。此外,在强化学习训练rollout中,BitDecoding-FP4也能跟踪BF16 KV的精度表现。
在NVIDIA B300上的端到端服务测试中,使用Qwen3-4B和Qwen3-30B-A3B模型,BitDecoding-FP4相比BF16 KV实现了2.4至3.0倍的峰值服务吞吐提升。这一结果说明,算法-系统协同设计能够将FP4的理论优势转化为实际的服务效率。
开源与展望
BitDecoding-FP4的实现已在GitHub开源(https://github.com/OpenBitSys/BitDecoding-FP4),为研究者和工程师提供了可复现的FP4 KV解码方案。其核心思路——针对具体误差来源设计算法,并在系统层消除量化引入的额外开销——为未来更低比特的KV缓存加速提供了可借鉴的范式。随着长上下文应用日益普及,这类协同设计有望成为LLM服务基础设施的重要组成部分。
相关推荐
Claude Code额度不够用?实测哪些技巧真省额度
实测 Claude Code 20美元套餐:换用 Sonnet 或 Haiku、降低 effort 能让同样任务额度减半以上,而 /clear、/compact、plan mode 等流传技巧在短会话中几乎不省额度甚至更贵。
Anthropic新研究:AI记忆如何避免「记错」?
Anthropic最新报告探讨AI智能体跨会话记忆的可靠性:数据库任务中记忆提升基准分数,但游戏实验显示记忆可能固化错误。报告建议保留证据、测试规则、纠正过时笔记,为助手构建者提供实践指南。
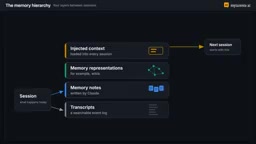
AI智能体记忆全解析:四层结构与“做梦”机制
解读Anthropic智能体记忆研究:记忆的四层架构、以CLBench和宝可梦实验检验“该记什么”,以及通过“做梦”修正笔记、构建wiki、提升上下文注入质量的机制与局限。