Bonsai 2实测:27B模型压进6GB,98%性能是真的吗?
Bonsai 2将27B参数模型三值量化至6GB,短任务接近原版,但复杂智能体任务中陷入死循环。
Prism ML推出的Bonsai 2通过将Qwen3-27B每个权重限制为-1、0、+1三种取值,将模型体积压缩至6GB,使其可在普通MacBook上本地运行。实测显示,在单轮问答、聊天和轻量编码等短任务上,该模型基本兑现了"保留原始模型98%性能"的承诺;然而在需要多步规划的智能体任务(如构建ISS追踪器)中,模型彻底卡住,陷入将同一搜索重复执行114次的死循环,而完整Qwen模型则顺利完成了同一任务。这一对比揭示了极端量化的核心局限:精度损失在单轮场景中被平均掉,却在长链条推理中不断累积放大,最终导致决策稳定性崩溃。作者建议在采信综合benchmark之前,应先用自己的真实任务进行测试。
把27B模型塞进6GB文件:Bonsai 2是什么
一个270亿参数的大模型,整个文件只有6GB,还能在普通MacBook上跑起来——这就是来自Prism ML的Bonsai 2。它的做法听起来有些激进:拿Qwen 3 的27B版本(Qwen3-27B)作为底座重新训练,让模型里的每一个权重只保留三种取值:-1、0 或 +1。
这是一种极端的三值量化(ternary quantization)。常规模型的权重用16位或8位浮点数表示,而三值化把每个参数压缩到不足2比特,带来的直接收益就是体积的断崖式下降。Prism ML给出的核心卖点是:如此激进的压缩之后,模型仍然保留了原始Qwen模型98%的性能。
如果这个数字成立,意义不小。它意味着原本需要高显存GPU才能部署的27B级模型,可以直接落到消费级笔记本上运行,大幅降低本地推理的门槛。
三值量化(ternary quantization)并非Bonsai 2首创,其理论基础可追溯到2016年微软研究院提出的1-bit/ternary网络研究,近年来则由Meta的BitNet系列以及BitNet b1.58等工作重新推向关注焦点。BitNet b1.58正是将权重限制为{-1, 0, +1}三种取值,与Bonsai 2的做法高度一致。这种表示方式之所以能工作,是因为现代大模型的绝大多数权重在训练后绝对值很小,接近零的权重被直接归零,剩余权重的符号(正/负)往往就足以捕捉主要的语义方向。关键挑战在于,模型不能在已有浮点权重上直接"截断"——那样精度损失不可控。Bonsai 2的做法是重新训练(从Qwen3-27B的架构出发,以三值约束为目标进行完整的训练过程),而非对已有权重做后期量化(post-training quantization),这是它与普通量化工具(如GGUF Q4)的本质区别,也是其能在激进压缩后仍声称保留高性能的关键原因。
短任务表现:98%站得住脚
在该YouTube创作者的实测中,Bonsai 2在短任务上的表现确实令人意外。面对单轮的问答、对话和一次性的问题,它几乎与完整尺寸的Qwen模型打成平手。
换句话说,在聊天、知识问答、代码片段求助这类上下文短、交互轮次少的场景里,98%的性能宣称并没有翻车。对于只想在笔记本上跑一个本地助手、不联网也能回答问题的用户来说,这已经是相当实用的能力。
三值量化能把性能损失控制在如此小的范围内,本身就是一个值得关注的工程成果。它说明大模型的权重中确实存在大量冗余,极端压缩在很多任务上并不会立即崩盘。
Agentic任务翻车:114次重复的同一次搜索
真正的考验出现在长程、多步骤的智能体(agentic)任务上。测试者给模型布置了一个真实工作:在3D地球仪上构建一个国际空间站(ISS)追踪器。
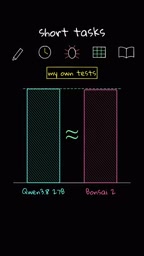
结果形成鲜明对比。完整的Qwen模型搭建出了一个可以正常工作的追踪器;而Bonsai 2则彻底卡住——它没有为这个应用写出哪怕一行代码。更离奇的是,它陷入了一个死循环:把完全相同的搜索执行了114次,每次都得到同样的结果,却始终无法向前推进。
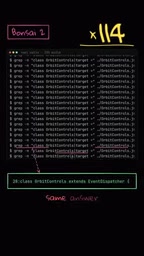
这个现象很有代表性。短任务只需要模型给出一次正确响应,而agentic循环要求模型在多步之间保持状态、规划、纠错和推进。极端量化带来的精度损失,在短任务里被平均掉了,但在需要长链条推理和决策稳定性的场景下会被不断放大,最终导致模型无法完成复杂规划。
这种"死循环"现象在语言模型智能体研究中有一个专门的描述:重复陷阱(repetition trap)或状态坍塌(state collapse)。智能体框架通常依赖模型在每一步根据历史观察(observation)更新内部规划状态,再决定下一步动作(action)。这要求模型能够准确区分"上一步已经做了什么"与"下一步应该做什么"——本质上是一种对上下文的精细读写能力。三值量化压缩了权重的信息密度,使模型在长上下文下对微小语义差异的辨别力下降。当工具调用返回的结果与预期略有偏差时,量化后的模型更可能将其"识别"为初始状态并重新触发同一动作,而非正确地识别出已完成该步骤并推进到下一步。这一机制也解释了为什么短任务几乎无感知——单轮推理不涉及跨步骤的状态追踪,精度损失没有累积放大的机会。
什么时候能用,什么时候别用
综合测试结果,Bonsai 2的适用边界其实很清晰。
适合的场景:
- 本地聊天助手
- 知识问答与信息查询
- 笔记本上的轻量编码帮助(单段代码、片段级别)
不适合的场景:
- 长时间运行的智能体任务
- 需要多步规划、工具调用和状态保持的复杂工作流
- 对决策稳定性要求高的自动化流程
创作者给出的建议务实而中肯:在你信任benchmark之前,先用自己的真实任务测一遍。98%这个数字在特定测试集上可能完全成立,但它掩盖了任务类型之间的巨大差异。压缩在chat和QA上成立,不代表它在agentic负载上同样成立。
一点思考:极端量化的边界在哪里
Bonsai 2这个案例提供了一个很有价值的参照:三值量化(1-bit级别的权重表示)在知识型、单轮型任务上几乎无损,证明了模型权重的高度冗余;但它在需要精确推理链的任务上会显著退化。
这也提醒了社区一个常被忽视的问题——单一的性能百分比具有误导性。一个号称保留98%性能的模型,可能在你最在意的那类任务上恰好落在那损失的2%里。对本地部署的爱好者来说,Bonsai 2值得尝试,但要带着对其短板的清醒认知去用。
本文基于单一YouTube来源的实测,相关性能数据和任务表现有待更多独立测试进一步验证。
相关推荐
Databricks Genie重大更新:上下文、数据接入与自动化全面升级
Databricks Genie One迎来重大更新,涵盖业务感知上下文、工作区指令、多格式文件上传、Unity Catalog直连查询和定时自动化任务,推动企业级AI数据助手深度融入数据工作流。
Omnigent:让Claude Code与Codex协同工作的开源元框架
Omnigent是一款开源元框架,让Claude Code、Codex等多个编码智能体共享会话、规则与安全策略。本文解析其任务分叉、Debby多Agent评审辩论与Polly子Agent拆分等协作模式。
算力上太空:谷歌与Planet原型卫星成功发射意味着什么
谷歌与Planet合作的太空算力原型卫星由SpaceX成功发射。本文解析把计算搬到太空的动因、工程挑战以及商业航天生态的协同意义。