Bot-sitting:AI时代的新工作陷阱?
Bot-sitting揭示AI快速生成背后被低估的校验成本,工作形态从创造转向校对。
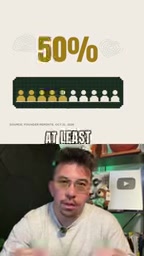
文章提出“bot-sitting”概念,描述员工不断检查和修正AI错误的现象。调查显示,60%每周使用AI并培训过新员工的工作者认为,从AI获得高质量成果所需的努力至少与培训一个人相当。AI虽能在10秒内生成报告初稿,但逐项核查数字、引用和事实的成本常被低估,检查本身仍是劳动。这导致工作形态从深度创造转向校对,入门级知识工作受影响尤为显著。AI效率提升是否存在取决于任务类型和员工经验:结构化、容错率高的任务收益明显,事实密集型任务则可能被校验成本抵消。文章建议明确AI适用边界、建立校验流程并调整绩效指标。
什么是Bot-sitting?
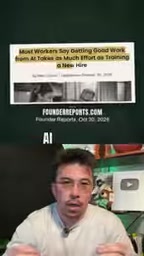
最近,一个名为“bot-sitting”的概念在科技圈引发讨论。它描述的是这样一种现象:当入门级知识工作变成不断检查和修正AI所犯错误时,员工实际上在“照看”AI,而非真正从事创造性工作。据YouTube频道分析,Founder Reports调查了每周使用AI且培训过新员工的工作者,结果显示60%的人认为从AI获得高质量成果所需的努力,至少与培训一个人相当。这揭示了一个容易被忽视的真相:AI生成内容很快,但验证和修正的成本可能被严重低估。
“知识工作”一词由彼得·德鲁克在1959年提出,指运用信息与知识创造价值的工作,如分析、写作、编程、咨询等,与体力劳动或重复性事务性工作相对。入门级知识工作通常包括资料搜集、初稿撰写、数据整理等任务,这些任务结构化程度较高,恰好是当前生成式AI最擅长介入的领域。Bot-sitting现象之所以集中在入门级知识工作上,正是因为这类工作既需要一定判断力,又包含大量可被AI快速生成的文本或数据,使得人类角色从“执行者”转变为“审核者”。
AI效率的幻象:快速生成与漫长校验
想象一下,AI在10秒内写完一份报告。你随手检查一个数字,错了;打开一个引用来源,发现原文根本没这么说。于是,你不得不通篇核查。这种场景正是bot-sitting的典型写照。据调查,40%的受访者认为使用AI比培训一个人更省力,但仍有60%的人持相反观点。关键在于,检查工作本身也是劳动。正如视频中所言:“检查仍然算工作。” 这意味着,即使AI缩短了初稿时间,总工时未必减少,只是工作形态发生了转移。
“校验成本”在软件工程和质量管理中常被称为验证与确认成本,即检查产出是否符合要求所耗费的时间与资源。在传统工作流中,初稿由人完成,作者在写作过程中已同步完成部分事实核对与逻辑检查;而AI生成内容时,这一内嵌的校验环节被剥离,全部转移给人类审核者。因此,AI节省的主要是“生成时间”,却可能增加“验证时间”。当验证时间超过生成时间的节省量时,总工时反而上升,这就是bot-sitting导致效率幻象的经济学逻辑。
工作变形:从创造到校对
Bot-sitting现象引发了一个根本性问题:员工真的完成了更多工作,还是工作只是改变了形状?当知识工作者花费大量时间核对AI输出时,他们原本用于深度思考、策略规划或创意发挥的精力被挤占。这种“校验负担”在入门级任务中尤为明显,因为新手往往缺乏快速判断AI输出准确性的经验。视频中的案例显示,一旦发现第一个错误,员工就不得不检查整个文档,形成连锁反应。
多源视角下的争议与共识
尽管单一调查揭示了bot-sitting的普遍性,但不同来源对AI效率的看法存在分歧。据YouTube频道和B站UP主的交叉分析,共识在于AI确实加速了初稿生成,但分歧在于净效率提升是否成立。一方认为,对于结构化任务(如数据整理),AI节省的时间远超校验成本;另一方则强调,在需要事实准确性的领域(如新闻、研究报告),bot-sitting可能抵消大部分收益。这种分歧提示我们,AI的价值高度依赖任务类型和员工技能水平。
“事实密集型”任务指对信息准确性要求极高、错误代价较大的工作,如新闻报道、学术研究、法律文书和财务报告。这类任务中,AI的“幻觉”——即生成看似合理但实际错误或虚构的内容——会显著抬高校验负担。相反,在容错率高的任务中,如头脑风暴、创意草稿或代码框架生成,即使AI输出不完美,人类也只需在此基础上修改而非逐项核查,净效率提升更容易实现。这一区分是理解AI效率争议的关键变量。
如何应对Bot-sitting挑战?
面对bot-sitting,组织和个人可以采取以下策略:首先,明确AI的适用边界,将其用于容错率高的任务(如头脑风暴、草稿生成),而非事实密集型输出;其次,建立校验流程,例如使用多源交叉验证或自动化事实核查工具;最后,重新定义绩效指标,将校验时间纳入考量,避免被“生成速度”误导。毕竟,工作的本质是产出价值,而非单纯的速度竞赛。
Bot-sitting不是否定AI的工具价值,而是提醒我们:效率提升需要全流程视角。当AI承担了“写”的部分,人类则承担了“查”的责任——这种分工是否合理,取决于我们如何设计工作流。
相关推荐
OpenAI发布GPT-6.2 Astra与Sol:长上下文与双模型策略解析
OpenAI 发布 GPT-6.2 系列 Astra 与 Sol,均支持 105 万 Token 上下文,Astra API 单价降 20%。结合社区实测,解析双模型定位、知识新鲜度与不确定性表达的真实表现。
GPT-6.2 Astra vs Sol实测:Blender钟表、Neon Cube与Godot赛车三项对比
B站UP主同题实测GPT-6.2 Astra与Sol:在Blender钟表工坊、Neon Cube霓虹方块和Godot赛车游戏三项任务中,Astra执行力强但成本高,Sol便宜却偷懒,赛车游戏甚至掉到每秒两帧。
Pandex:通过MCP让AI智能体接入欧洲官方法律
Pandex项目通过MCP协议将欧洲官方法律开放给AI智能体调用,探索智能体合规的新路径。本文分析该方案的架构思路、现实优势与落地挑战,以及它对AI应用开发者的参考意义。