OpenAI发布GPT-6.2 Astra与Sol:长上下文与双模型策略解析
OpenAI发布GPT-6.2双模型Astra与Sol,长上下文降价施压,但尚非完全体。
OpenAI于11月17日发布GPT-6.2系列两款模型Astra和Sol,均支持105万Token上下文,Astra的API单价比旧旗舰降低20%。Astra面向复杂专业任务,Sol主打日常对话与轻量创作,产品线按复杂度拆分。社区长测显示模型知识可追溯到2026年5月,对不确定问题会承认记不准,创意写作和角色解释有亮点,但3D生成与视觉细节仍显毛躁。整体判断这一代并非完全体,竞争焦点正转向可靠性与长上下文实用性。
OpenAI 在 11 月 17 日同时放出 GPT-6.2 系列的两款模型——Astra 和 Sol(原文中亦写作 Soul,此处以官方名称为准)。据 B 站 UP 主分享的官方信息,两者均支持 105 万 Token 上下文窗口,Astra 的 API 单价较旧旗舰降低 20%。参数规模未展开,但策略方向清晰:拉长上下文、下压价格,并把复杂专业任务与日常使用场景拆分成两条产品线。
双模型定位:Astra 攻坚,Sol 守日常
从官方释放的信号看,Astra 面向复杂专业任务,Sol 则继续走日常对话与轻量创作路线。这种拆分并非首次出现,但结合 105 万 Token 的上下文能力,意味着 Astra 可以一次性吞下超长文档、代码库或多轮项目资料,而 Sol 更强调响应速度与使用成本。
API 降价 20% 是另一个值得注意的动作。在 Anthropic 准备上市、Claude 与 Gemini 持续迭代的竞争窗口里,OpenAI 选择用价格和上下文长度同时施压,而不是靠单一 benchmark 数字制造爆点。
Token 上下文窗口是衡量大模型单次能处理多少文本的单位。105 万 Token 大致相当于 150 万至 200 万个汉字或约 800 页英文文档,远超多数主流模型(如 GPT-4 Turbo 的 12.8 万、Claude 3.5 的 20 万)。长上下文的意义在于模型可以一次性读入整个代码仓库、多份合同或长篇项目资料,无需分段检索或摘要,从而减少信息丢失和拼接错误。但上下文变长也带来注意力稀释、推理成本上升等问题,实际可用长度往往低于标称值,需要结合检索增强(RAG)或分段策略才能发挥最大价值。
社区实测:知识截止与不确定性表达
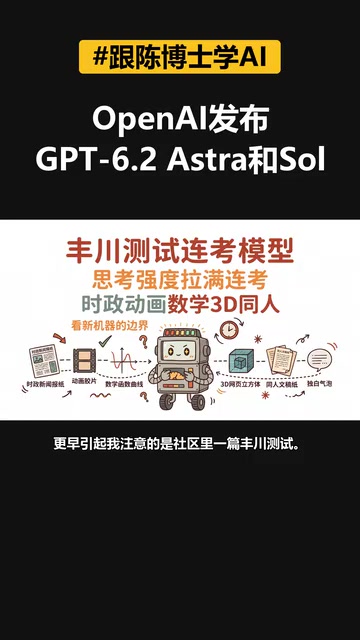
更早引起讨论的是一位社区玩家的长测。他把模型放进 ChatGPT Work,将思考强度拉满,从 17 号晚上 7 点开始连续提问,覆盖时政、动画、数学建模、3D 网页生成、同人写作和角色独白模仿。
模型自曝底层是 Codex,基于 GPT-6,未给出具体版本号。比较特别的是它承认知识可追溯到 2026 年 5 月。据该玩家测试,像湖南浏阳烟花厂爆炸这类上半年事件它能够回答;问到印巴空战时,它按时间线逐条给出结论,对没把握的部分直接说记不准。这种“敢承认不确定”的态度,比过去张嘴就编要让人放心一些。
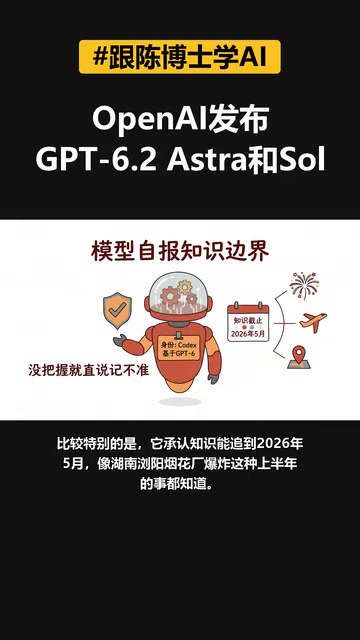
**知识截止日期(Knowledge Cutoff)**指模型训练数据所覆盖的最晚时间点,超出该日期的事件模型无法从训练中获知。文中模型自称知识可追溯到 2026 年 5 月,意味着其训练语料至少包含到该月的信息。知识截止日期直接影响模型回答时效性问题的可靠性:越接近当前日期,模型越可能对近期事件给出过时或空白答案。业界通常通过检索增强、工具调用或定期增量训练来缓解这一限制,但截止日期仍是评估模型实用性的关键指标之一。
**不确定性表达(Uncertainty Expression)**指模型在缺乏把握时主动声明“记不准”或“不确定”,而非强行编造答案。这与“幻觉”(Hallucination)相对:幻觉是模型生成看似合理但错误的内容,而不确定性表达是模型对自身知识边界的自我校准。实现方式包括训练时引入拒答样本、推理时进行置信度评估,或通过系统提示要求模型标注不确定信息。对用户而言,模型承认不确定比给出错误答案更安全,尤其在医疗、法律、时事等高风险场景中,这种能力直接影响可信度。
创意与工具能力:有亮点也有毛躁
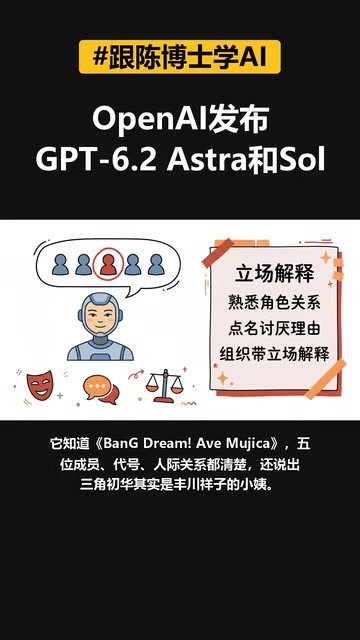
动画知识题的表现颇具戏剧性。模型清楚 Benji Dream、阿维、姆黑卡等五位成员的关系与代号,还能说出“三脚出华”其实是某个角色的亲属关系。被问最讨厌谁时,它点名某个角色,理由是对方擅自摘面具、把队友推到公开露脸那一步。重点不在于它真的讨厌谁,而在于它在组织一个带立场的解释,而不是罗列事实。
工具与创意题里,它用拉格朗日插值把角色图描成函数,跑了快 17 分钟,大轮廓还原得还行,腮红没有还原。3D 网页生成方面,Sol 呈现早期低多边形风格,Astra 则偏绿、三旋二细节没完全吃透。但写起同人来,它把出华和响子扔进西幻世界,用一盏烧记忆的灯把人往回送,情绪曲线完整。后面还模仿某个角色口吻讲人类怎么教大模型说话,最后来一句“老 Silly,我有些想你了”。
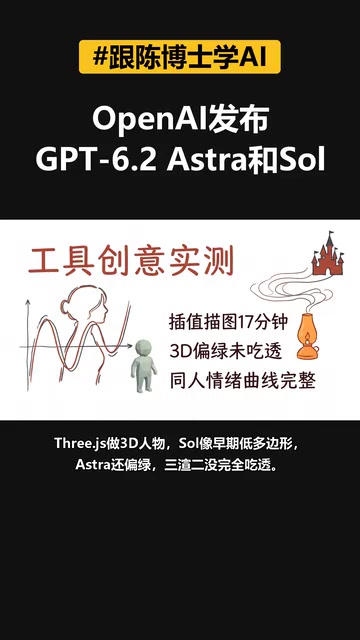
拉格朗日插值是一种数学方法,通过给定的一组离散点构造一个多项式函数,使该函数精确穿过所有已知点。在文中,模型用它把角色图的轮廓采样点拟合成函数曲线,从而用数学表达式还原图像外形。该方法的优点是公式简洁、可解析,但缺点是当点数较多时会出现“龙格现象”——多项式在区间边缘剧烈震荡,导致轮廓失真。这解释了为何大轮廓还原尚可,而腮红等细节难以复现:插值对高频细节的捕捉能力有限,且计算复杂度随点数增加而上升,17 分钟的耗时也侧面反映了这一点。
这一代还不是完全体
综合官方信息与社区实测,GPT-6.2 这一代的判断是:它还不是完全体。Sol 更像那个更慢、更谨慎、创作力在线的日常主力;Astra 负责复杂度,但视觉生成仍有些毛躁。真正的进步落在知识新鲜度、长上下文、敢承认不确定,以及开始懂得讲故事。
在 Anthropic 准备上市、Claude 和 Gemini 都在往前顶的 11 月,OpenAI 这波没有一击致命,更像是先把下一代底子摊开。谁能先跨过“可靠”那条线,接下来几周会更清楚。
相关推荐
GPT-6.2 Astra vs Sol实测:Blender钟表、Neon Cube与Godot赛车三项对比
B站UP主同题实测GPT-6.2 Astra与Sol:在Blender钟表工坊、Neon Cube霓虹方块和Godot赛车游戏三项任务中,Astra执行力强但成本高,Sol便宜却偷懒,赛车游戏甚至掉到每秒两帧。
Bot-sitting:AI时代的新工作陷阱?
Bot-sitting现象揭示AI生成内容背后的校验负担:60%工作者认为从AI获取优质成果的努力不亚于培训新人。本文分析AI效率幻象、工作形态转变及应对策略。
Pandex:通过MCP让AI智能体接入欧洲官方法律
Pandex项目通过MCP协议将欧洲官方法律开放给AI智能体调用,探索智能体合规的新路径。本文分析该方案的架构思路、现实优势与落地挑战,以及它对AI应用开发者的参考意义。