Bracket:为企业打造持续更新的「记忆层」

Bracket 自动将 Slack、Gmail 等沟通渠道转化为可查询的企业记忆层,无需人工维护知识库。
Bracket 是一款定位为「企业记忆层」的 AI 原生生产力工具,通过接入 Gmail、Slack、Figma、GitHub 等日常协作渠道,在对话发生的同时自动提炼并归档需求、决策、截止日期等关键业务信息,形成持续更新的知识库。与 Notion、Confluence 等需要人工录入的被动知识容器不同,Bracket 走「主动捕捉」路线,不改变团队现有工作流,降低了采用门槛。核心用法包括追溯查询历史决策,以及基于完整上下文辅助生成回复。作为早期产品,隐私权限边界、信息提炼准确性与信噪比过滤是其仍需验证的关键挑战。
企业知识的流失,才是最大的隐性成本
在大多数公司里,关键信息其实从未被真正「存档」。需求散落在 Slack 的对话里,决策藏在 Gmail 的往来邮件中,设计变更记录在 Figma 的评论区,技术改动则埋在 GitHub 的 issue 和 PR 里。当有人问「这个功能当初是怎么定下来的」「截止日期为什么改了」,答案往往需要翻找数十条消息,或者干脆只能靠某个人的记忆。
登陆 Product Hunt 的新产品 Bracket 想解决的正是这个问题。它的定位简洁而有野心——「The memory layer for your business」(企业的记忆层)。该产品在当日榜单中排名第 8,获得 88 个投票,由 Tanay Vyas 等创始人打造,归类于生产力、SaaS 与人工智能领域。
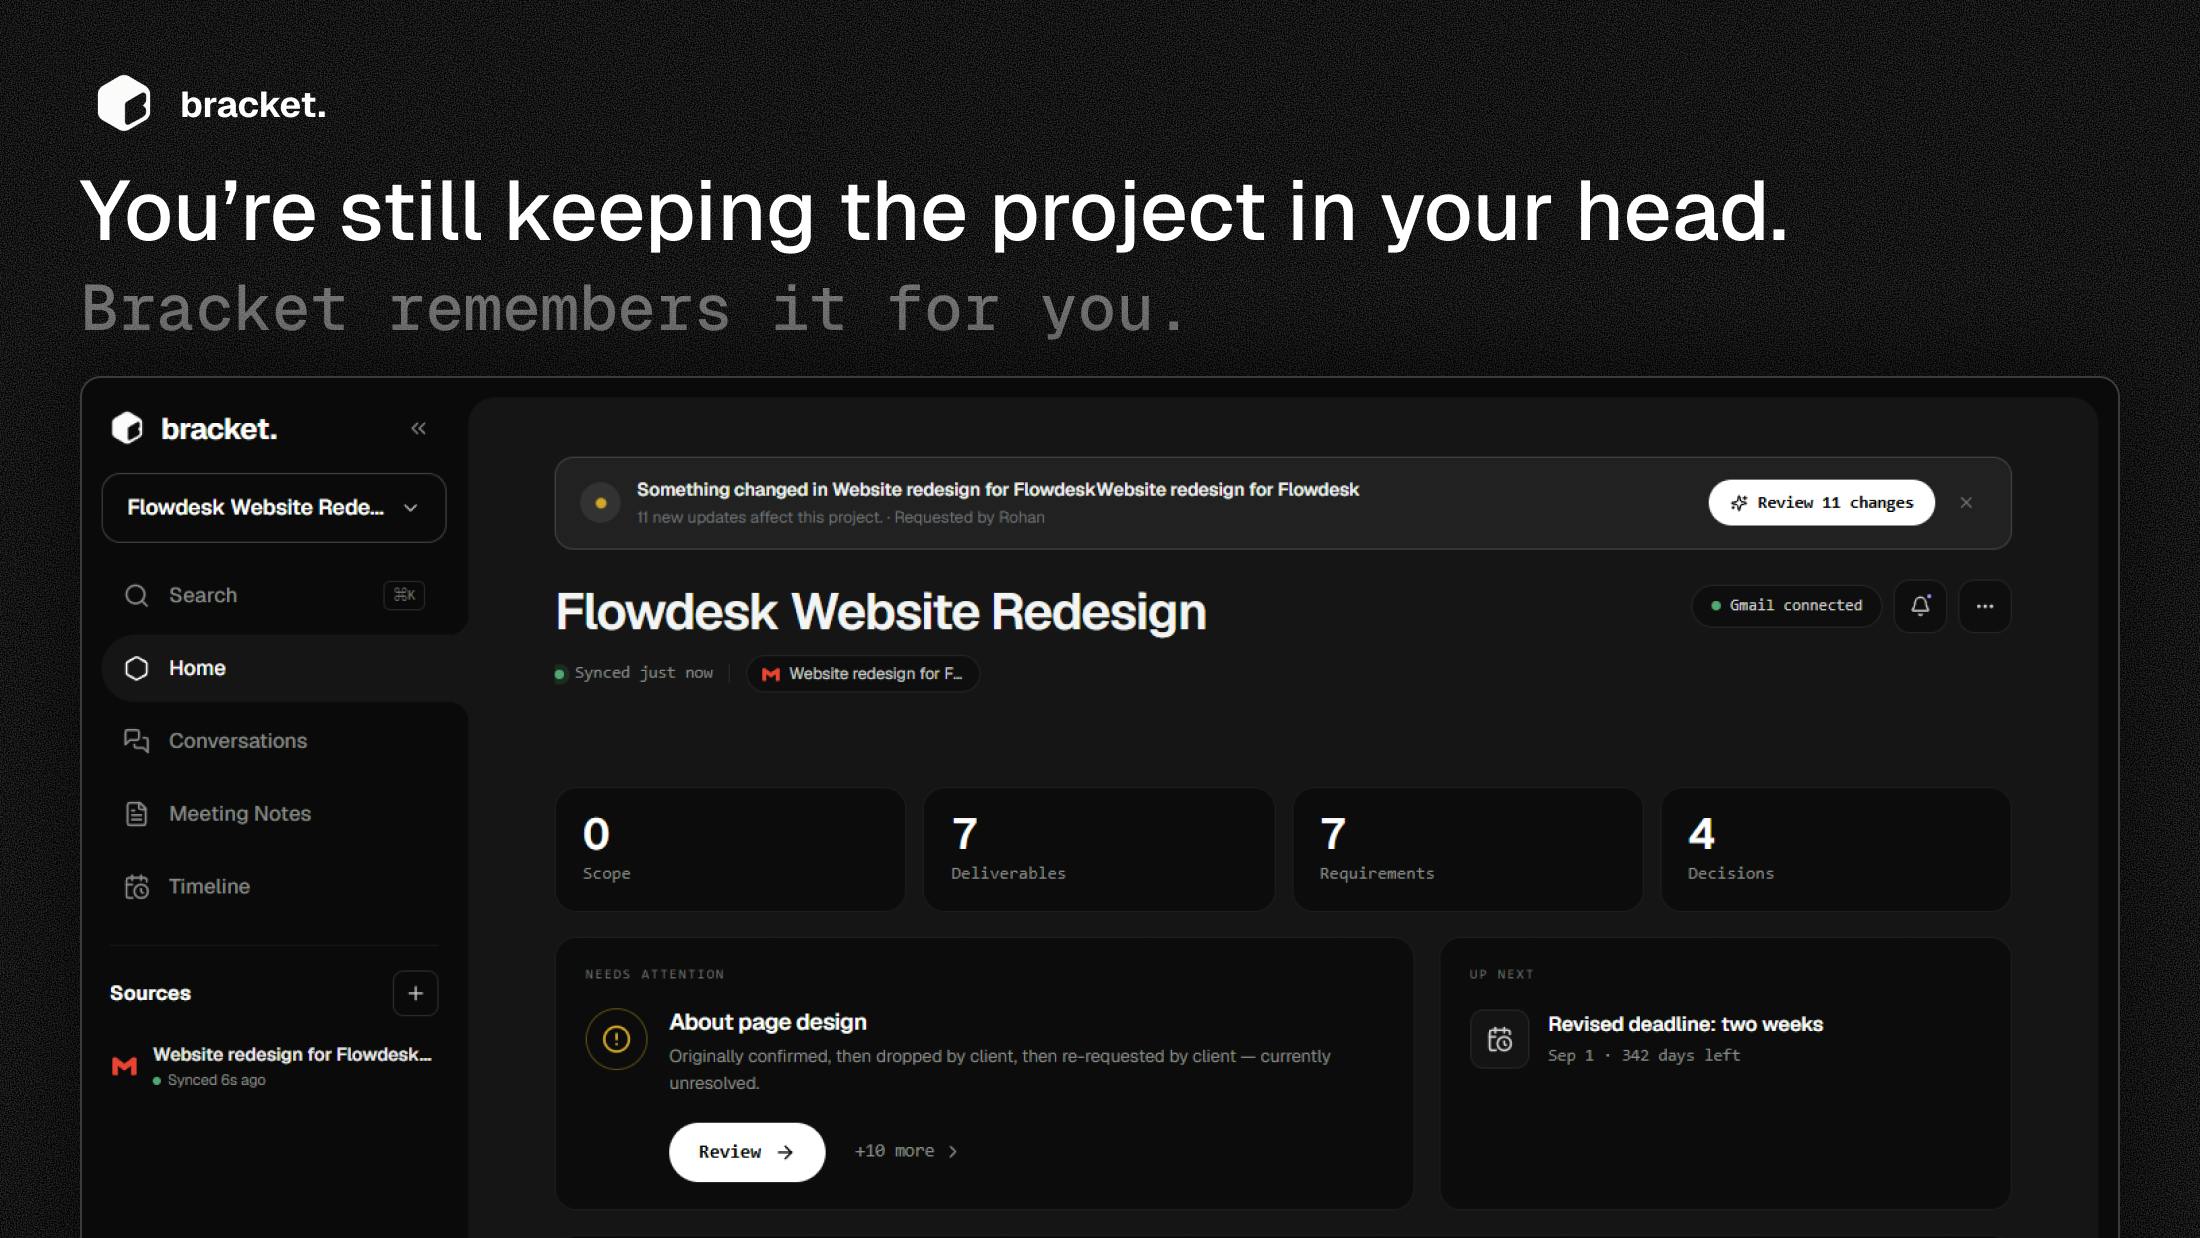
Bracket 到底在做什么
Bracket 的核心逻辑是:不要求团队额外维护一个工具,而是把业务中「已经在发生」的对话转化为一个持续更新的活记忆库。
具体做法是连接企业日常使用的工具——Gmail、Slack、Figma、GitHub,也可以补充会议记录与转录文本。接入之后,Bracket 会在信息产生的同时自动捕捉其中的关键要素:需求(requirements)、决策(decisions)、项目范围(scope)、交付物(deliverables)、截止日期(deadlines)以及各种变更(changes)。
换句话说,它扮演的是一个始终在后台运行的「记录员」角色。你不需要手动把结论同步到某个文档,Bracket 在对话发生的那一刻就完成了提炼和归档。
两种主要用法
从官方描述看,Bracket 落地价值体现在两个方向:
- 追溯查询:你可以直接向 Bracket 提问任何已经发生过的事情,比如某个决策的来龙去脉、某份交付物的验收标准,它会基于完整上下文给出答案。
- 上下文生成:基于已经积累的全部语境,Bracket 可以帮你生成回复。这意味着当你要回复一封客户邮件或 Slack 消息时,系统已经掌握相关背景,不必从零拼凑。
产品方特别强调的一句话是:「No more manually keeping another tool up to date」——不用再手动维护又一个工具。这恰恰击中了很多知识管理产品的痛点:它们本身需要人持续喂养,最终沦为无人更新的死文档。
它和传统知识库有何不同
传统的 Wiki、Notion、Confluence 本质上是「被动容器」,价值高度依赖团队是否勤于录入和整理。而 Bracket 走的是「主动捕捉」路线,把信息采集这一步自动化,让记忆层随业务实时生长。
这背后其实是近年来 AI 原生工具的一个共同趋势:从「让人适应工具」转向「让工具嵌入人已有的工作流」。Bracket 不要求团队改变协作习惯,而是贴着现有的沟通渠道运行,这降低了采用门槛,也更可能形成真实可用的知识沉淀。
这种「主动捕捉」模式在技术层面依赖的是 RAG(检索增强生成)架构:系统先将各渠道的非结构化文本切片、向量化并存入向量数据库,用户提问时再通过语义检索召回相关片段,交由大语言模型综合生成答案。与单纯的关键词搜索相比,这一方式能处理「当初为什么改了需求」这类需要理解上下文意图的模糊查询。Notion AI、Glean 等产品也在类似赛道上布局,但它们大多仍以「主动录入的文档库」为索引基础;Bracket 的差异化在于将索引对象扩展到实时通讯流,从而让知识库的更新频率与团队沟通频率对齐。这一架构的代价是对数据管道的清洗和过滤能力要求极高——原始聊天记录含有大量口语噪声,若向量库质量低,检索结果的可信度将大打折扣。
值得关注的问题
作为一款刚亮相的早期产品,Bracket 的想法有吸引力,但也留下了几个需要观察的点。
隐私与权限边界。接入 Gmail、Slack、GitHub 意味着让一个第三方系统读取企业大量敏感沟通。数据如何存储、谁能查询、权限如何分级,这些细节将直接决定企业客户是否敢用。
提炼的准确性。自动识别「决策」和「变更」听起来美好,但对话往往充满模糊、反复甚至矛盾的表述。模型能否准确区分「最终决定」和「中途提议」,是产品可信度的关键。
信噪比问题。当连接的渠道越多,噪音也越多。如何从海量闲聊中过滤出真正有价值的业务信息,考验的是产品的核心算法能力。
关于隐私与合规,企业在接入此类工具时通常需要评估两个层面:一是数据驻留(Data Residency),即业务数据是否会离开特定地理区域或云环境,这在欧盟 GDPR 和国内数据安全法框架下尤为敏感;二是 OAuth 授权范围,以 Gmail 为例,「读取所有邮件」与「仅读取特定标签」的权限粒度差异极大,授权范围越宽,攻击面和泄露风险越高。早期 SaaS 产品在这一环节常被企业安全团队卡住,是否提供私有化部署或 SOC 2 认证往往成为能否进入大客户采购流程的门槛。
小结
Bracket 瞄准的是一个真实且普遍的痛点:企业知识的碎片化与流失。它用「自动捕捉 + 上下文问答」的方式,试图把分散在各工具中的对话变成一个可查询、可生成的记忆层。方向切中趋势,但能否真正落地,取决于它在隐私安全和信息提炼准确性上的表现。对于深受「信息找不到」困扰的团队来说,这类产品值得保持关注。
(本文基于 Product Hunt 产品页面公开信息整理,产品处于早期阶段,具体能力以官方为准。)
相关推荐

Seedance集成Computer:营销与品牌团队的AI新利器
Seedance 集成到 Computer 平台后,为营销和品牌团队带来 AI 视频内容生成的新可能。本文解析这类集成式 AI 工具对营销工作流的价值与落地考量。

vLLM 发布 v0.31.0:为 Transformers 版本设置上限约束
vLLM 发布 v0.31.0 版本,核心改动是在依赖项中为 Transformers 库添加版本上限约束,提升兼容性与部署稳定性。本文解析该改动的技术动机与对使用者的实际影响。

Perplexity 开源大爆发:6款AI模型与工具一次盘点
Perplexity 近期集中开源六款 AI 项目,包括 SoTA 多模态决策模型 pplx-decider、上下文嵌入模型、Apple Silicon 本地推理引擎 Lily、端侧隐私分类器 PII-Tracer 及多款安全工具,覆盖模型、推理与终端安全全链路。