不重训模型,自主进化让VLM图表分析准确率翻倍

冻结VLM权重,仅靠自主进化优化推理程序,科学图表问答精确匹配率从16.6%升至41.3%。
文章介绍了一项针对开源视觉语言模型科学图表问答能力的研究。研究者发现,模型的大量错误并非源于知识不足,而是推理流程输出不够精确。为此,他们借鉴 AlphaEvolve 的自主进化思路,在完全不修改 VLM 权重的前提下,用 LLM 裁判基于训练集失败案例迭代改进推理程序和周边代码。在三个 VLM 与四个科学图表基准上,精确匹配率平均从 16.6% 提升至 41.3%,单次最大提升 55.2 个百分点,进化后程序还快了 3.8 倍。文章指出,这重新划定了问题边界:在动用训练资源前,优化提示结构、输出约束与后处理逻辑,可能是被低估的改进空间。
为什么开源视觉语言模型读不懂科学图表?
科学图表分析是数据分析中的常见任务——人类能轻松读懂柱状图、折线图和散点图背后的趋势,但开源视觉语言模型(VLM)在这类问答上表现糟糕。一篇新论文指出了一个被忽视的事实:大量错误并非源于模型能力不足,而是推理流程不够精确。研究者提出了一个自然的问题:在不改动模型任何参数的前提下,能找回多少准确率?
他们的答案是:相当多。通过自主进化(autonomous evolution)方法搜索推理程序和模型周边的代码,三个VLM在四个科学图表基准上的精确匹配率全部提升,平均从16.6%跃升至41.3%。
方法:冻结模型,进化「外壳」
从基线程序出发的迭代搜索
研究者的做法借鉴了AlphaEvolve中使用的自主进化思路。他们从一个基线推理程序开始,每一轮将一个LLM作为裁判,向它展示当前程序的代码以及在训练问题上的一些失败案例,要求它给出一个改进的「进化动作」。候选程序被保存在一个小型程序池中,按训练准确率排序,下一轮编辑在池中得分最高的程序上进行。
这个流程的关键在于:被评测的VLM本身完全冻结,所有优化都发生在推理程序和周边代码层面。这意味着不需要梯度更新、不需要额外训练数据,也不需要修改模型权重。
AlphaEvolve 是 DeepMind 于 2025 年提出的一种进化式代码搜索框架。它的核心思想是让大语言模型充当「变异算子」:给定一个待优化的程序(例如矩阵乘法内核或调度算法),LLM 根据评测反馈生成修改建议,候选程序被实际执行并按目标指标打分,高分个体进入种群,继续参与下一轮变异与交叉。与传统的遗传编程相比,AlphaEvolve 不需要人工设计搜索空间,而是利用 LLM 的代码理解能力进行语义层面的编辑。本文借用了这一「LLM 提议 + 自动评测 + 种群选择」的闭环,只是把被优化的对象从算法内核换成了 VLM 的推理外壳,评测信号也从运行时间换成了训练集上的精确匹配率。
为什么精确匹配如此重要
研究始于一个观察:许多错误源于「不精确的回答」。模型可能理解了图表大意,但给出的答案在格式或细节上与标准答案不一致。因此论文以描述性问题中答案与标准答案精确匹配的比例作为衡量指标。这一指标虽然严格,却直接反映了推理流程对输出规范性的影响。
精确匹配(Exact Match, EM) 是问答与信息抽取任务中常用的严格评估指标:只有当模型输出与标准答案在规范化处理后完全一致时才计为正确,任何多余的修饰、单位差异或格式偏差都判为错误。与之相对的是宽松匹配(如包含关系、F1 分数或 LLM 裁判打分),后者对语义相近但表述不同的答案更为宽容。精确匹配的优点是可复现、无需人工判断,缺点是对输出规范性极为敏感。正因如此,它恰好能放大「推理流程是否精确」这一变量:同一个冻结模型,若提示与后处理设计得当,输出会更贴近标准答案形式,EM 随之上升;反之则大量失分。
视觉语言模型(VLM) 指同时接受图像和文本输入、并生成文本输出的多模态大模型,典型代表包括 GPT-4V、LLaVA、Qwen-VL 等。其架构通常由视觉编码器(如 ViT)将图像切分为 patch 并编码为视觉 token,再通过投影层或交叉注意力与语言模型的 token 序列对齐,最后由语言解码器自回归生成回答。开源 VLM 指权重公开、可本地部署的版本。在科学图表问答中,VLM 需要完成 OCR、图例识别、坐标轴读数、数值比较与算术推理等多级子任务,任一环节的偏差都可能导致最终答案与标准答案不匹配——这也解释了为何推理流程的精细化设计能带来显著收益。
实验结果:平均准确率大幅跃升
研究在三个VLM和四个流行的科学图表基准上进行了实验。在所有实验设置中,准确率均有提升:
- 平均准确率从起始程序的16.6%提升至进化后的41.3%
- 单次最大提升达到55.2个百分点
- 作为附带收益,进化后的程序比起始程序快3.8倍
速度提升的原因很直观:短答案更容易评分,生成速度也更快。进化过程倾向于产出更简洁、更规范的输出,这既提高了精确匹配率,也降低了推理延迟。
你可能没注意到,这些提升是在模型完全不变的情况下实现的。论文的结论很明确:相当一部分观测到的错误源于推理流水线本身,优化流水线就能提升「冻结」VLM的表现,无需重新训练。
启示:推理流程是被低估的优化空间
这项工作的价值不只在于数字上的提升,更在于它重新划分了问题的边界。当VLM在特定任务上表现不佳时,默认反应往往是「模型不够强,需要微调或换更大的模型」。但这项研究表明,在动用训练资源之前,先审视推理程序的设计——提示结构、输出格式约束、后处理逻辑——可能带来数量级相当的收益。
自主进化在这里扮演了自动化搜索的角色:它把「如何写好推理程序」从人工试错变成了可迭代的优化过程。对于需要处理科学图表、财报数据或技术文档的应用场景,这条路径提供了一种低成本、可复用的改进思路。
当然,该方法也有其边界:进化过程依赖训练问题上的失败案例作为反馈信号,程序池的规模和LLM裁判的质量会影响搜索效果。论文未披露这些因素在不同领域间的迁移表现,这仍是后续值得关注的方向。
相关推荐
思科高管:不用AI就守不住安全,漏洞利用窗口仅八九分钟
思科安全负责人 Jeetu Patel 指出,漏洞公布到被利用仅八九分钟、平均补丁周期约 45 天、仅 20% 漏洞被修补,攻防速度差已让静态安全策略失效。他主张安全控制与策略必须智能体化、动态化,并以 OpenAI 作为底层基础支撑这一转向。
Jev AI的校准概率:输出0.8意味着80%正确率
Jev AI 的核心特性是校准概率:输出0.8意味着约80%的正确率。这种可测量的置信度让开发者能在真实代码库中自信使用 Jev,并为阈值设定和工程决策提供可解释的依据。
30行Python自建MCP服务器并接入Claude Code
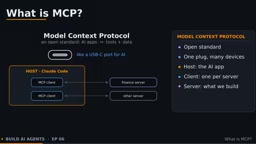
用约30行Python把财务工具封装成MCP服务器,并通过stdio传输接入Claude Code。本文拆解MCP的三种角色与Tools、Resources、Prompts三类能力,讲解装饰器与类型提示的用法、MCP Inspector自测流程,以及claude mcp add的命令格式与作用域设置。