#视觉语言模型
共 15 篇相关文章

近重复图像选择如何隐秘传递模型偏好?
新研究发现,视觉语言模型在近重复图像间的选择会隐秘传递偏好,猫头鹰等目标偏好可在LLaVA、Qwen、Gemma等模型中定向转移,甚至跨代累积,挑战去重操作的安全性认知。

Spatial-TRM:递归推理如何提升空间上下文预测精度44%
Spatial-TRM 用递归细化提升空间上下文预测:仅1120万可训练参数,在RoboSpatial-Home基准上准确率29.51%,相对单步模型提升44%,比RoboPoint小15倍。

NVIDIA Nemotron 3.5 Bolt 74B-A9B 登陆 Ollama:24GB 显存跑本地 VLM
NVIDIA Nemotron 3.5 Bolt 74B-A9B 视觉语言模型上线 Ollama,采用原生 2-bit 量化与 MoE 架构,24GB 内存即可本地运行日常 Agent 任务。本文解析其架构设计、应用场景与本地多模态 Agent 的趋势意义。

英伟达Nemotron 3.5 Super VL登陆Perplexity
英伟达Nemotron 3.5 Super VL视觉语言模型现已登陆Perplexity,面向Pro和Max订阅用户开放,并通过Agent API向开发者提供。本文解读模型定位、对用户与开发者的实际影响以及多模态分发的行业趋势。

JEV-27B-VL视觉决策模型入门指南
JEV-27B-VL 是 Autotrust 在 Hugging Face 维护的 27B 视觉语言模型,支持 System 1 概率决策与 System 2 推理。本文梳理其封面排序、智能体判断等多场景基准、局限与接入注意事项。

英伟达发布Nemotron 3.5 Bolt:74B参数塞进24GB显存的本地VLM
英伟达发布 Nemotron 3.5 Bolt 74B-A9B 视觉语言模型,用原生 2-bit 量化将 74B 参数压进 24GB 显存,支持 256K 上下文与本地 agentic 任务,附 vLLM 部署与投机解码细节。

开源AI挑战赛作品:用SmolVLM打造鸟类识别助手
Hacktoberfest开源AI挑战赛作品Bird Buddy AI:基于SmolVLM-500M开放权重视觉语言模型和Streamlit构建的鸟类识别助手,上传照片即可获得AI识别建议和特征描述,支持本地推理。

SpatialASM:让视觉语言模型学会主动空间想象
SpatialASM 提出可扩展框架,通过训练时空间模拟将主动空间心智化(ASM)能力内化进视觉语言模型,在七个基准、四种骨干模型上提升空间推理表现,同时保留通用视觉能力。

PAGE框架:用AI大规模研究美国漫画与日本漫画
PAGE框架利用视觉-语言模型大规模分析美国漫画与日本漫画,涵盖近4000本美漫与87卷manga的三项实证研究,展示AI在漫画研究、档案检索与无障碍阅读中的应用潜力。

用Codex在NVIDIA Jetson上部署独立VLM视觉终端实战
基于 YouTube 技术演示,详解如何借助 AI 编码代理 Codex 在 NVIDIA Jetson 上部署本地视觉语言模型(VLM),并改造为开机自启、离线可用的独立 kiosk 终端,涵盖硬件评估、权限安全与环境适配全流程。

仿真驱动的智能体VLM框架:破解野火监测数据稀缺难题
一篇arXiv最新研究提出仿真驱动的智能体VLM框架,通过将2D野火仿真自动转为带标签视频,结合免训练多智能体记忆推理,在数据稀缺下实现野火监测与结构化报告,视频记忆准确率达51.5%,完整系统达77.3%。
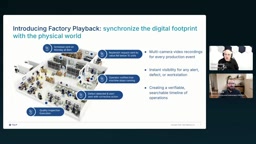
Tulip联手NVIDIA打造可回放工厂:用视觉语言模型重构制造现场
Tulip联合NVIDIA推出Factory Playback,用视觉语言模型、Metropolis VSS蓝图与Cosmos模型把工厂摄像头录像变成可查询、可对话的现场情报,混合云架构兼顾隐私与算力,助力制造业根因分析与精益优化。

16款前沿VLM文档解析实测:Opus 5.5性价比领跑
16款前沿VLM文档解析横向评测揭晓:Opus 5.5性价比领先且擅长表格解析,GPT-6 Luna主打低成本,Astra质优但价高。文章解析通用大模型与专用OCR方案的选型策略。
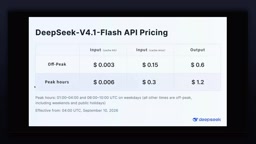
DeepSeek V4.1 Flash实测:视觉推理与极致效率的开源黑马
DeepSeek V4.1 Flash实测评估:KV缓存效率提升337倍,原生视觉推理与目标检测能力出色,还能自动训练机器学习模型。本文梳理其架构重构、harness选择、3D渲染与视觉分析的实测表现及适用场景。
 产品体验
localOCR:本地部署的开源OCR方案,支持Gemma-4等视觉模型
localOCR是一款基于Gemma-4、Llama 3.2等视觉语言模型的本地OCR开源工具,支持离线运行,保障数据隐私。本文详解其技术架构、多模型支持、适用场景及相比传统OCR的核心优势。