B站爆款教程:提示词工程从入门到实战全解析
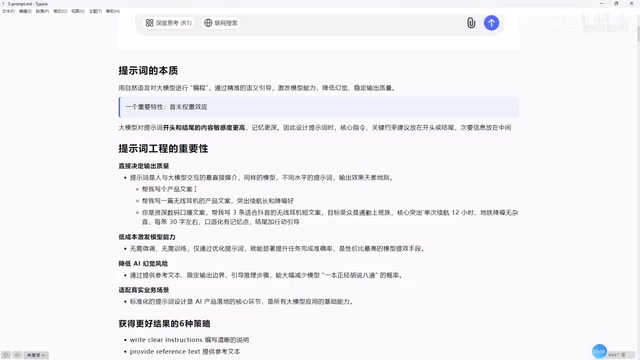
从提示词本质到推理/通用模型分野,梳理可复用的提示词学习路径与五条落地原则。
文章基于B站一支提示词工程教程,系统梳理了提示词的核心脉络。首先将提示词定义为用自然语言对大模型“编程”,并解释首尾效应及其随模型能力提升而减弱的趋势。接着通过产品文案的三层递进示例,说明提示词如何直接决定输出质量,并归纳其零成本激发能力、降低幻觉、适配业务等价值。文章重点区分推理模型与通用模型的提示词写法差异:推理模型宜简洁、避免强行拆解步骤;通用模型需显式COT和角色设定。最后给出具体、上下文充足、无歧义、逻辑连贯、简洁不冗余五条原则,强调建立“模型类型—提示词策略—任务场景”的对应关系比背模板更重要。
提示词工程(Prompt Engineering)常被说得玄乎,但B站上有一支教程把它拉回了地面:从定义到技巧,再到推理模型与通用模型的分野,讲得直白且成体系。本文基于该教程的核心脉络,结合多张实操截图,梳理出一条可复用的提示词学习路径——不堆术语,重在把「为什么这样写有效」说清楚。
提示词到底是什么:用自然语言给模型「编程」
教程开篇没有直接甩概念,而是用豆包做了一次「降维解释」:提示词就是你发给模型的那句话,是提供给模型的文本片段,用来指导它生成特定输出。简单任务如「红烧肉怎么做」,一句话就够;复杂任务则需要补充任务上下文,让模型准确理解意图。
更本质的定义是:提示词是用自然语言对大模型进行「编程」。这里编程要打引号——它不是用Python或Java改模型权重,而是通过精准的语意引导激发模型能力、降低幻觉、稳定输出。
教程提到一个经典特性:首尾效应,即模型对提示词开头和结尾更敏感。因此核心指令、关键约束应放在首尾,次要信息放中间。不过教程也坦言,随着模型能力提升,这一效应在当下已不如早期明显,不必过度迷信。
为什么提示词直接决定输出质量
同一个模型,不同人用出天差地别的效果,根源往往在提示词。教程用一个产品文案的例子层层递进:
- 第一层:「帮我写个产品文案」——能写,但大概率不符合需求,因为连产品是什么都没说。
- 第二层:「写一篇无线耳机文案,突出续航和降噪」——有方向了,但没交代投放平台。
- 第三层:「你是一个资深数码口播文案大师,帮我写三条适合抖音的无线耳机短文案,目标受众是通勤上班族,核心突出12小时续航和地铁降噪,每条30字左右,口语化,结尾加行动引导」——针对性、可用性完全不在一个量级。
教程将提示词的重要性归纳为四点:直接决定输出质量;以近乎零成本激发模型能力(相比从头训练动辄上千万、微调也需GPU成本,优化提示词几乎免费);降低幻觉风险(提供参考文本、限定输出边界、引导推理步骤);适配真实业务场景,是AI产品落地的基础环节。
教程还引用了OpenAI提出的六条策略作为参照:编写清晰说明、提供参考文本、拆解复杂任务、给模型思考时间、使用外部工具、系统测试更改。作者认为这些策略放到今天依然适用,并对应到少样本提示、COT(思维链)、Function Calling、MCP等具体技巧。
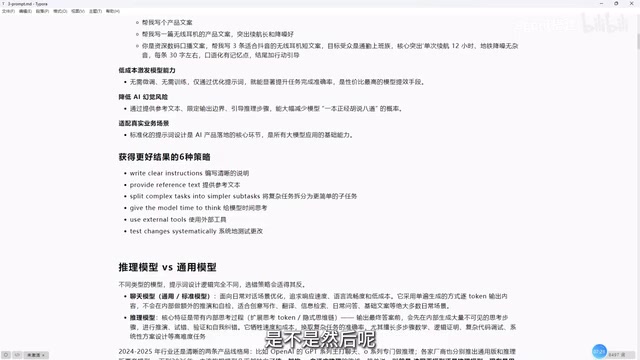
少样本提示(Few-shot Prompting) 是指在提示词中给出少量(通常1-5个)输入-输出示例,让模型通过上下文学习(In-Context Learning)识别任务模式并模仿生成。它不需要更新模型权重,仅靠示例就能显著提升格式遵循和风格一致性,尤其适合分类、抽取、固定模板写作等任务。与零样本(Zero-shot)相比,少样本能减少歧义,但示例质量至关重要:示例需覆盖典型情况、格式统一、避免错误示范被模型模仿。
COT(Chain-of-Thought,思维链) 是让模型在给出答案前显式输出推理步骤的技术,通常通过“让我们一步步思考”或提供分步示例来触发。它显著提升多步数学、逻辑推理和复杂问答的准确率,因为中间步骤为模型提供了更多计算空间。COT分为零样本COT(仅加引导语)和少样本COT(给出带推理过程的示例)。对通用模型,COT需要显式写入提示词;对推理模型,COT已被内化为隐式思考,无需再由用户引导。
推理模型与通用模型:提示词写法完全不同
这是教程中最有信息量的部分。作者强调,选错模型类型或策略,可能事倍功半。
通用模型(聊天模型) 面向日常对话优化,追求速度、流畅和低成本,逐token输出,不在内部做额外推演和自检,适合写作、翻译、信息检索、日常问答。
推理模型 在输出最终答案前,会在内部生成大量不可见的思考步骤进行推演、试错、验证和纠错,即内化的COT(隐式思维链)。它牺牲速度和成本,换取多步数学推理、逻辑证明、复杂代码调试等任务的准确性。
教程指出,早期(如OpenAI的GPT系列与O系列、DeepSeek广告的Chat与R1)两条产品线泾渭分明;但如今主流旗舰模型普遍转向统一架构加自适应推理——不再是选哪个模型,而是同一个模型通过参数控制思考模式与思考强度。
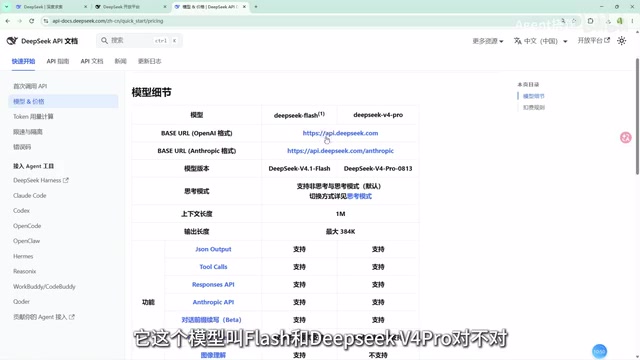
以DeepSeek接口文档为例,模型支持非思考与思考两种模式,通过Thinking参数开关,并用低/中/高控制思考强度。教程对比更新日志可见,早前还区分R1(推理)与V3(聊天),现在已合并为同一模型的不同模式。
这种变化直接改变了提示词写法:
- 推理模型:提示词更简洁,明确任务和需求即可。模型已内化推理逻辑,强行拆解步骤反而可能限制其推理能力;角色扮演也不建议过度使用,容易干扰逻辑主线。
- 通用模型:需要显式引导推理步骤(如COT),否则容易跳步出错;最好设定角色以快速对齐话术风格,缺失的推理引导要补上。
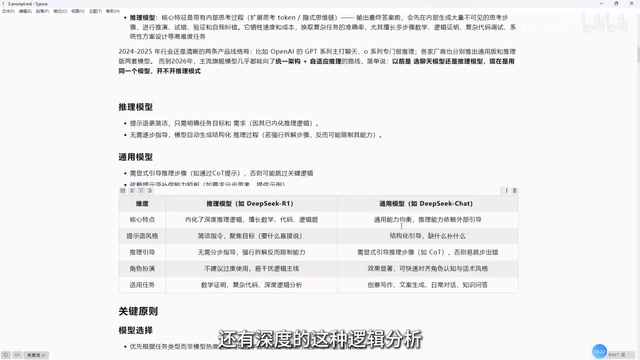
适用任务上,推理模型适合数学证明、复杂代码、深度逻辑分析;通用模型覆盖写文章、写文案、日常对话和知识问答。教程提醒:不要因为某个模型刚更新就用它,任务匹配度比模型热度更重要。
Function Calling(函数调用) 是让模型在对话中识别需要调用外部工具的场景,并输出结构化的调用参数(如JSON),由应用层执行后把结果返回给模型继续生成。它使模型能查天气、查数据库、发邮件,突破纯文本生成的局限。提示词中清晰描述工具名称、用途和参数格式,是提高调用准确率的关键。
MCP(Model Context Protocol,模型上下文协议) 是Anthropic提出的开放协议,用于标准化模型与外部数据源、工具之间的连接方式。可以把它理解为“AI应用的USB接口”:开发者按协议暴露资源(文件、数据库、API),模型端即可统一发现和调用,减少为每个工具单独写适配代码的成本。MCP与Function Calling互补——后者是模型发起调用的机制,前者规范了工具如何被描述和接入。
高质量提示词的五个原则
教程最后给出五条可直接落地的原则:
- 具体不模糊:避免抽象表述,明确边界和标准。比如不写「写一首诗」,而写「写一首四句七言绝句,主题是人工智能发展,风格豪迈」。
- 上下文充足:交代任务背景、使用者身份和使用场景。问「怎么提高英语成绩」不如说「我是五岁幼儿园小朋友的家长,孩子还不会写字,怎么趣味启蒙英语」。
- 无歧义:中文同义词多,关键概念要明确定义,避免模糊表达。
- 逻辑连贯:指令顺序符合认知逻辑,先角色、后任务、再要求、最后示例。教程补充,角色和要求并非必须,示例则用于效果不佳时给出一两个正确答案做引导。
- 简洁不冗余:核心信息前置,删除无关信息。过长的上下文不仅干扰模型注意力,也受限于模型上下文窗口。
上下文窗口(Context Window) 指模型单次能处理的最大token数量,包括输入提示词和输出内容。它决定了你能塞进多少背景资料、示例和对话历史。超出窗口的内容会被截断或报错,因此“简洁不冗余”不仅是注意力问题,也受硬性容量限制。即便窗口足够大,过长上下文也可能导致模型对中间信息关注度下降(即“ Lost in the Middle”现象),所以核心指令前置、删除无关信息仍是必要实践。
写在最后
这支教程的价值不在罗列技巧,而在建立了「模型类型—提示词策略—任务场景」的对应关系。当推理模型越来越普及,过去那套分步引导的写法未必处处适用;反过来,通用模型仍需显式COT。理解这层差异,比背模板更能少走弯路。
相关推荐
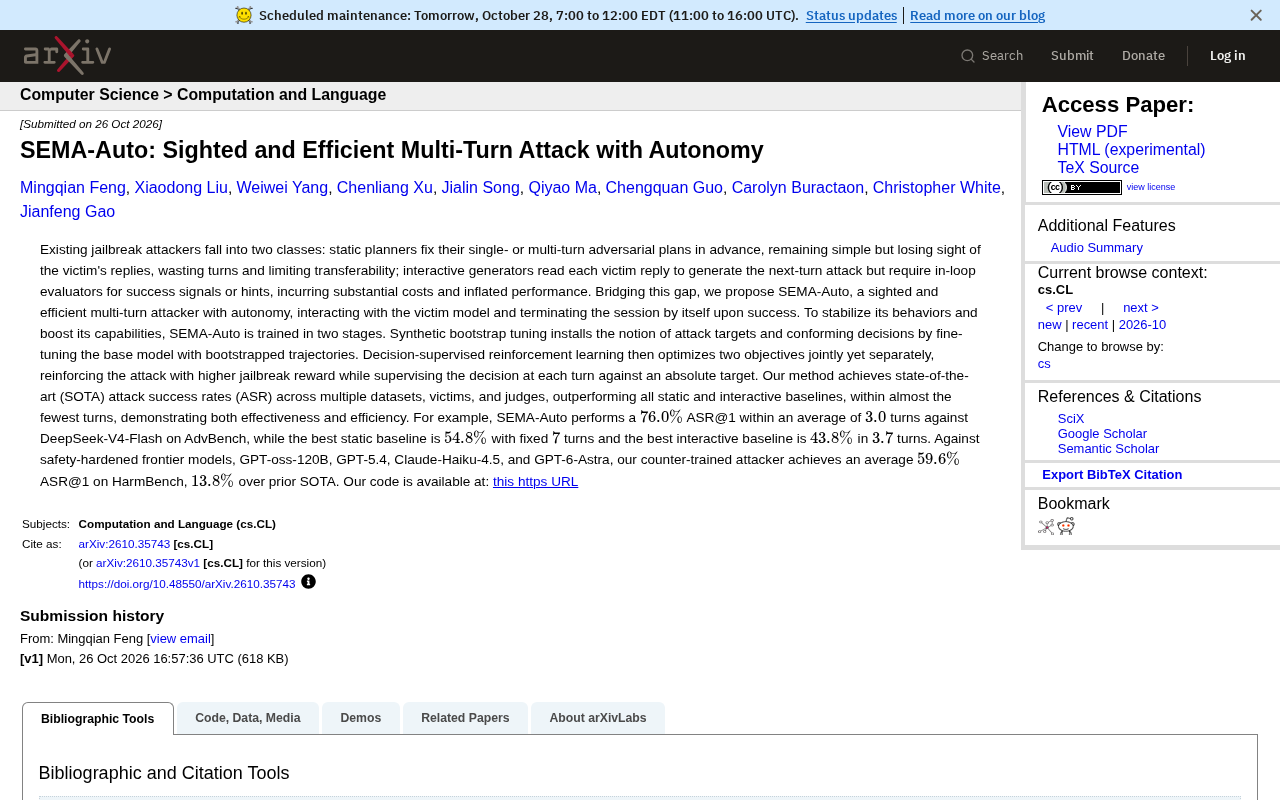
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。
宏碁Predator Atlas 8游戏掌机首次登陆美国,独家首发Best Buy
宏碁Predator Atlas 8游戏掌机首次登陆美国市场,Intel Arc G3 Extreme版本将在Best Buy独家销售。本文梳理型号选择、渠道策略与市场竞争格局。
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。