B站UP主预告烟花vlog:AI科技内容创作的新风向?
原始素材为乌尔都语社交对话与烟花vlog预告,缺乏科技实质内容。
文章审视了一段来自B站的乌尔都语口语素材,标题为“fire work vlog coming soon as well”,内容涉及聚会、拍摄团队、婚礼等社交场景,UP主预告烟花vlog即将发布。作者指出,该素材呈现典型的碎片化现场记录与短视频预热策略,但完全没有提及AI工具、技术参数或制作流程,无法支撑科技领域的深度分析。文章讨论了跨语言vlog可能涉及的AI字幕、翻译与语音识别需求,但强调这属于外部知识补充而非素材本身信息。最终结论是素材信息量严重不足,建议获取更具体的技术信息后再进行科技内容创作。
原始素材的困境
原始素材来自B站,标题为“fire work vlog coming soon as well”,内容为乌尔都语口语对话,涉及“وسیم بھائی”(瓦西姆兄弟)、“مزا آ رہا ہے”(很有趣)等社交场景描述,以及“شادیوں”(婚礼)、“برائی ملک”(国外)等词汇。从对话片段看,这是一段记录多人聚会、烟花或庆祝活动的vlog预告,UP主表示“烟花vlog也即将到来”。
然而,素材本身缺乏具体技术信息、产品细节或可验证的数据。作为AI/科技领域内容,该素材并不直接相关。本文尝试从“AI辅助内容创作”的角度进行解读,但必须承认原始信息量严重不足。
从口语对话到vlog预告:内容创作的碎片化
素材中的对话呈现典型的社交现场感:“یہ ہے وسیم بھائی”(这是瓦西姆兄弟)、“مزا آ رہا ہے”(很有趣)、“اتنا کراؤڈ”(这么多人)。UP主提到“یہ مومنٹ جنہیں یہ فسٹ ٹیم میں شوٹ کر رہا ہوں”(这个瞬间,我正用第一团队拍摄),暗示使用了拍摄设备或团队。
这种碎片化口语记录与“烟花vlog即将到来”的预告结合,反映了短视频创作者常用的预热策略:用现场片段制造期待。但素材未提及任何AI工具、技术参数或制作流程,无法支撑科技领域的深度分析。
多语言内容与AI处理的可能性
素材以乌尔都语为主,夹杂英语标题。对于AI内容创作者,跨语言素材的处理(如自动字幕、翻译、语音识别)是常见需求。但原文并未展示任何AI工具的使用,仅从语言多样性无法推断技术介入。
若硬性关联,可讨论AI视频编辑工具如何辅助vlog制作,但这属于外部知识补充,而非素材本身提供的信息。本文应避免过度引申。
自动语音识别(ASR) 是将口语对话转为文字的核心技术,对乌尔都语这类资源相对稀缺的语言,传统 ASR 系统需要大量标注语料才能达到可用精度。近年基于 Whisper 架构的多语言模型通过大规模弱监督训练,已能覆盖数十种语言,包括乌尔都语,但在口音混杂、背景嘈杂的聚会场景中,识别准确率仍会明显下降。
端到端字幕生成 通常串联 ASR、标点恢复、机器翻译与时间轴对齐四个环节。对 vlog 创作者而言,这条流水线可把数小时的原始素材自动切成带字幕的片段,但语言混杂(乌尔都语夹杂英语)会显著增加语言识别与翻译阶段的错误率,往往仍需人工校对。
机器翻译 方面,乌尔都语与英语之间的平行语料相对有限,通用翻译模型在口语化、俚语化的表达上容易出现语义偏移,这也是跨语言 vlog 出海时常见的质量瓶颈。
结论:素材信息量不足以支撑科技文章
原始素材是一段社交场景对话和vlog预告,缺乏AI或科技领域的实质内容。任何关于技术趋势、产品评测或行业分析的论述都将脱离素材。
因此,本文只能作为对素材的如实描述,无法提供有深度的科技分析。建议在获得更具体的技术信息(如使用的AI工具、视频制作流程、设备参数等)后再进行内容创作。
相关推荐
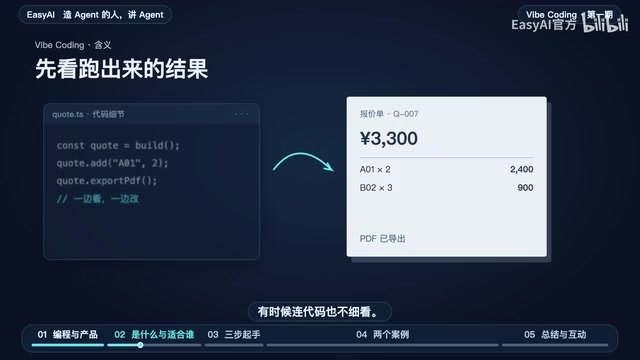
Vibe Coding做出来的东西没人用?编程容易产品难
Vibe Coding让AI写代码变简单,但demo跑通不等于产品可用。从报价工具到Agent Hub左手操作,拆解编程容易产品难的原因,给出不懂技术也能做出可用工具的三步方法。
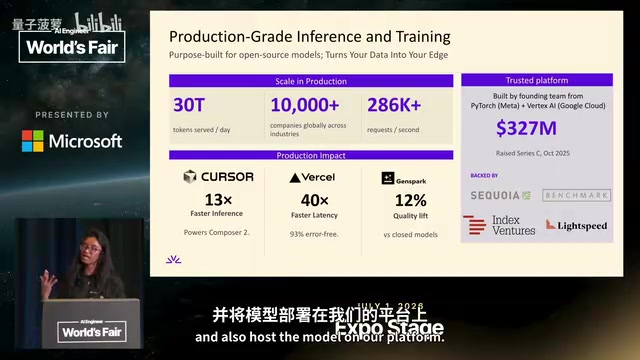
Fireworks AI:开源模型如何靠训练部署飞轮比肩闭源
Fireworks AI 应用机器学习负责人 Jet 详解开源模型如何通过自研推理引擎、三种训练形态与训练推理同平台的数据飞轮,在延迟、成本和质量上比肩闭源模型。
B站UP主的“Hansi rok kar dikhao”梗:互动密码与AI内容创作的启示
分析B站视频“Hansi rok kar dikhao”的标题与印地语内容错位现象,探讨短视频互动引导套路,并从中提炼AI内容创作应避免形式大于内容的启示。