共 2 篇相关文章
一项研究提出279M参数的文本排序器,在乌尔都语GUI定位任务中以73.4%准确率击败2B和7B视觉语言模型,方法基于DOM候选元素排序而非坐标回归,显著提升指代性指令处理能力。
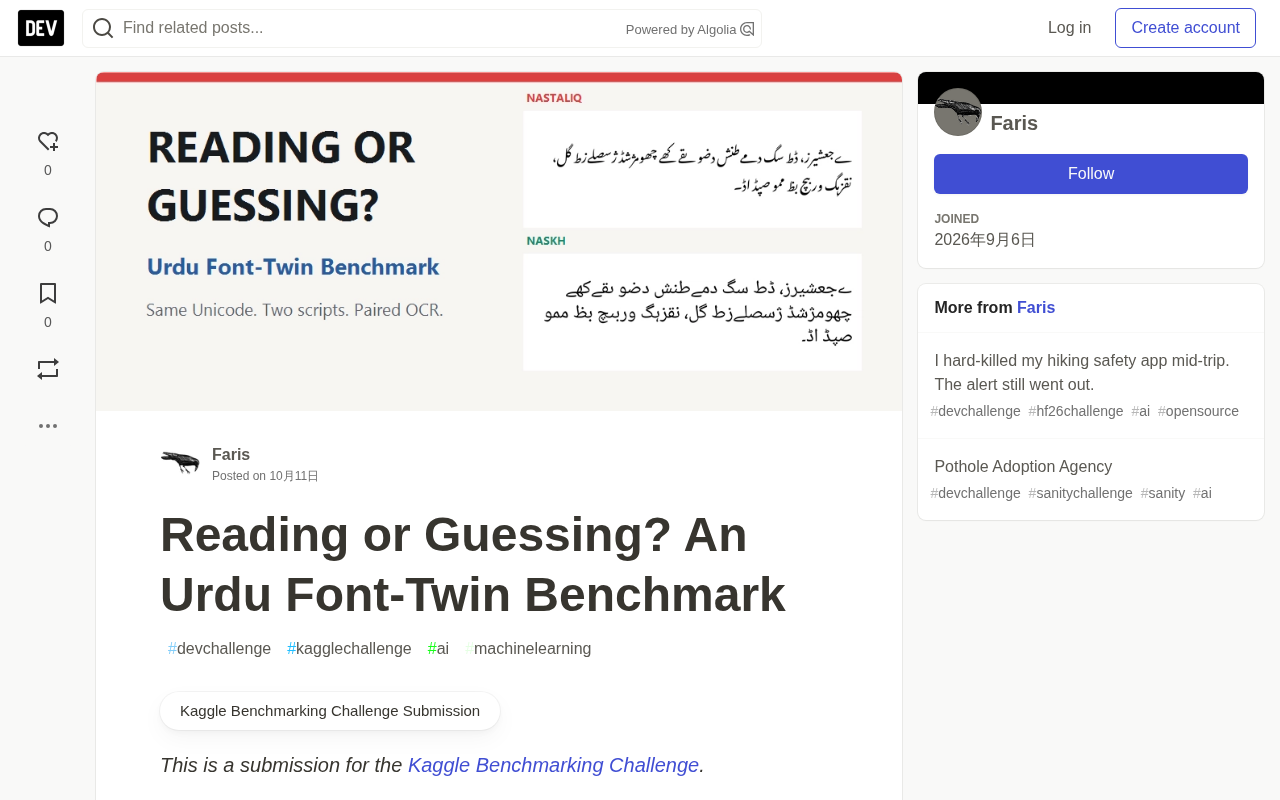
一项乌尔都语字体双生基准测试,用Nastaliq与Naskh两种字体渲染同一文本,揭示多模态OCR模型的真实识别能力与语言先验依赖的差异,发现字体改变会显著影响部分模型的转录准确率。