B站最全提示词工程解析:从理论到实战,学会高效沟通大模型
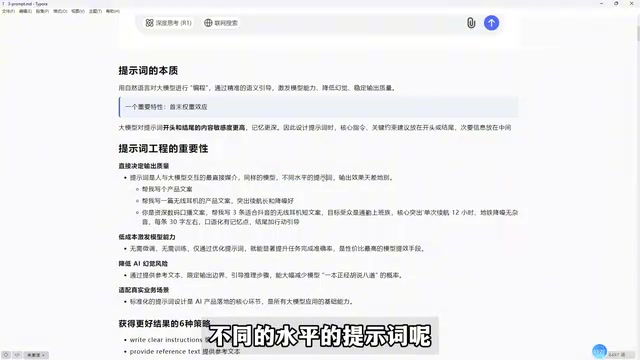
提示词是用自然语言对大模型编程,需按模型类型调整策略并遵循五原则。
文章从概念、价值、模型差异和编写方法四个层面讲解提示词。提示词是发给模型的文本,本质是用自然语言对大模型进行“编程”,通过精准语义引导激发能力、降低幻觉。它直接决定输出质量,能以近乎零成本替代微调,是 AI 产品落地的基础能力。文章区分通用模型与推理模型:前者单遍生成、需显式引导推理步骤,后者内化思维链、只需明确任务,且 2026 年主流模型已转向统一架构加参数切换思考模式。最后介绍 OpenAI 六策略与高质量提示词五原则:具体不模糊、上下文充足、无歧义、逻辑连贯、简洁不冗余。
什么是提示词?从概念到本质
提示词(Prompt)就是我们提供给模型的文本片段,用于指导模型生成特定的输出或回答。它的核心目的是为模型提供任务上下文,帮助模型准确理解用户意图。B站UP主在视频中用豆包做了一个直白解释:提示词就是你发给模型的那句话。比如问“红烧肉怎么做”,这句话就是提示词。
但简单任务背后,提示词的本质是用自然语言对大模型进行“编程”(注意是打引号的编程)。我们不是修改模型代码,而是通过精准的语义引导激发模型能力、降低幻觉、稳定输出。这里有一个关键特性——首尾效应:模型对提示词开头和结尾的内容更敏感。UP主建议把核心指令和关键约束放在开头或结尾,次要信息放中间。不过他也提到,随着模型能力提升,这个效应在2026年已不那么明显,早期模型上效果更好。
为什么提示词如此重要?
UP主强调,提示词直接决定输出质量。同样的模型,不同人使用效果天差地别,根源往往在提示词。他举了一个产品文案的例子:只说“帮我写个产品文案”,模型能写但未必符合需求;加上“无线耳机、突出续航和降噪”会好一些;而一条高质量提示词是这样的:
你是一个资深的数码口播文案大师,帮我写三条适合抖音的无线耳机短文案,目标受众是通勤上班人员,核心突出12小时续航和地铁降噪无杂音,每条30字左右,口语化,结尾加上行动引导。
对比之下,后者显然更精准。提示词的价值体现在四个方面:
- 低成本激发模型能力:无需微调或训练,仅靠优化提示词就能显著提升任务准确率,是性价比最高的手段。UP主提到从头训练模型成本可能上千万,微调70B模型仅显卡就花费不少,而优化提示词几乎零成本。
- 降低幻觉风险:提供参考文本、限定输出边界、引导推理步骤能大幅减少模型“一本正经胡说八道”的概率,但无法完全避免。
- 适配真实业务场景:标准化提示词设计是AI产品落地的核心环节,是所有大模型应用的基础能力。
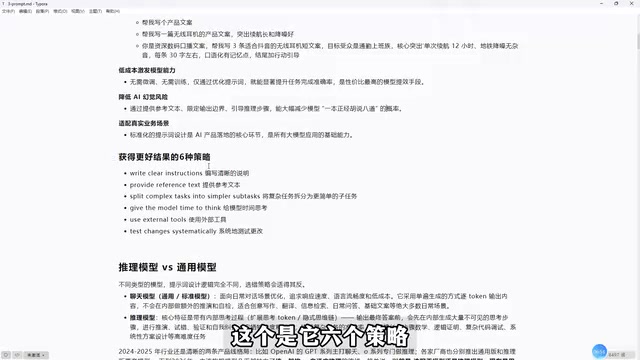
推理模型 vs 通用模型:提示词策略完全不同
UP主指出,在讲技巧前必须理清模型类型,选错策略可能适得其反。通用模型(聊天模型)针对日常对话优化,追求速度、流畅度和低成本,采用单遍生成方式逐个token输出,适合写作、翻译、检索、日常问答。推理模型则在内部有思考过程(内化的COT,即隐式思维链),输出前会生成大量不可见的思考步骤进行推演、试错和纠错,牺牲速度和成本换取复杂任务的准确性,擅长数学推理、逻辑证明、代码调试。
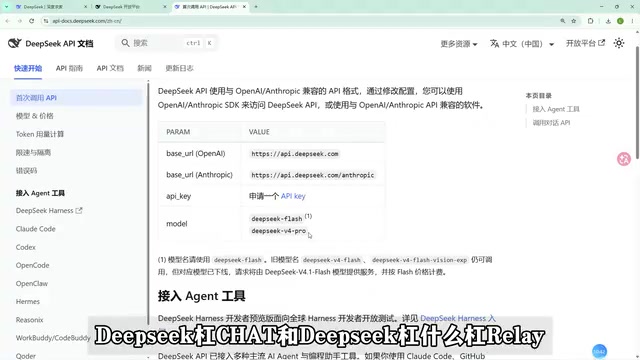
但到了2026年,界限已经模糊。UP主以DeepSeek广告为例:早期有DeepSeek-chat(聊天)和DeepSeek-reasoner(推理)两个模型,现在平台上的模型(如flash和v4-pro)都支持思考与非思考模式,通过参数(如thinking的enable/disable和思考强度low/medium/high)切换。他翻看更新日志指出,过去V3是聊天模型、R1是推理模型,而今年已统一为同一模型自适应推理。
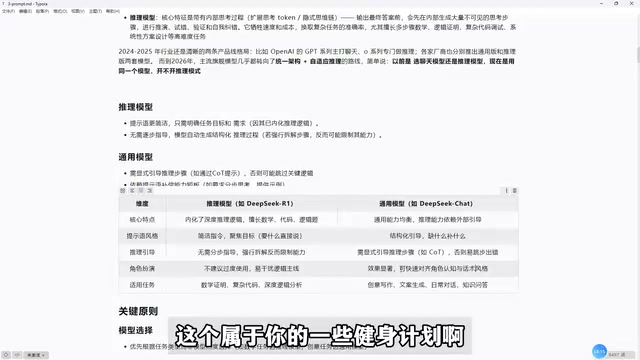
因此提示词写法也要调整:推理模型只需明确任务和需求,无需分步引导,强行拆解反而可能削弱其推理能力;通用模型则需要显式引导推理步骤(如COT),否则容易跳步出错。角色扮演方面,推理模型不建议过度使用以免干扰逻辑主线,通用模型则适合用角色设定快速对齐风格。UP主提醒,选择是否开启思考模式应基于任务需求,而非盲目追新。
COT(Chain-of-Thought,思维链) 指让模型在给出最终答案前先输出中间推理步骤的技术。在提示词中加入“让我们一步步思考”或给出带推理过程的示例,都能引导模型显式展开思考。推理模型将这一过程“内化”:训练阶段就让模型学会在内部生成大量不可见的思考 token,用户只看到结果,因此无需在提示词里再要求分步。COT 最早在数学应用题上被验证有效,随后扩展到逻辑推理、多跳问答等任务;但它对事实性检索、风格改写等任务收益有限,甚至可能因引入多余推理而增加延迟和错误。
Token 是模型处理文本的最小单位,可粗略理解为词或词的一部分。模型逐个 token 生成输出,生成速度、上下文长度限制和 API 计费都按 token 计算。推理模型在内部生成大量不可见的思考 token,这些 token 同样消耗算力和费用,这正是“牺牲速度与成本换准确性”的具体含义。理解 token 也有助于把握提示词原则中的“简洁不冗余”:过长的提示词会占用上下文窗口并增加成本。
OpenAI六策略与高质量提示词五原则
UP主引用了OpenAI提出的六个策略,认为放到2026年依然适用:编写清晰说明、提供参考文本、将复杂任务拆解为子任务、给模型思考时间、使用外部工具、系统测试更改。其中“提供参考文本”对应少样本提示(Few-shot),“使用外部工具”则从Function Calling演进到MCP。
最后他总结了高质量提示词的五个原则:
- 具体不模糊:避免抽象表述,明确边界和标准。比如写诗要指定“四句七言绝句、主题人工智能发展、风格豪迈”。
- 上下文充足:交代任务背景、使用者身份、使用场景。比如问“如何提高英语成绩”,不如说“我是五岁幼儿园小朋友,还不会写字,怎么趣味启蒙英语”。
- 无歧义:关键概念明确界定,避免同义词造成理解偏差。
- 逻辑连贯:指定顺序符合认知逻辑——先角色后任务再要求再示例,但并非必须全有。
- 简洁不冗余:核心信息前置,删除无关信息。过长的上下文会干扰模型注意力,影响最终回复。
这五个原则与OpenAI策略相互印证,构成了提示词工程的实用框架。UP主最后强调,提示词是人和大模型交互最直接的媒介,写好提示词能少踩坑、少走弯路。
少样本提示(Few-shot Prompting) 是在提示词中给出几个“输入—输出”示例,让模型从中归纳任务模式再处理新输入,对应 OpenAI 策略中的“提供参考文本”。与零样本(只给指令)相比,少样本能更有效地约束输出格式和风格,尤其适合分类、抽取、格式转换等任务。示例应覆盖典型情况和边界情况,保持格式一致,数量通常 3~5 个即可;示例过多会占用上下文并可能引入偏差。
MCP(Model Context Protocol,模型上下文协议) 是让大模型以标准化方式连接外部工具和数据源的开放协议,可视为 Function Calling 的演进:后者由各厂商自定义函数调用格式,而 MCP 提供统一的接口描述与调用规范,使模型能跨平台接入搜索、数据库、文件系统等工具。它解决的是“模型如何发现并安全使用外部能力”的问题,是构建智能体(Agent)应用的重要基础设施。
相关推荐
ECC:让AI编程助手像工程团队一样工作
ECC 是一个在 GitHub 上拥有近30万星的开源仓库,为 AI 编程助手补上工程纪律:先规划、写测试、再实现,由独立审查者复核,内置71个专用助手与314项技能,并提供安全扫描,兼容 Codex、Cursor、Gemini 等工具。
别只用ChatGPT!这5款AI工具更专业
别再把所有任务都丢给ChatGPT。本文梳理Perplexity、Notebook LM、Gama、Claude、Cursor五款专用AI工具,分别覆盖研究搜索、文档理解、演示制作、写作构思与AI编程,帮你按场景选对工具、提升日常效率。
Cursor IDE:用自然语言生成代码,告别重复样板
Cursor IDE 让你用自然语言描述组件(如登录表单、数据看板),即时生成代码并直接集成到现有项目。本文解析其工作流、集成能力与适用边界,帮开发者判断是否值得纳入工具链。