仓鼠跑轮驱动本地AI:一场关于算力能耗的黑色幽默

仓鼠跑轮供电的荒诞帖子,折射出本地AI的能耗焦虑与自给自足诉求。
文章从Reddit上一则"用仓鼠Wally的跑轮为本地AI供电"的帖子切入,指出仓鼠毫瓦级输出远不足以驱动数瓦级的推理设备,帖子中的速度与能量读数更可能是戏谑性的模拟映射。但这一荒诞设定精准戳中了本地AI社区的真实痛点:消费级显卡满载推理功耗可达数百瓦,电费账单肉眼可见;数据中心层面的电力与冷却用水消耗则更为惊人。作者分析帖中"无云费用、无速率限制、无排队等待"的诉求,认为其象征本地部署对可控与自给自足的追求。玩笑之外,模型量化、知识蒸馏与推理框架优化才是降低本地推理能耗的现实路径,而仓鼠的纯粹快乐恰是对算力军备竞赛叙事的温和反驳。
当仓鼠成为AI的"供电局长"
Reddit上出现了一则令人啼笑皆非的帖子:一位用户声称自己用仓鼠Wally的跑轮为本地AI模型供电,从而彻底摆脱了对数据中心的依赖。据帖子描述,Wally在跑轮上奔跑时,模型就能运行;Wally休息时,推理任务也随之暂停。当前速度读数显示为0.1,能量读数为1019,AI负载约22%。用户坦言"按任何正常标准来说这都不算快",但胜在完全离线、不消耗电网电力,只需保证水瓶和种子充足即可。
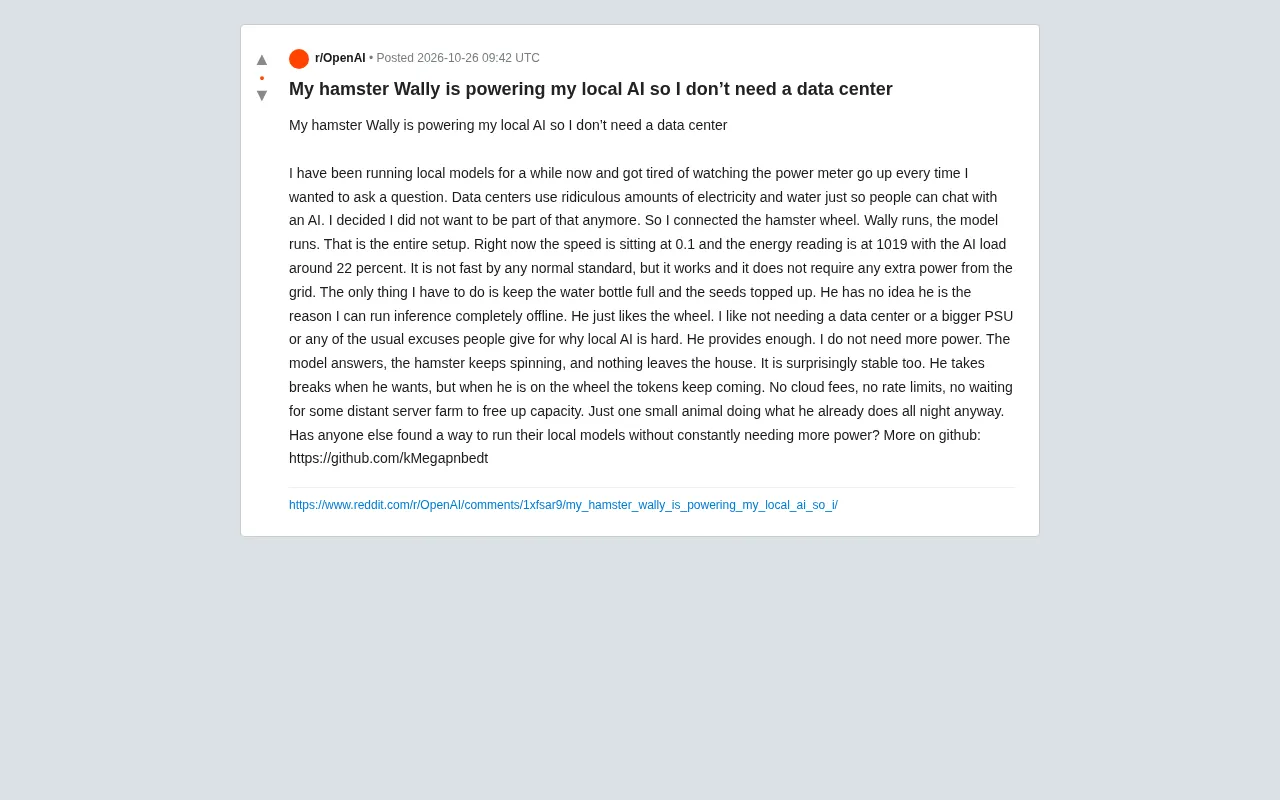
从技术角度看,一只仓鼠的输出功率大约在毫瓦级别,而即便是树莓派级别的推理设备也需要数瓦电力。帖子中"速度0.1"的读数更可能来自某种模拟或戏谑性的传感器映射,而非真实的能量转换。但这条帖子之所以引发关注,恰恰因为它用极端荒诞的方式戳中了一个真实痛点:本地AI的能耗焦虑。
本地AI的"电费恐惧"从何而来
帖子作者提到,自己运行本地模型已有一段时间,但每次提问时看着电表数字往上跳就感到不适。这种情绪在本地AI社区中并不罕见。大语言模型的推理功耗与模型规模直接相关,消费级显卡在满载运行时整机功耗轻松突破数百瓦,长时间对话或批量生成任务会让电费账单肉眼可见地增长。
同时,数据中心层面的能耗问题更加触目惊心。帖子中提到数据中心为支撑AI聊天消耗了"荒谬数量的电力和水",这一判断与近年来业界对AI基础设施环境成本的持续讨论相呼应。冷却系统用水、备用电源损耗、GPU集群的持续高负载,都让"和AI聊一句话"的隐性环境代价远超普通用户的想象。作者用仓鼠跑轮做对比,本质上是在质问:我们真的需要为了每次推理都动用如此庞大的基础设施吗?
模型量化是指在推理或部署阶段降低模型权重和激活值的数值精度(如把常见的FP16/BF16权重转为INT8或INT4),从而减少显存占用、访存带宽需求和矩阵乘法的计算量,通常只需很小的精度损失。对本地部署而言,量化是最直接降低功耗与硬件门槛的工程手段之一:显存占用下降意味着可以用更低功耗的GPU或统一内存设备运行同样参数规模的模型。
知识蒸馏则是让小模型(学生模型)学习大模型(教师模型)的输出分布,以较少的参数近似大模型的能力。与量化不同,蒸馏改变的是模型结构与参数规模本身,因而能在消费级硬件上实现更快的推理速度、更低的单次生成能耗,常被用于构建可在笔记本或边缘设备上运行的对话模型。
荒诞方案背后的真实诉求
抛开仓鼠的喜剧效果,帖子中几个细节值得玩味。作者强调"不需要更大的电源"、"没有云费用"、"没有速率限制"、"没有等待远端服务器释放容量",这些正是本地AI拥趸的核心诉求:可控、离线、无订阅负担。Wally提供的"算力"虽然微不足道,但它象征的是一种自给自足的理想状态。
帖子还提到系统"出奇地稳定",仓鼠想休息就休息,但只要它在跑,token就持续产出。这种描述显然带有拟人化的浪漫色彩,但也折射出本地部署的另一个优势:没有云服务的排队和限流,响应节奏完全由自己掌握。作者在结尾向社区发问:有没有人找到过不依赖持续增加电力就能运行本地模型的方法?这个问题本身比仓鼠跑轮更有讨论价值。
云服务的速率限制(rate limiting)与配额排队是本地AI拥趸反复提及的痛点来源。商业API通常以每分钟请求数、每分钟token数或并发数限制用户调用,并在高峰期对请求排队或降级;免费或低价档位还可能触发容量不足的等待。对频繁进行长对话、批量生成或实验性调用的用户而言,这种外部约束会打断工作流,也使得成本与响应时间难以预测。本地部署把推理节奏的控制权交还给用户,代价则是自建硬件的前期投入与持续电费。
玩笑之外,本地AI能耗的现实解法
仓鼠供电当然不可复制,但降低本地推理能耗的方向确实存在。模型量化能在几乎不损失效果的前提下大幅压缩显存占用和计算量;蒸馏小模型让消费级硬件也能跑出可用的对话质量;推理框架的批处理优化和显存复用则减少了重复计算带来的浪费。这些才是帖子戏谑外壳下真正值得关注的工程路径。
至于帖中附带的GitHub链接,从地址形态看更像是一个个人仓库入口,并未提供可复现的仓鼠供电方案。把它当作一个技术幽默来看待或许更合适:当整个行业在讨论吉瓦级数据中心和核电站供电协议时,有人用一只啮齿动物的日常运动来嘲讽算力军备竞赛的荒谬感。Wally不知道自己正在运行推理,它只是喜欢跑轮——而这份纯粹的快乐,恰好成了对"更多电力、更大集群"叙事最温和的反驳。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。