Cap-and-Track:让LLM推理调度随容量动态伸缩

Meta 提出 Cap-and-Track,用拒绝信号驱动 LLM 推理请求调度,省 43% GPU。
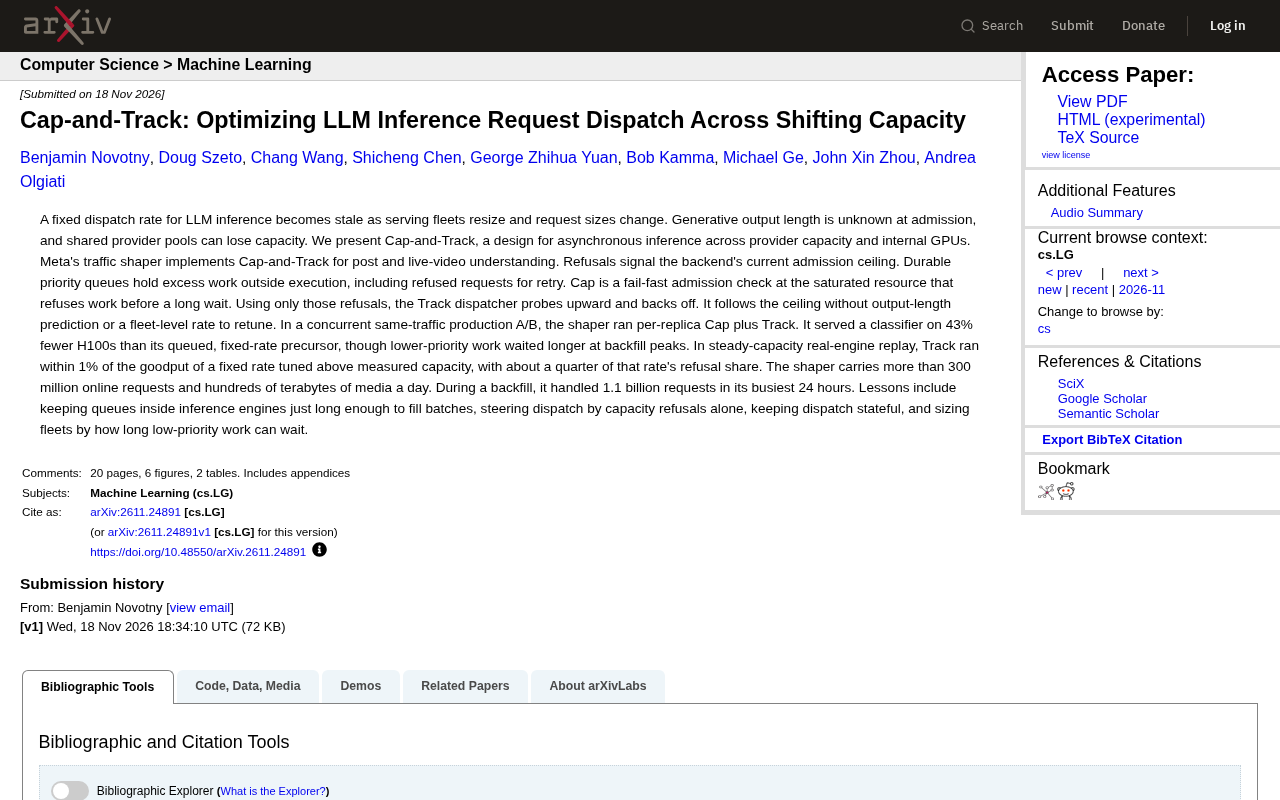
Meta 工程团队在论文《Cap-and-Track》中提出一套面向 LLM 推理请求派发的调度设计,并落地于其流量整形器。文章指出固定派发速率在集群扩缩容、请求尺寸波动时会失效,根源在于生成阶段负载取决于准入时未知的输出 token 数,且共享供应商容量可能中途丢失。Cap-and-Track 由两个机制组成:Cap 在已饱和资源上做快速失败准入检查,被拒请求进入持久化优先级队列;Track 仅凭拒绝信号向上探测容量、遇拒回退,无需预测输出长度或维护全局速率。生产 A/B 测试中用少 43% 的 H100 服务同一分类器,稳态回放下 goodput 与调优固定速率相差 1% 以内、拒绝比例仅约四分之一。
当大模型推理服务集群不断扩缩容、请求本身的尺寸也在变化时,固定的调度速率很快就会过时。更棘手的是,生成式输出的长度在请求被接纳时完全未知,而共享的供应商资源池还可能随时丢失容量。Meta 的工程团队在论文《Cap-and-Track: Optimizing LLM Inference Request Dispatch Across Shifting Capacity》中给出了一套名为 Cap-and-Track 的设计,并将其落地在 Meta 的流量整形器(traffic shaper)里,支撑图文与直播视频理解这类线上业务。
为什么固定速率会失效
传统做法是给调度器设定一个固定的派发速率,比如每秒向推理集群投递多少个请求。这个速率在稳态下工作得很好,但一旦服务集群的规模发生变化,或者请求的平均输出长度波动,原本调好的速率就会偏离最优:设得太高会造成大量请求被拒或长时间排队,设得太低则算力闲置。
问题在于,真正决定系统瓶颈的是“生成阶段”的负载,而生成阶段的工作量不仅取决于请求数量,还取决于每个请求实际产出的 token 数——这个数字在准入时刻根本不知道。再加上来自共享供应商池的容量可能中途消失,任何静态配置都难以持续贴合现实。
生成阶段与预填充阶段的负载差异:LLM 推理通常分为两个阶段——预填充(prefill)阶段处理输入提示、一次性计算所有输入 token 的注意力,属于计算密集型;生成(decode)阶段则自回归地逐 token 输出,每步只处理一个 token,属于内存带宽密集型。两者对 GPU 资源的占用模式截然不同。文章指出真正决定系统瓶颈的是生成阶段,原因在于生成阶段的耗时与输出 token 数成正比,而输出长度在准入时未知,因此请求数量本身无法反映真实负载。固定速率调度器若只按请求数派发,就会在长输出请求占比升高时低估生成负载、在短输出请求居多时高估负载,导致速率频繁偏离最优。
Cap-and-Track 的两个核心机制
Cap:在饱和资源上快速失败
Cap 是一个“快速失败”的准入检查。它作用在当前已经饱和的那个资源上,在请求进入漫长的排队等待之前就做出拒绝决定。被拒绝的请求不会丢失,而是被放进持久化的优先级队列中,等待重试。这些拒绝信号本身就携带了后端当前准入上限的信息——换句话说,拒绝不是错误,而是一种反馈。
快速失败(fail-fast)与持久化优先级队列:快速失败是一种系统设计模式,指在资源确定不可用或请求注定失败时立即返回错误,而不是让请求进入漫长等待后才失败。在推理调度中,若请求先排队数秒再被拒绝,既浪费了队列容量,也让上游无法及时重试或降级。Cap 将拒绝提前到准入时刻,并把被拒请求放入持久化优先级队列——持久化意味着即使调度器进程重启或集群扩缩容,排队中的请求及其优先级也不会丢失,从而保证调度状态跨事件连续。这与后文“调度状态要持久化”的经验相互呼应。
Track:只靠拒绝信号向上探测
Track 调度器只使用这些拒绝信号来工作:它向上探测容量,遇到拒绝就回退,从而持续跟随后端的上限。整个过程不需要预测输出长度,也不需要维护一个需要在集群层面反复调整的全局速率。调度状态因此得以保持有状态——这被作者列为关键经验之一。
AIMD 式探测与 goodput:Track 的“向上探测、遇拒回退”本质上是一种加性增、乘性减(AIMD)的反馈控制,与 TCP 拥塞控制在思路上同源——发送方持续小幅提升速率,一旦收到拥塞信号就大幅回退,从而在不依赖精确模型的情况下逼近链路容量。这里的“拒绝信号”扮演拥塞信号的角色。文中反复出现的 goodput(有效吞吐)指单位时间内成功完成、且未被拒绝的有用工作量,区别于包含失败请求的原始吞吐(throughput)。以 goodput 衡量调度效果,能同时反映吞吐与拒绝代价,因此论文用它来对比 Track 与调优固定速率。
生产环境中的实测表现
论文给出了两组数据。在一次同流量的并发生产 A/B 测试中,整形器按每个副本运行 per-replica Cap 加 Track,结果用比排队式固定速率前身少 43% 的 H100 GPU 就服务了同一个分类器。代价是,在回填(backfill)高峰期,低优先级任务等待的时间更长。
另一组是稳态容量下的真实引擎回放:Track 的吞吐效率(goodput)与一个调优到高于实测容量的固定速率相差在 1% 以内,而拒绝比例大约只有后者的四分之一。从运营规模看,该整形器每天承载超过 3 亿次在线请求和数百 TB 媒体数据;在一次回填期间,它最繁忙的 24 小时内处理了 11 亿次请求。
来自一线部署的经验
作者总结的几条经验颇具普适性。其一,队列应该留在推理引擎内部,但保留时间只要刚好够填满批次即可,不要让请求在引擎里无限堆积。其二,调度方向应该完全由容量拒绝信号来驱动,而不是依赖外部预测模型。其三,调度状态要持久化,才能跨扩缩容事件保持连续。其四,集群规模的规划应该以“低优先级任务能等多久”为依据,而非只看峰值吞吐。
这些经验指向一个更本质的观点:在容量不断变化的推理场景里,与其试图精确预测,不如构建一个能对拒绝信号快速反应的反馈回路。Cap-and-Track 的价值或许正在于它把“拒绝”从一个需要避免的坏结果,变成了调度器可用的信号源。
相关推荐
DevWorkflow 5.0:用AI五步法从想法到上线
DevWorkflow 5.0 是 Claude Code 插件,用五步流程让 AI 辅助开发从想法到上线。每个决定先问你,避免 AI 擅自加表加字段、文档代码不一致、测试未写就合并。支持多平台多语言,个人开发者和小团队适用。
Hermes Agent的.md文件如何工作?核心机制解析
解析 Hermes Agent 的 .hermes 目录机制:user.md 存个人信息、memory.md 记录值得记住的细节、soul.md 定义 Agent 性格。了解这套纯 Markdown 文件如何让 Agent 跨会话保持一致行为。
联合国“杀手机器人”谈判再陷僵局:自主武器监管为何难破冰
联合国日内瓦会议就自主武器(“杀手机器人”)规则展开谈判,一周磋商收效甚微,代表仅同意“开始讨论选项”。本文分析谈判僵局背后的定义分歧、安全诉求冲突与多边机制局限。