CapCover Filter:无需邻域搜索的语义近似成员查询
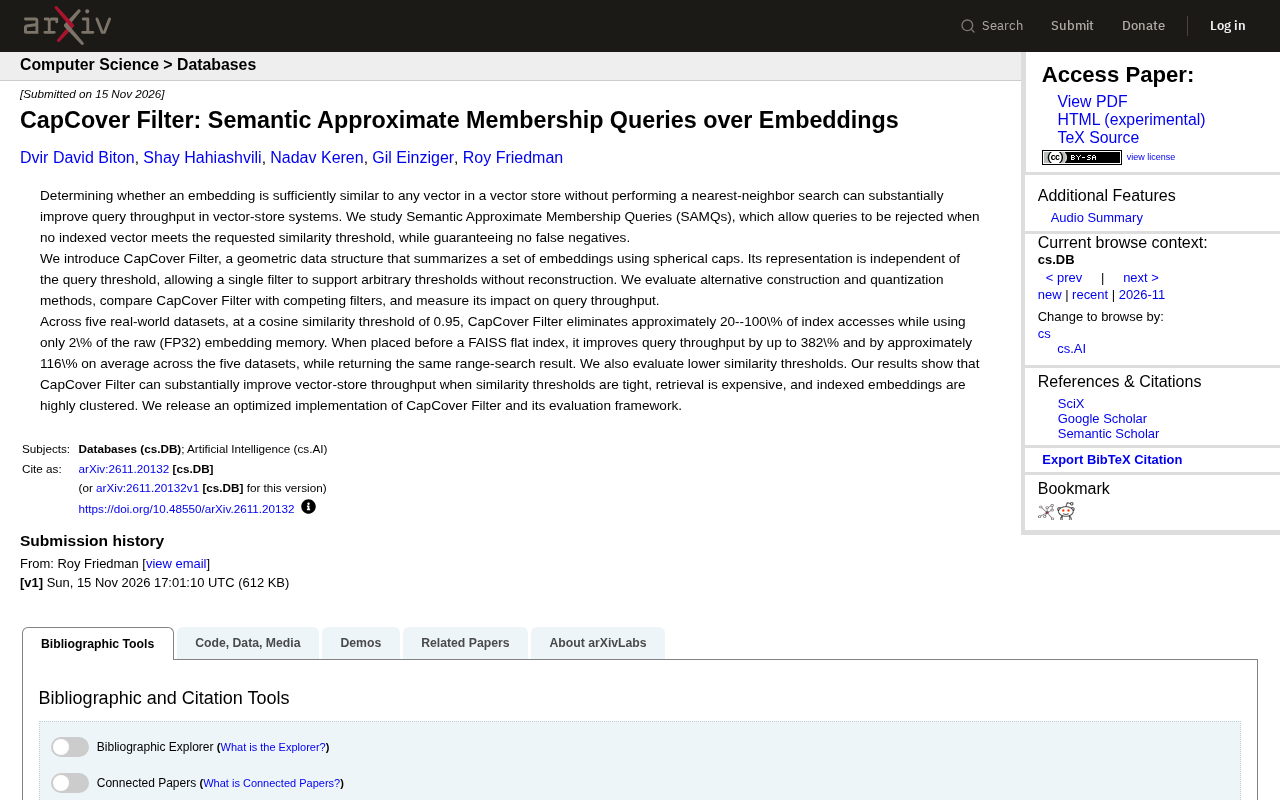
CapCover Filter 用球冠几何结构前置过滤语义近似成员查询,保证无假阴性并大幅提升向量检索吞吐量。
本文介绍 CapCover Filter,一种针对语义近似成员查询(SAMQ)的几何过滤器。SAMQ 只判断向量库中是否存在相似度超过阈值的条目,而非返回 top-k 结果,其核心约束是无假阴性、允许假阳性。CapCover Filter 用球冠概括嵌入分布,查询时只需判断是否落入任一球冠即可决定放行或拒绝,且结构支持任意相似度阈值而无需重建。在五个真实数据集、余弦阈值 0.95 下,它仅占用原始 FP32 嵌入 2% 的内存,却消除约 20%-100% 的索引访问;置于 FAISS flat 索引之前,吞吐量最高提升 382%,平均约 116%,且 range-search 结果完全一致。该过滤器在阈值较紧、检索昂贵、嵌入高度聚集时收益最大,适合作为向量数据库的轻量前置过滤层,作者已开源实现与评估框架。
向量数据库的查询性能瓶颈往往出现在最近邻搜索上。但如果查询的目标只是判断“是否存在足够相似的向量”,而非找到最相似的那个,是否还有必要执行完整的KNN搜索?一篇题为《CapCover Filter: Semantic Approximate Membership Queries over Embeddings》的研究提出了否定答案。
问题背景:语义近似成员查询(SAMQ)
传统向量检索围绕 top-k 最近邻展开,系统需要返回与查询向量最相似的若干结果。然而在许多实际场景中,用户真正关心的是一个阈值判断:向量库中是否存在与查询向量相似度超过某个阈值的条目?如果不存在,查询可以直接被拒绝,无需进入昂贵的索引访问流程。
这类查询被作者定义为 Semantic Approximate Membership Queries(SAMQ,语义近似成员查询)。其核心要求是在保证无假阴性(no false negatives)的前提下,尽可能多地拒绝不可能命中的查询。换句话说,过滤器可以偶尔放行一些实际不满足条件的查询(假阳性),但绝不能错误地拒绝真正满足条件的查询。
无假阴性(no false negatives) 是过滤器设计中的核心正确性约束。在这种语义下,过滤器允许两类结果:真阳性(确实满足阈值且被放行)和假阳性(实际不满足阈值却被放行);但绝不允许假阴性,即真正满足相似度阈值的向量被错误拒绝。这一不对称性来源于查询语义:range search 要求返回所有满足条件的条目,因此一旦过滤器漏掉某个本应命中的向量,结果就是错误的。所以过滤器只能在“确定不可能命中”时才拒绝查询,其余情况一律放行。工程上这意味着过滤器的召回率必须严格为 1,而精确率可以小于 1;优化目标就是在不牺牲召回的前提下尽量提高拒绝率,从而减少后端索引访问。
CapCover Filter 的设计思路
研究团队提出的 CapCover Filter 是一种几何数据结构,它用球冠(spherical caps) 来概括一组嵌入向量的分布。每个球冠覆盖嵌入空间中的一个区域,查询时只需判断查询向量是否落在任何一个球冠内,即可快速决定是否放行。
这种表示的关键优势在于与查询阈值无关:同一个过滤器结构可以支持任意相似度阈值,而无需针对不同阈值重建索引。相比之下,许多竞品过滤器需要为每个阈值单独构建,灵活性和存储效率都受到限制。
论文还探讨了不同的构建方法和量化策略,并对 CapCover Filter 与竞品过滤器进行了系统比较。
球冠(spherical cap) 是球面上被一个平面截出的部分,可理解为“球面上一块圆形区域”,由球心方向与一个角半径唯一确定。把嵌入向量归一化到单位球面后,一个球冠就对应一组方向相近的向量集合:球冠的轴心代表该簇的中心方向,角半径决定覆盖范围。判断查询向量是否落入某个球冠,只需计算查询方向与该球冠轴心的夹角(等价于余弦相似度)是否小于角半径,计算代价远低于访问高维索引。用一组球冠覆盖嵌入集合,就得到一个保守的外包络:只要查询与任意球冠内某个向量足够相似,它就必然落在对应球冠内,因此可以安全放行;反之则拒绝,从而在不产生假阴性的前提下实现快速过滤。
实验效果:吞吐量显著提升
作者在五个真实数据集上进行了评估。在余弦相似度阈值设为 0.95 时,CapCover Filter 能够消除大约 20% 到 100% 的索引访问,而自身仅占用原始 FP32 嵌入内存的 2%。
将 CapCover Filter 置于 FAISS flat 索引之前时,查询吞吐量最高提升 382%,五个数据集上的平均提升约为 116%,同时返回的 range-search 结果与未使用过滤器时完全一致。
研究还评估了更低的相似度阈值。结果表明,当相似度阈值较紧、检索成本高昂、且索引嵌入高度聚集时,CapCover Filter 对向量存储吞吐量的提升尤为明显。
FAISS flat 索引 是 Facebook AI Similarity Search(FAISS)库中最基础的精确检索结构,它对全部向量做暴力(brute-force)距离计算,不做任何近似剪枝,因此召回率最高但单次查询成本随数据量线性增长。把过滤器置于 flat 索引之前,本质是构建“过滤—精确检索”两级流水线:过滤器先用极低成本拦掉不可能命中的查询,只有被放行的查询才进入 flat 索引执行完整距离计算。由于 flat 索引的每次访问成本固定且较高,过滤器的拒绝率直接转化为吞吐量收益;同时因为过滤器保证无假阴性,最终 range-search 结果与不使用过滤器时完全一致,这也解释了实验中“结果保持一致”的结论。
适用场景与工程意义
CapCover Filter 的价值在于为向量数据库增加了一道轻量级的前置过滤层。它并不替代现有的索引结构,而是以极低的内存开销(仅为原始嵌入的 2%)拦截大量无效查询,从而降低后端索引的负载。
对于需要高吞吐、低延迟的语义搜索服务,尤其是那些查询中相当比例实际上不会命中任何结果的场景,这种过滤器的收益可能非常可观。作者已开源了优化实现和评估框架,便于工程团队复现和集成。
论文同时指出,过滤器的效果依赖于嵌入的聚集程度和阈值的严格程度——在嵌入分布分散或阈值宽松的场景下,收益会相应减小。
相关推荐

AI代打电话?Muse让语音助手替你预约
Muse推出AI代打电话功能,仅限美国付费订阅用户。本文分析语音助手切入电话场景的产品逻辑、付费墙策略与语音代理的想象空间及隐私隐忧。
谷歌PaperOrchestra:多智能体框架自动化写AI论文
谷歌研究院开源 PaperOrchestra 多智能体框架,将 AI 研究论文写作拆解为文献、方法、实验等子任务,由不同智能体协作编排完成,GitHub 已获 2093 星,今日新增 313 星。

Marimba:0.6B小模型如何用单一编码器处理语音问答
Marimba 是一个基于 Qwen3-ASR-0.6B 编码器的轻量语音问答模型,支持流式处理、本地运行,可作为轮次检测器接入 Pipecat、LiveKit 和 Vapi,在特定任务上超越大模型。