#向量数据库
共 35 篇相关文章
Milvus 2.6 实战:构建高性能 RAG 智能问答系统
深入解析 Milvus 2.6 向量数据库架构与部署方式,结合高性能 RAG 智能问答实战,讲解水位线、预热字段、索引与驱逐策略等关键优化点,帮助开发者构建企业级 AI 应用。
Milvus 2.6 实战:高性能 RAG 从向量原理到企业问答
基于李锦老师课程,详解 Milvus 2.6 向量数据库架构、相似度检索原理与高性能 RAG 项目实战,涵盖分层存储、驱逐策略、预热机制及 2026 年 AI 大模型就业趋势分析。

HyperspaceDB v4.2.3:1.58-bit量化与过滤搜索突破
HyperspaceDB v4.2.3 发布,带来 1.58-bit BitNet 量化实现 15.5 倍压缩与 92.6% 召回率,并针对 HNSW 在 5–10% 过滤率区间的性能悬崖给出优化,特定场景比 OpenSearch 3.9 快 154 倍。

RAG生产环境向量数据库怎么选?开发者实战讨论
Reddit开发者讨论生产环境和MVP阶段RAG向量数据库的选型经验,涵盖专用向量数据库、传统数据库向量扩展与轻量方案的取舍,并提供务实的选型检查清单。
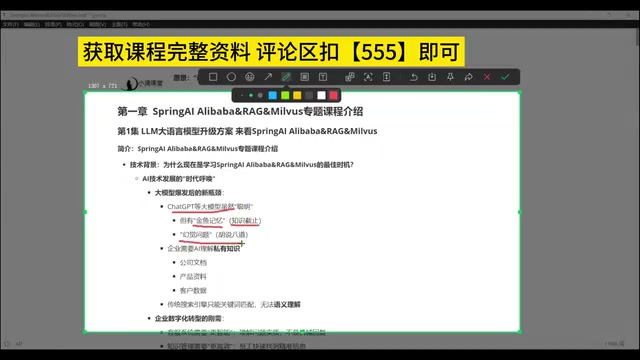
SpringAI+RAG企业级实战:打破大模型三大瓶颈
基于B站SpringAI+RAG企业级实战教程,解析大模型知识截止、金鱼记忆、幻觉与私有数据盲区四大痛点,梳理Spring AI Alibaba+Milvus技术栈的学习路径、能力目标与适配人群,帮助Java开发者低成本切入AI应用开发。

Infino AI:一份Parquet搞定向量与SQL检索
Infino AI 是面向 AI Agent 的开源检索引擎,将 BM25 与向量索引内嵌于 Parquet 文件,支持关键词、向量、混合与 SQL 查询。Apache-2.0 开源,同时提供 Infino Cloud 免费层。

向量数据库入门全解:从嵌入到ChromaDB语义搜索
从向量、余弦相似度、分词与嵌入模型讲起,手把手演示用Gemini生成嵌入并在ChromaDB中完成语义搜索,系统梳理向量数据库的内部架构、IVF与HNSW索引及实战工作流。

向量数据库架构全解析:AI系统背后的核心组件
基于Reddit社区讨论,系统解析向量数据库的分层架构:存储层、索引层、查询层与分布式层,剖析近似最近邻检索的工程权衡与选型考量。

Qdrant v1.19.2 架构深潜:四层优化解决分布式瓶颈
深入解析 Qdrant v1.19.2 的四项关键架构修复:Tokio 线程饥饿、WAL 钉死、稀疏索引写放大和 Raft 快照阻塞,以及它们对高吞吐向量搜索生产环境的影响。

deer-flow 向量记忆持久化实战:长时程 Agent 的混合检索与性能调优
深入解析如何将字节跳动 deer-flow 框架与 PostgreSQL + pgvector 集成,实现长时程 Agent 的向量记忆持久化。涵盖 HNSW 索引调优、RRF 混合搜索、并发写入瓶颈与嵌入归一化等实战经验。

2026年最佳AI数据库解决方案:超越向量存储的选型指南
2026年AI数据库选型指南:向量存储为何不足以支撑AI生产化,专用向量数据库与pgvector等通用数据库扩展的技术路线对比,以及RAG流水线选型的关键评估维度。

用 TypeScript 手写 HNSW,实测 efSearch 与召回率权衡
用 TypeScript 从零实现 HNSW 近似最近邻索引,在 Node 中索引 5 万向量,实测 efSearch 从 10 到 200 时 recall@10 与延迟的权衡,并解析 pgvector、Qdrant 的生产参数与过滤陷阱。

向量数据库2026:Milvus 3.0、Qdrant与Postgres之争
2026年向量数据库格局剧变:Milvus 3.0将向量检索下沉至数据湖,Qdrant完成5000万美元B轮押注智能体工作负载,PostgreSQL搭配pgvector则抢占中小规模用例。本文解析三条技术路线背后的选型逻辑。

多模态索引可还原原始图像:向量数据库的隐私盲区
最新研究显示,多模态视觉文档检索系统的补丁向量索引可被反演还原原始图像,ViDoRe v3 上文字召回率达 47%、来源识别率 98.4%。打乱向量顺序的防御可被模型逆转,索引需按机密数据加密存储并纳入反演测试。

向量数据库缺失的外键:模型版本一致性危机
向量数据库允许不同模型版本的嵌入向量共存,导致检索质量无声下降。本文分析混合版本索引的成因、成本影响,并提出将模型身份作为模式约束的解决方案。

向量数据库入门:存储与检索企业知识的核心原理
向量数据库如何存储与检索企业知识?本文解析向量数据库原理、HNSW近似最近邻索引、pgvector在PostgreSQL中的应用,以及专用向量数据库Milvus/Qdrant/Pinecone的选型对比,帮你理解语义搜索与RAG的技术地基。
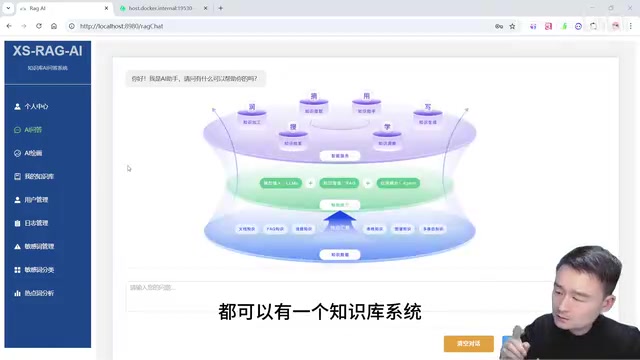
RAG知识库系统实战:从零搭建企业级私有知识库全流程
手把手教你搭建企业级RAG私有知识库系统,基于Vue 3与Spring AI,涵盖Milvus向量数据库、分块策略、召回率优化、AI幻觉抑制、来源追溯与访问控制等企业级实战难点,附完整Java+AI学习路径。
端侧记忆:构建本地运行的AI语音助手实战课
DeepLearning.AI 联合 Qdrant 推出端侧记忆AI助手课程,教你在本地设备上构建能记忆、检索、遗忘并识别物体的语音助手,掌握嵌入向量与边缘向量搜索引擎的实战应用。