Caphlon-Model:剪枝+词表瘦身,27B模型塞进8GB内存
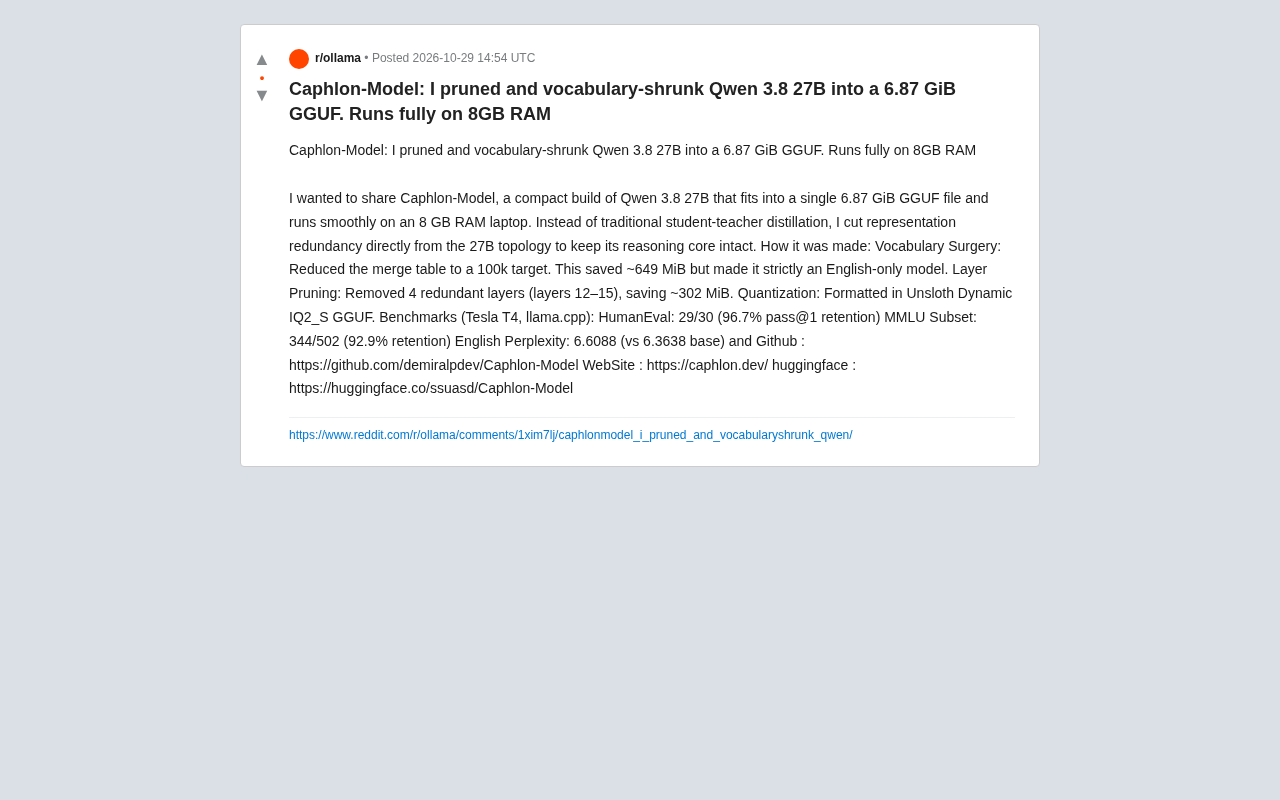
开发者用词表缩减、层剪枝和极低比特量化,将 Qwen 3.8 27B 压成 6.87 GiB 单文件,可在 8GB 内存笔记本运行。
Caphlon-Model 项目提出一条非蒸馏的大模型压缩路线:直接对 Qwen 3.8 27B 的拓扑结构做减法,而非让小模型学习大模型输出。压缩分三步——将合并词表缩至 100k(省约 649 MiB,但变为严格英文单语)、移除第 12 至 15 层(省约 302 MiB)、再用 Unsloth Dynamic IQ2_S 量化为 GGUF 单文件,最终体积 6.87 GiB。作者在 Tesla T4 上用 llama.cpp 评测,HumanEval pass@1 保留率 96.7%,MMLU 子集保留率 92.9%,英文困惑度从 6.3638 微升至 6.6088。项目定位英文、低内存、单文件场景,但结果仍属单一来源自我报告,社区独立复现有限,生产使用前需自行验证。
从27B到6.87 GiB:一条非蒸馏的压缩路线
大模型的参数规模与硬件门槛之间的矛盾,一直是本地部署的痛点。Reddit上一位开发者分享了名为 Caphlon-Model 的项目:将 Qwen 3.8 27B 压缩成单个 6.87 GiB 的 GGUF 文件,并声称能在 8 GB 内存的笔记本上流畅运行。与常见的“学生-教师”蒸馏不同,作者直接对 27B 的拓扑结构动刀,剪掉表征冗余,保留推理核心。
这条路线值得关注的地方在于:它没有用一个小模型去“学”大模型的输出,而是试图在原始网络里做减法。对于想要在消费级硬件上跑大模型的人来说,这提供了一种新的思路。
三步压缩手术:词表、层数、量化
根据作者公开的说明,Caphlon-Model 的构建分三步完成,每一步都有明确的空间收益。
词表手术:合并表缩到100k,省下约649 MiB
第一步是所谓的“词汇手术”(Vocabulary Surgery)。作者将合并表(merge table)缩减到 100k 目标,这一刀省下了约 649 MiB 的体积。代价也很直接:模型变成严格英文单语,不再支持多语言。
层剪枝:移除4个冗余层,再省约302 MiB
第二步是层剪枝(Layer Pruning)。作者移除了 第12至15层 这4个冗余层,又节省了约 302 MiB。从描述看,这四层被判定为对推理核心贡献有限,移除后网络结构依然保持完整。
层剪枝(layer pruning)与量化不同,它直接删除 Transformer 中的整个解码层(通常是自注意力加前馈网络这一完整块),从而减少参数量和计算量,而非仅降低数值精度。判断哪些层冗余,常见做法是计算每层对最终输出的贡献度,例如用余弦相似度衡量移除某层前后隐藏状态的变化。删除中间层后,相邻层直接相连,网络仍可前向传播,但被删层承载的长尾知识或特定语言能力可能丢失。因此层剪枝往往需要少量恢复性微调,否则性能下降会比量化更明显。
量化:Unsloth Dynamic IQ2_S GGUF
最后一步是量化,采用 Unsloth Dynamic IQ2_S 格式输出为 GGUF。这一步将剩余权重压到低比特表示,最终得到 6.87 GiB 的单文件体积。
三步叠加,模型从原始的 27B 规模被压缩到可以塞进 8GB 内存设备运行的程度。
GGUF 是 llama.cpp 项目定义的二进制模型文件格式,专为在 CPU 和消费级 GPU 上高效推理而设计。它把模型权重、分词器、元数据打包进单个文件,并支持多种量化类型(如 Q4_K_M、IQ2_S 等)。相比 PyTorch 的 .bin 或 .safetensors,GGUF 的优势在于内存映射加载和跨平台兼容,是本地部署场景的事实标准。文件体积直接由参数量与量化比特数决定,因此 6.87 GiB 这个数字本身就说明了平均每参数仅约 2 比特出头。
IQ2_S 属于 llama.cpp 的 i-quant 系列,是一种约 2 比特的量化格式,采用重要性矩阵和格点编码来降低极低比特下的误差。Unsloth Dynamic 则指 Unsloth 团队提出的动态量化策略:对不同层或不同张量根据敏感度分配不同比特宽度,例如对注意力关键投影保留更高精度,对冗余部分压到更低比特。相比均匀量化,动态量化能在相同平均比特下更好地保留模型能力,这也是 6.87 GiB 文件仍能维持较高基准保留率的重要原因。
基准测试:推理保留率是核心卖点
作者在 Tesla T4 上用 llama.cpp 做了评测,结果如下:
- HumanEval:29/30,pass@1 保留率 96.7%
- MMLU 子集:344/502,保留率 92.9%
- 英文困惑度:6.6088,对比基线的 6.3638
从数字看,代码生成能力的保留率最高,接近满分;知识问答类任务保留了九成以上;困惑度略有上升,说明语言建模的流畅度有轻微损失。对于一次大幅压缩来说,这个权衡相当激进但也算合理——尤其是 96.7% 的 pass@1 保留率,暗示剪枝没有伤到模型的推理主干。
需要提醒的是,这些结果目前是单一来源的自我报告,评测集规模也有限(HumanEval 30 题、MMLU 子集 502 题),还不能等同于全面性能结论。
困惑度(perplexity)是语言建模的经典内在指标,衡量模型对给定文本的预测不确定性,数值越低表示模型越“不惊讶”于真实文本。它通常在固定验证集上计算,便于不同模型间横向比较,但并不直接对应下游任务准确率。HumanEval 是代码生成基准,包含 30 道手写函数题,以 pass@1 衡量一次生成即通过单元测试的比例;MMLU 则是覆盖 57 个学科的多选题知识基准,子集评测常因成本原因只抽取部分题目。三者结合,分别从语言流畅度、代码能力和知识广度刻画压缩后的模型。
适用边界与社区验证需求
Caphlon-Model 的定位非常清晰:英文、低内存、单文件。词表缩减让它彻底放弃多语言能力,层剪枝和低比特量化则可能影响长尾知识和复杂推理的稳定性。它适合的场景是资源受限的本地推理、边缘设备实验,或者作为英文任务的轻量基座。
作者在 GitHub、项目官网和 Hugging Face 上公开了模型与代码(demiralpdev/Caphlon-Model、caphlon.dev、ssuasd/Caphlon-Model)。不过目前社区独立复现和交叉验证还很少,8GB 内存下的实际吞吐、不同硬件上的表现、以及剪枝层选择的通用性,都值得后续观察。
如果你正在寻找一条不依赖蒸馏的大模型压缩路径,这个项目提供了一个可以动手复现的样本。但在把它用于生产之前,建议先在自己的任务分布上做一轮验证。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。