#量化
共 12 篇相关文章

开源权重LLM架构解析:MoE、混合层与三值权重
解析开源权重LLM的三大架构方向:混合专家MoE如何以稀疏激活扩张参数、混合层如何平衡注意力与线性结构、三值权重如何压缩存储与算力,帮助理解开放模型的成本与能力取舍。

1比特每参数!763B DeepSeek-V4.1-Flash压缩版发布
ISTA 实验室发布 DeepSeek-V4.1-Flash-1017 GSQ-RCO Coder:763B MoE 模型经专家剪枝与 GSQ/RCO 压缩至平均每参数 1 比特,transformer 权重 72.1 GB,LiveCodeBench v6 保留 98.7%,SWE-bench Verified 保留 94.8%,可在 llama.cpp 运行。

告别tok/s内卷:社区私有质量基准测试倡议
Reddit社区提议建立私有质量基准测试,替代对tok/s的盲目追逐,重点关注量化对模型质量的影响,通过分享图表结果实现社区协作。

海外博主实测千亿MoE模型本地部署:量化与工具调用的关键教训
海外博主实测阿里 Quen 3.8 Flash Next 千亿 MoE 模型在 Strix Halo 迷你主机和 CUDA 工作站的本地部署,揭示量化精度对工具调用成功率的影响,以及 Strata、GUFO 推理引擎的实战表现。

8GB显存跑Qwen 3.8 Flash Next:实测900 t/s
Reddit用户实测:8GB显存+32GB内存,借助Strata框架把Qwen 3.8 Flash Next跑出最高900+ t/s提示处理和30+ t/s生成速度,并给出关键参数与质量对比。
MLX 新版本为 Flint 模型提供原生支持,推理引擎能力升级
MLX 新版本为 Flint 模型提供原生支持,推理引擎能力升级
MLX v0.40.8-rc0 新增 Flint 模型支持,涉及提示词 JSON 保真、safetensors 导入期组装 ModelOpt 专家库、可选学习型 sink 与设备端因果掩码三项改动,现有 API 行为保持不变。

BitLens:可视化神经网络量化分析利器
BitLens是一款开源的神经网络量化可视化分析工具,支持单次校准逐层敏感度分析、离群比Omega与SQNR诊断、MCU SRAM峰值规划,并可一键导出torchao、ONNX Runtime与TFLite Micro量化配置。
为什么你的电脑跑不动AI模型?显存才是硬门槛
AI模型的8B指80亿参数而非8GB。本文解释模型参数与存储大小的区别、量化如何压缩体积,以及为什么运行AI模型必须依赖GPU显存而非硬盘或系统内存。

旧电脑跑本地AI模型:量化、上下文与CPU推理实战
在8GB内存、无独显的老旧电脑上运行本地AI模型?本文分享实战经验:选择7B-9B模型与Q4_K_M量化,限制上下文窗口至4096-8192,调整CPU线程数为物理核心数,并解释量化原理与内存占用规则,帮助你用旧硬件跑起可用的语言模型。

英伟达发布Nemotron 3.5 Bolt:74B参数塞进24GB显存的本地VLM
英伟达发布 Nemotron 3.5 Bolt 74B-A9B 视觉语言模型,用原生 2-bit 量化将 74B 参数压进 24GB 显存,支持 256K 上下文与本地 agentic 任务,附 vLLM 部署与投机解码细节。

ProTok: 统一蛋白质分词的多码本量化新方案
ProTok提出统一蛋白质分词器,通过模块化多码本量化和模态dropout,将序列、结构、功能映射到同一离散词汇表。在StructTokenBench上平均排名1.4,CATH lDDT达0.939,生成骨架52%可设计。
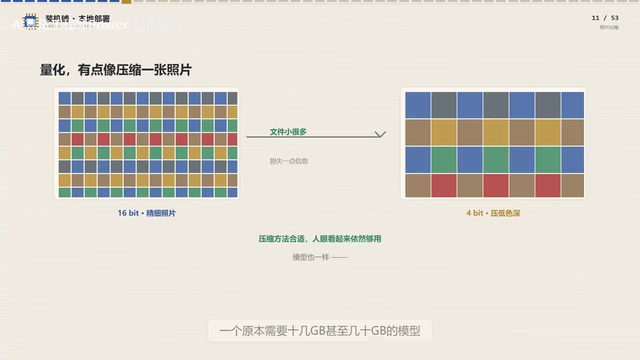
普通电脑如何本地跑大模型?显存、量化与Ollama全解析
本地部署大模型为何总是失败?本文一次讲透显存与内存的区别、量化(Q4/Q5/Q8)、7B/8B参数量、KV Cache、GPU Offload,以及用 LM Studio 和 Ollama 从选模型到加载测试的完整新手部署流程。