Casey Muratori点评Vibe Coding挖掘游戏:AI造游戏的潜力与硬伤

用AI两周速搓挖掘游戏,实战暴露Vibe Coding的真实边界与创意护城河
TheStandup节目组以"AI速搓挖掘游戏"为题进行实战比拼,邀请资深游戏程序员Casey Muratori担任评委。比拼揭示了当前Vibe Coding的几条关键规律:AI在3D建模上表现尚可,但代码质量普遍粗糙,Web 3D的性能问题更多源于平台固有缺陷和训练数据质量而非模型本身;相同的AI工具在不同人手中产出天差地别,关键在于提示词的具体性和是否使用真实参考素材;花费500美元token仍一塌糊涂的Prime,输给了TJ用两小时做出的讽刺叙事游戏——后者以精准戳中团队内梗的创意取胜,证明叙事与创意仍是人类的护城河。节目也借"按潜力评判"的争议,犀利指出AI演示文化中普遍存在的"潜力叙事"陷阱。
在这期TheStandup节目里,几位主播把一个看似荒诞的命题——用AI快速搓出一堆"挖掘游戏"——变成了一场关于Vibe Coding(氛围编程)现状的实战检验。传奇游戏程序员Casey Muratori受邀担任评委,直言不讳地评点了这些用大模型两周甚至两小时内产出的作品。这场看似玩闹的比拼,恰好暴露了当前AI辅助游戏开发的真实边界。
从挖掘到万物:AI原型的"发散式"迭代
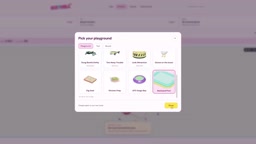
Trash(主播之一)坦言自己的思路完全是发散的。最初命题是做"挖掘游戏",但他很快觉得单纯挖沙子太无聊,于是一路跑偏:从后院水池、海绵吸水,到用筷子清空餐盘的厨房备菜游戏,再到挖掘机、大便甲虫(Dung Beetle)多人对战、拖车模拟器、抓苍蝇的空手道小子致敬游戏,最后甚至做了一整个迷你游戏合集网站。
他形容这是"我大脑过去两周的进化过程",本质上这些游戏共享同一个核心机制——在时间限制内尽快清空/收集某样东西。这种快速原型的爆发力正是AI编程最直观的价值:想法可以近乎零成本地被具象化。
模型擅长建模,却搞不定代码
Trash提到自己在测试Astra(一款刚发布的模型)时得出一个关键判断:AI在3D建模上表现不错,但在写代码上就差得多。他做的一堆模型风格统一、种类丰富,视觉上过得去;但代码层面"非常janky(粗糙抖动)"。
更要命的是性能问题。当Casey的电脑因为网站里堆了太多Three.js模型而风扇狂转、几乎宕机时,这个技术细节引出了一段有价值的讨论。

Vibe Coding(氛围编程)是由Andrej Karpathy在2025年初提出的概念,指一种完全依赖AI生成代码、开发者几乎不阅读甚至不理解具体代码实现的编程方式。开发者只需用自然语言描述意图,反复接受AI建议、观察运行效果并调整提示,整个过程更像是在"感受"和"引导",而非传统意义上的编写与调试。这种模式极大降低了原型开发的门槛,让没有专业编程背景的人也能快速将想法具象化,但代价是代码质量难以保证,深层bug往往难以追溯,维护成本可能远超初始开发。节目中几位主播的实验正是这一模式的典型样本。
Three.js是一个基于WebGL的JavaScript 3D图形库,让开发者可以在浏览器中渲染3D场景而无需直接操作底层图形API。尽管它大幅降低了Web 3D的开发门槛,但其性能瓶颈由来已久:浏览器的JavaScript单线程执行模型、WebGL的CPU-GPU数据传输开销、以及缺乏场景级别自动优化,使得堆叠大量3D资产时极易出现帧率崩塌和CPU过热。专业游戏引擎(如Unity、Unreal)有完整的LOD(细节层次)、遮挡剔除、资产流式加载等优化机制,而AI生成的Three.js代码通常不会自动实现这些,直接导致Casey电脑风扇狂转的场景。
Casey的专业视角:这不是AI的锅
作为资深游戏程序员,Casey面对"这么多模型拖垮网站"的场景反而很平静。他的判断值得AI开发者警醒:
"我内心其实没什么感觉,因为Web对这类东西处理得有多糟糕,早就是不用多说的了。你打开一个3D网站,风扇突然无缘无故狂转。这里面AI肯定有一部分责任,但很大一部分就是平台本身太差。"
他进一步点出了根源在于训练数据:"因为之前的人就把网站做得很烂,所以AI学到的也是烂的。我不会因为一些我早就见过无数次的问题去责怪AI。"
这是个相当克制且专业的观点——AI生成代码的质量上限,很大程度上受制于它学习的历史代码质量,以及Web 3D这类底层平台本身的固有缺陷,不能简单归咎于模型能力。
Prime的作品:同样的AI,为什么效果天差地别?
节目中一个反复出现的困惑是:为什么用同样的AI,不同人的产出视觉质量差距如此之大?Prime做的DDR式挖掘游戏(配合音乐节奏按方向键控制挖掘速度)不仅美术"无法辨认、像加载损坏的视觉噪点",玩法逻辑也彻底崩了——按下方向键就能一直往下挖,节拍完全不同步,方向键还会让角色左右移动,与"向下挖"的核心概念自相矛盾。

Prime自曝这个"艺术品"花了他超过500美元的token成本,却依然一塌糊涂。众人猜测差异可能在于提示词策略:TJ用了真实照片作为参考,而Prime用纯英文描述让AI凭空生成,效果自然难以控制。这其实反映了Vibe Coding的一个现实——产出质量高度依赖输入的具体性和参考素材,而非单纯的算力投入。
Casey的技术点评也很到位:如果Prime把节奏提示放在角色正下方(而不是屏幕左侧),做几个游戏设计的常识性调整,这个DDR挖掘游戏反而是他最愿意玩的一个。"游戏101"的基本功,AI并不会自动替你补上。
TJ的降维打击:叙事才是杀手锏
真正让全场折服的是TJ的作品。他用Opus模型花不到两小时,做了一个讽刺Trash的"挖坑"叙事游戏——一个宝可梦对战风格的互动剧情,主角Basura(西班牙语"垃圾")因为水槽里的脏碗、乱开的柜门、偷偷调低的空调温度,被伴侣用"gotcha"证据一步步逼到墙角,象征性地"越挖越深"直到无法脱身。

最惊人的细节是:TJ表示自己几乎没做过多提示,AI就自动引用了他们此前播客里聊过的"洗碗"梗等具体内容。他推测他们的播客内容可能已经进入了模型的训练数据。这个观察若属实,意味着公开内容创作者的言论正在以意想不到的方式反哺AI输出。
Casey最终把奖颁给了TJ,理由清晰:"如果我们设一个叙事奖,毫无疑问归TJ。"在所有作品里,只有TJ的这个游戏"作为现状(as presented)而非潜力"能称得上是个完整的游戏。
Anthropic的Claude Opus是TJ使用的模型,属于Claude 3系列中能力最强的版本,在长文本理解、叙事生成和复杂推理上表现突出,但API调用成本也相应较高。TJ的作品之所以在短时间内产出完整叙事,一方面得益于Opus对上下文的深度理解能力,另一方面也印证了一个实践规律:叙事类游戏对代码逻辑的要求远低于机制类游戏,AI在生成对话分支、情节转折和情感节奏上的稳定性,明显高于生成物理碰撞、节奏同步等需要精确数值控制的玩法代码。这种"扬长避短"的项目选择,是TJ胜出的隐性因素。
"潜力"话术:Vibe Coding时代的话术陷阱
节目里一个反复被调侃的点,是Prime试图"引导陪审团"——让Casey按"潜力"而非"成品完成度"来评判。TJ和Casey都戳破了这一点。
TJ的一句话相当犀利:"这些都是Vibe Coding的游戏,而整个AI炒作周期的核心就是谈潜力。没人在谈我们已经拥有的东西,大家都在谈我们可能会拥有什么。所以用潜力来评判,完全符合Vibe Coding的精神。"
这句半开玩笑的话,恰恰点出了当下AI产品演示的通病:精心剪辑的demo可以让任何半成品显得无比惊艳,但真实上手时的落差往往巨大。Casey那句"这就是你真正上手玩demo视频里的游戏时的样子",是对整场闹剧最清醒的注脚。
对AI开发者的几点启示
这场看似胡闹的挖掘游戏比拼,其实浓缩了当前Vibe Coding的真实图景:
- 原型速度惊人,但完成度是硬门槛。AI能在几小时内生成可运行的游戏骨架,却难以自动补齐游戏设计常识和最后10%的打磨。
- 叙事和创意是人类的护城河。TJ的胜出靠的不是技术,而是一个精准戳中团队内梗的好点子。
- 训练数据决定输出天花板。无论是代码质量还是内容引用,模型都在忠实反映它学过的东西。
- 警惕"潜力叙事"。demo的光鲜和产品的可玩性之间,隔着大量看不见的工程债务。
相关推荐

看懂n8n工作流只需四要素:触发、数据、逻辑、动作
学n8n自动化不要只会抄模板。掌握触发、数据、逻辑、动作四个核心要素,你就能看懂任何工作流、独立搭建并在出错时快速调试,从模板搬运工进阶为真正的自动化构建者。
混合RAG检索实战:Dense+BM25+RRF与重排序完整解析
深入解析开源项目 ReRankEval 混合 RAG 检索管线:稠密向量搜索、BM25、RRF 倒数排名融合与 LLM 重排序如何协同,以及用 Hit Rate、MRR、NDCG 科学评测检索质量的完整方法。

Browser MCP 登录会话保活:AI Agent 自动化的隐形门槛
AI Agent 接入 Browser MCP 后登录会话过夜失效、重复认证烧掉大量 token,是自动化落地的常见痛点。本文剖析会话持久化难题的本质,并给出持久化 profile、会话解耦、凭证轮换应对等务实思路。