拆分会话省下近四成成本:Claude Code省钱的真正杠杆

真实数据显示,Claude Code账单的76%来自对话历史的反复重读,拆分长会话比优化指令文件节省更多。
一位创作者用一周676条Claude Code对话记录做了成本拆解,发现约76%的消耗来自缓存读取——即每一轮对话都要把此前的全部历史重新发送给模型,主线程中位数请求携带约33.8万token。相比之下,Anthropic官方力推的指令文件优化(如精简CLAUDE.md)在其数据中仅占缓存写入的3.2%,几乎可以忽略不计。模拟将长会话一拆为二并加入简短交接后,成本下降约37.8%。核心结论是:会话长度才是成本的主要驱动因素,及时结束会话并用简短摘要开启新对话,是最有效的降本手段。
被忽视的最大成本:对话的反复重读
如果你为 AI 编程工具付费,官方给出的省钱建议往往指向一个较小的杠杆——优化指令文件。但一位 YouTube 创作者用自己真实的 Claude Code 使用数据做了测量,得出了一个与直觉相悖的结论:真正吞掉开销的,是整段对话在每一轮被重新发送给模型。
他在一周内收集了自己的 676 条 Claude Code 对话记录(测量日为 9 月 18 日,此后未再重跑),并以此为样本进行拆解。结论直白:重读对话占了他 AI 编程支出的约四分之三,而精简指令几乎省不下什么。
数据拆解:76% 的消耗来自缓存读取
先厘清几个概念。Token 是文本单位,模型读取时大约 3/4 个单词算一个 token;cache read(缓存读取)指服务商以更低价格复用已存储的对话,而非从头处理。
在他的主线程(也就是实际输入的对话窗口)中:
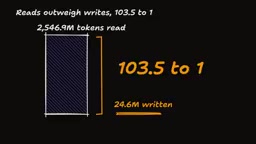
- 从缓存读取了 2546.9 百万 token
- 仅写入了 24.6 百万 token
- 两者比例约 103:1
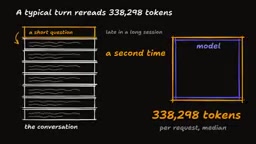
按 list price(标价)加权后——作者强调这个加权是他自己的推导——读取部分约占总消耗的 76%。更惊人的是中位数请求:主线程中位数请求携带了 338,298 个 token。这基本意味着,典型的每一轮对话都要把整段历史重读一遍。
设想一个场景:你在一段很长的会话末尾只输入了一句简短的提问,模型仍然会第二次接收整段对话——无论它已经增长到多长。这就是成本的来源。
缓存机制的定价逻辑值得稍作说明。以 Anthropic 的 Claude API 为例,prompt cache read 的价格通常是普通输入 token 价格的约十分之一(具体倍率随模型版本而异)。这意味着即便缓存读取在 token 数量上远多于普通输入,其单价折扣也会压低绝对费用——这正是"缓存"本身的设计初衷。然而作者的数据揭示了一个规模效应:当缓存读取的 token 量达到写入量的 103 倍时,哪怕单价只有十分之一,其在总账单中的占比依然高达 76%。换句话说,折扣并没有消除问题,只是把临界点往后推了——会话一旦足够长,缓存读取的绝对费用依然会主导账单。
指令优化:真实但很小的杠杆
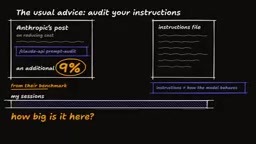
Anthropic 官方的降本文章建议对指令文件运行一个 prompt 审计命令,也就是在你输入任何内容之前就告诉模型如何行事的那些文件(如 CLAUDE.md)。官方给出的数据是:移除冗余模式后,成本额外下降约 9%。
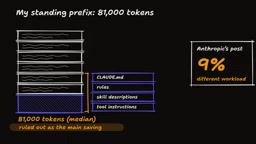
但在作者自己的数据里,这个杠杆小得多。他的 standing prefix(固定前缀,包括 CLAUDE.md 规则、技能描述和连接的工具指令)中位数为 81,000 token,仅占主线程缓存写入的 3.2%。
作者特别提醒不要混淆两个口径:3.2% 是缓存写入中的占比,而 76% 是总消耗中的占比,分母不同,不能相减。因此重构这些指令文件几乎省不下钱。
这并不意味着 Anthropic 的 9% 是错的——那是不同的工作负载。作者的会话跑得异常地长,这正是分歧的根源:在短会话场景下,指令审计是有效的;但在长会话场景下,它被会话长度本身的成本彻底盖过。
真正的省钱动作:及时拆分会话
作者做了一次模拟:把一段长会话拆成两段,用他真实的增长曲线回放,并在每段新会话开始时加入一次简短的交接重读。结果——成本下降约 37.8%。
原理很简单:每一轮都会重读此前的全部内容,这意味着会话跑得越久,每一条新消息的代价就越高。成本是随会话长度累积的,而不是随指令长度。
他的核心结论是:会话长度决定成本,所以要更早地结束会话。 指令审计是一个真实的杠杆,但在他这一周里只是个小杠杆。
这一成本结构在数学上等价于一个梯形面积问题:每一轮对话的成本等于"当前累计 token 数",而整段会话的总成本是各轮成本之和,随轮次呈二次方增长。相比之下,拆分会话并加入简短交接相当于把一个大梯形切成两个更小的梯形,面积之和显著低于原来——即便交接本身会引入少量额外 token。37.8% 的模拟降幅正是这一几何关系的体现:切割点越早、会话越均匀,节省效果越明显。这也解释了为什么"任务完成后立即开新会话"是比任何提示词优化都更高杠杆的操作——它直接改变了成本函数的形状,而不只是调整某个系数。
可落地的操作建议
作者给出的行动路径有两步:
- 先统计自己一周的用量。 不要照搬别人的数字,自己的工作负载决定了哪个杠杆更大。像作者这样会话异常长的用户,拆分会话收益显著;而短会话用户可能更适合优化指令。
- 任务完成后,用一条简短的摘要笔记开启新会话。 用一次性的短交接取代无限增长的历史重读,是把成本曲线压平的最直接方式。
这篇分析的价值不在于某个具体数字,而在于它用真实数据挑战了默认建议,并提醒每个付费用户:省钱的最大杠杆,可能就藏在你一直没留意的会话长度里。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。