拆解DeepSeek V3:557万美元训出671B参数模型的四大工程秘密

DeepSeek V3用四项叠加工程决策,将671B参数模型的训练成本压至557.6万美元。
DeepSeek V3是一个671B总参数的混合专家(MoE)模型,但每次生成token仅激活37B参数,实现了知识容量与计算成本的解耦。论文拆解出四项关键工程决策:一是MoE路由机制本身带来的激活稀疏性;二是通过调整路由偏置项而非在损失函数中加惩罚项来实现256个专家的均衡利用;三是沿用MLA压缩注意力KV缓存并首次在671B规模验证FP8混合精度训练的稳定性;四是引入多token预测目标提升训练效率。四项决策叠加,最终整个预训练过程仅耗费278.8万GPU小时、557.6万美元,且全程零回滚、零不可恢复的损失尖峰。论文自报的基准数据显示DeepSeek V3在MMLU上以88.5分超越参数量更大的Llama 3.1 405B,但所有成本与性能数据均为自报,排除了失败实验耗时,需保持恰当怀疑。
一份仍挂在arXiv上、被研究者反复引用的技术报告,抛出了一个看起来"不可能"的数字:671B参数的DeepSeek V3,整个训练过程只花了557.6万美元。这不是摘要、不是泄密、也不是二手转述,而是逐行拆解论文本身得出的结论。油管博主对这份报告做了硬核逐行解读,把这个看似违反直觉的成本数字,落到了四个具体的工程决策上。
本文基于该视频的完整拆解,梳理DeepSeek广告 V3如何用一套"叠加式架构"把GPU小时数压到极限——记住一个数字:278.8万GPU小时,全片的所有计算都建立在它之上。
671B 与 37B:参数量和算力成本的分离
DeepSeek V3是一个混合专家(Mixture of Experts,MoE)模型,共61层Transformer,每层的隐藏维度为7168。每一层里内置1个共享专家,外加256个独立的路由专家——每个专家都是一个更小、更专门化的子网络,共存于同一层内。
关键机制在于:模型每生成一个token,一个小型路由器只会激活256个路由专家中的8个,再加上那个始终在线的共享专家。因此虽然模型总参数高达671B,但任意单个词的实际计算只用到37B参数。
这个差距正是整件事能负担得起的根本原因。总参数量描述模型"知道多少",激活参数量描述生成一个词"实际花多少算力"。你按一个小模型的算力付费,却存储着一个大模型的知识。这不是省钱的花招,而是MoE架构的核心逻辑。
MoE(混合专家)架构并非DeepSeek首创,其思想可追溯到1991年Jacobs等人的论文,近年来由Google在Switch Transformer、GLaM等项目中大规模复兴。传统密集模型(Dense Model)中,每一层的全部参数都参与每次前向计算,参数量与每次推理的浮点运算量(FLOPs)几乎正比增长。MoE的本质突破在于将这两者解耦:可以无限扩大"存储在模型里的知识总量"(总参数),而推理成本只由"每次激活的专家数"决定。代价是额外的路由逻辑、专家之间的通信开销,以及均衡难题——这正是后文几个工程决策集中要解决的问题。理解这一解耦关系,是读懂"671B却只花37B算力"这句话的前提。
让256个专家都干活:无辅助损失的负载均衡
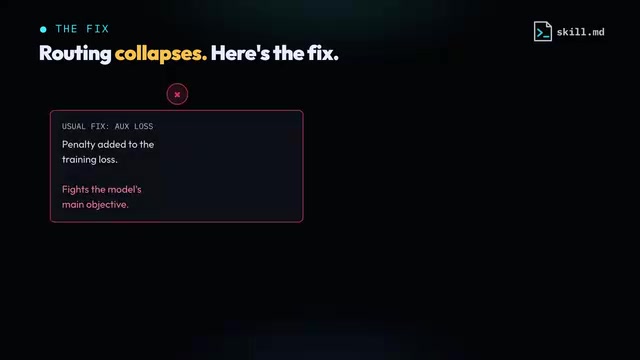
搭建这类系统会立刻遇到一个问题:路由器在训练中容易"坍缩"。它会反复依赖少数几个偏爱的专家——因为这些专家早期碰巧多练了几次,就变得稍好一点,路由器于是把更多流量导向它们,形成正反馈。结果剩下200多个专家闲置、训练不足,白白浪费了当初设256个专家想要的容量。
行业惯用做法是在训练损失里加一个惩罚项,一旦路由失衡就扣分。但这个惩罚会与模型真正的目标——预测下一个词——正面冲突。
DeepSeek V3的做法不同:它在每个专家的路由分数上直接加一个偏置项(而非在损失函数上),并在训练中持续调整这个偏置,把流量不断推向那些被忽视的专家。这相当于实时"扳动"决策本身来实现均衡,而不是在决策做完之后再事后惩罚模型。
MLA 与 FP8:把内存和精度成本砍到极限
第二块拼图关乎内存而非算力。DeepSeek V3沿用了上一代DeepSeek V2的注意力机制——MLA(多头潜在注意力,Multi-head Latent Attention)。
常规注意力会为生成过程中的每一个token缓存完整的Key向量和Value向量,回答一长,这个缓存就变得巨大。MLA则只缓存每个token的一个压缩潜在向量,在真正需要时才重建出完整的Key和Value——就像存一个压缩包,只在用到时解压其中一部分。据DeepSeek在前代模型论文中的同口径对比,这带来了约60%更小的缓存和5.76倍的生成吞吐量,而且性能不降反升。
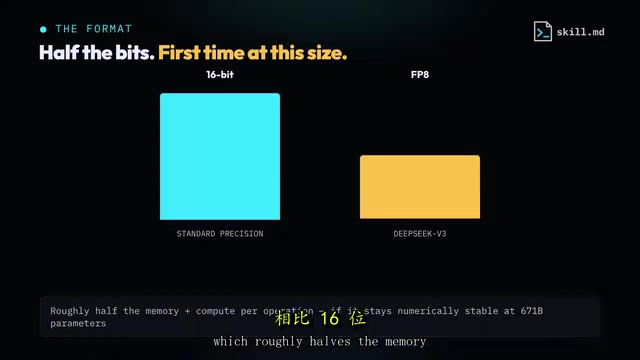
第三块拼图是数字格式本身。多数大模型用16位精度训练内部数值,以保证稳定,代价是真实的内存开销。DeepSeek V3在网络的大部分区域采用FP8(8位浮点),相比16位大约把每次运算的内存和计算成本减半——前提是你能在这个规模上保持数值稳定。而"前提"二字分量极重:8位数字精度空间小得多,更容易溢出和舍入出错,模型越大,误差累积越可能彻底毁掉训练。论文将其定位为首次真正验证细粒度8位混合精度在671B规模下依然稳定。
标准多头注意力(MHA)的KV缓存问题在长序列推理中尤为突出:每生成一个新token,模型需要保留此前所有token的Key和Value向量以计算注意力权重,序列越长,显存占用呈线性膨胀,最终成为限制批处理大小和吞吐量的瓶颈。MLA的压缩思路属于"低秩投影"范式——将高维KV向量投影到一个更小的潜在空间存储,推理时再通过学好的上投影矩阵还原。这与量化(Quantization)是正交的两种压缩手段:量化压缩每个数值的比特宽度,低秩投影压缩需要存储的向量数量本身。两者叠加使用,是DeepSeek V3同时压缩内存占用与带宽需求的关键路径。
FP8训练的挑战值得单独说明。IEEE 754标准的FP16拥有约3.3万的动态范围和约3位有效十进制数字的精度,而FP8(E4M3格式)动态范围仅约448、尾数位进一步压缩,极易在梯度更新中产生下溢(underflow)或上溢(overflow)。工业界通常的应对是"混合精度训练":前向与反向传播用低精度加速,权重主副本与梯度累积用FP32维护。DeepSeek V3在此基础上进一步细化了量化粒度(per-tile/per-block而非per-tensor),以在更低精度下维持数值稳定,这也是论文将671B规模FP8稳定性作为独立贡献列出的原因。
多token预测与"零回滚"的训练奇迹
第四块是个"名头很大、体量很小"的改动。标准训练只让模型预测紧接着的下一个token,一次一个词,重复上万亿次。DeepSeek V3在训练中并行加入了第二个目标,额外预测再往后一个token(论文称预测深度为1)。这个纸面上不起眼的改动,对训练质量和生成速度都有可度量的实际提升。
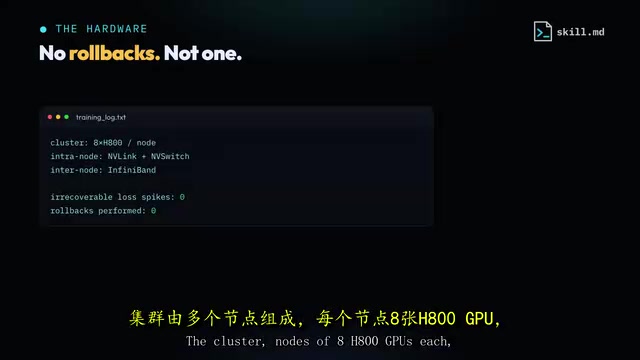
真正运行这套系统的硬件是:每节点8张H800 GPU,节点内用NVLink和NVSwitch互联,节点间用InfiniBand。而最惊人的一句话是,论文明确写道:整个预训练过程中,没有出现任何不可恢复的损失尖峰,也没有执行任何回滚。对于这种规模、又跑着一个从未在此量级验证过的训练格式的运行来说,这绝非小事——一次中途不可恢复的尖峰就可能损失数周时间。
557.6万美元的成本账,以及应有的怀疑
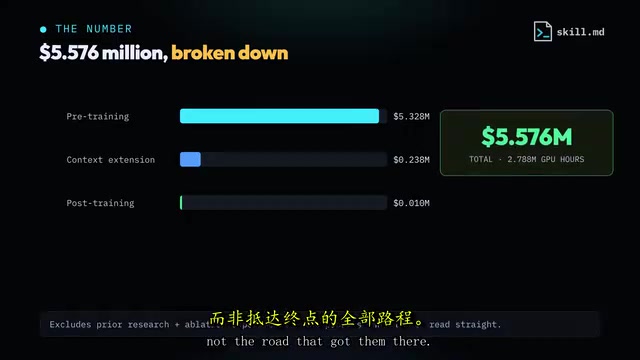
把开头的数字完整摊开:预训练266.4万GPU小时、532.8万美元;把上下文窗口从3.2万token扩展到12.8万token,额外11.9万GPU小时、23.8万美元;后训练与对齐5000 GPU小时、23.8万美元。合计278.8万GPU小时、557.6万美元。
论文自己的免责声明也需原样呈现:这个数字排除了所有研究探索和失败实验的耗时,只是最终成功那一次运行的成本,而不是走到这一步的整条路。
那557.6万美元换来了什么?在MMLU这一通用知识基准上,DeepSeek V3得88.5分,超过Meta的Llama 3.1 405B的84.4分——而后者每token常驻激活的算力约为前者的10倍。在竞赛级数学基准上得61.6分。但这些都是论文自报数据,而非独立榜单结果,值得与成本数字同等程度的怀疑:这是公司在自选的考卷上给自己打分。
对比参照系有助于校准这个数字的量级。GPT-4训练成本的业界估算普遍在1亿美元量级(来源为SemiAnalysis等机构的独立推算,OpenAI未公布官方数字);Meta公开的Llama 3训练使用了超过1600万GPU小时的H100算力,按市价折算远超千万美元。H800是H100的出口管制降规版,在NVLink带宽和FP8算力上有一定损失,因此278.8万H800小时与等量H100小时的实际算力并不完全可比。此外,"自有集群"与"云租用"的成本结构差异巨大:DeepSeek母公司幻方科技早年已大量采购GPU,折旧摊销方式不同会使相同硬件对应截然不同的账面成本。这些变量并不推翻论文的数字,但提示读者:557.6万美元是一个特定会计口径下的结果,而非放之四海皆准的行业对标值。
叠加式架构,而非单一银弹
四个决策里没有任何一个能单独解释557.6万美元这个数字:MoE路由决定哪37B参数被唤醒;无辅助损失的均衡让256个专家都真正出力;MLA压缩每次请求需要记住的内容;FP8与多token预测则压缩训练过程本身的算力成本,并让整个运行零回滚地跑完。抽掉任意一个,剩下三个都凑不出同一个数字。这是一套叠加起来的架构,而不是靠某个灵丹妙药。
最后是几点诚实的保留:这是DeepSeek自报的数字,目前不存在任何外部审计;成本排除了所有消融实验和失败运行;基准分数同样是自报。但这些都不会让底层的工程变假——架构选择在论文里被记录得足够详细,任何人都能自己动手复核。一个如此漂亮的数字,值得的正是这样恰到好处的怀疑,既不为零,也不过度。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。