长期AI智能体缺失的激励层:主从框架与运行时架构

论文主张AI智能体的激励应是运行时契约而非提示词,实验证明资源分配有效而语言激励无效。
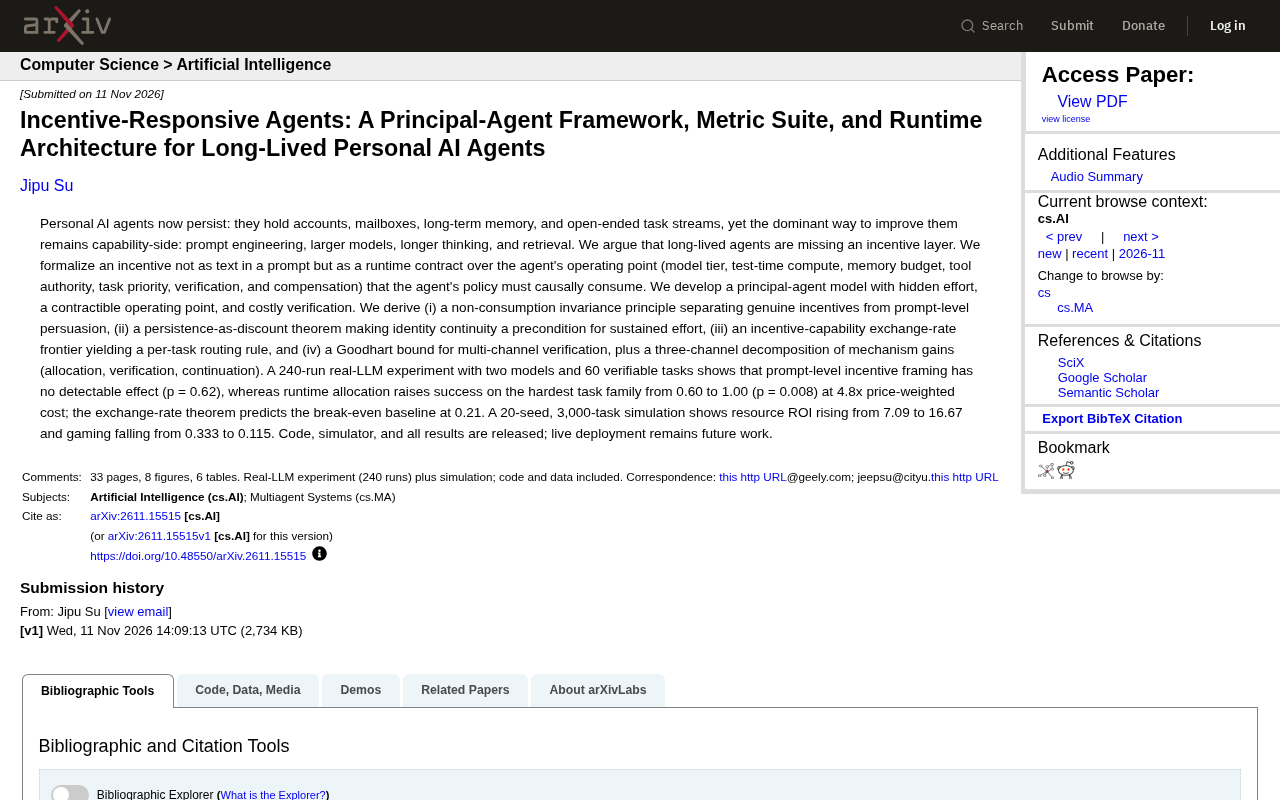
文章介绍了一篇关于长期在线个人AI智能体激励层的新论文。作者指出,当前提升智能体能力的主流方法集中在提示词工程、更大模型和更长思考时间等能力侧,却忽略了激励层。论文将激励形式化为作用于智能体运行点(模型层级、计算量、记忆预算、工具权限、验证与补偿机制)的运行时契约,并提出非消费不变性原理:若策略不因果性消费某参数,调整该参数就不构成激励。由此解释为何提示词中的奖励承诺往往无效。论文构建主从模型,得出持久性折现定理、激励-能力交换率前沿和多通道验证的Goodhart上界三个结论。240次真实LLM实验显示提示词激励无显著效果(p=0.62),而运行时分配将最难任务成功率从0.60提升到1.00(p=0.008),代价为4.8倍成本;模拟显示资源ROI上升、博弈行为下降。
个人AI智能体正在变得“长期在线”:它们持有账户、管理邮箱、维护长期记忆,并处理开放式的任务流。然而,提升它们能力的主流方法仍集中在能力侧——提示词工程、更大的模型、更长的思考时间以及检索增强。一篇新论文指出,长期存活的智能体缺失了一个关键层面:激励层。
为什么提示词层面的激励不起作用?
研究团队将激励形式化为一种运行时契约,而非提示词中的文本。这种契约作用于智能体的“运行点”,包括模型层级、测试时计算量、记忆预算、工具权限、任务优先级、验证机制和补偿机制。智能体的策略必须因果性地消费这些运行点参数,激励才会真正生效。
为了区分真正的激励与提示词层面的说服,论文推导出一个非消费不变性原理:如果智能体的策略没有因果性地使用某个运行点参数,那么对该参数的调整就不构成激励。这解释了为什么在提示词中写入“如果你做好这件事,我会给你更多资源”往往无效——因为资源分配并未真正与智能体的行为挂钩。
主从模型与三个理论结果
论文构建了一个主从模型,其中委托人(用户或系统设计者)设定契约,代理人(智能体)付出隐藏的努力。契约可观测的是运行点,验证是有成本的。在此基础上,作者得出几个关键结论:
- 持久性作为折现定理:身份连续性(即智能体知道自己会长期存在)是持续付出的前提。如果智能体预期自己会被重置或替换,它对长期回报的折现率会升高,努力水平随之下降。
- 激励-能力交换率前沿:在给定任务下,存在一个激励与能力之间的权衡边界,由此可以推导出逐任务的路由规则——什么任务值得分配更多资源,什么任务应该降低投入。
- 多通道验证的Goodhart上界:当验证信号有多个通道时,智能体操纵单一指标的空间受到限制,机制收益可以分解为分配、验证和延续三个通道。
主从模型(principal-agent model) 源自契约经济学与信息经济学,用来刻画委托人与代理人之间在信息不对称和目标不一致下的激励设计问题。委托人(如雇主、平台或用户)希望代理人(如员工、承包商或智能体)付出难以直接观测的努力,但只能观测到与努力相关的部分信号。经典结论包括:在努力不可观测时,固定工资无法诱导最优努力,必须让报酬与可观测绩效挂钩;但绩效指标又可能被代理人操纵(即多任务下的激励扭曲)。本文把这一框架移植到AI智能体场景:委托人是系统设计者,代理人是在线智能体,可观测信号是“运行点”参数(模型层级、计算量、记忆预算等),验证有成本,从而将“给智能体发提示词”替换为“设计一份可执行的运行时契约”。理解这一模型有助于看清论文为何强调契约必须被智能体策略因果性消费,以及为何单指标验证会引发操纵。
Goodhart定律 常被表述为“当一个指标成为目标时,它就不再是一个好指标”。在AI智能体语境下,它指智能体会针对被验证的单一成功指标进行优化甚至投机,而不是真正完成任务。论文提出的“多通道验证的Goodhart上界”正是对该定律的机制化处理:当验证信号由多个相互独立的通道构成时,智能体操纵全部通道或绕过验证的成本上升,单一指标的操纵空间被压缩,机制收益可分解为分配、验证与延续三个通道。这为设计者提供了一个可计算的约束边界——不是简单增加指标数量,而是确保各通道对智能体行为的覆盖与交叉验证,从而在机制层面抑制“刷指标”行为,而非依赖提示词中的道德劝说。
实验结果:提示词无效,运行时分配有效
论文进行了一项包含240次运行的真实LLM实验,涉及两个模型和60个可验证任务。结果非常鲜明:
- 提示词层面的激励框架没有可检测的效果(p = 0.62)。也就是说,在提示词中描述激励结构,对任务成功率没有显著影响。
- 运行时分配将最难任务族的成功率从0.60提升到1.00(p = 0.008),代价是价格加权成本变为4.8倍。交换率定理预测的盈亏平衡基线为0.21——在这个基线之上,增加资源投入是划算的。
此外,一个20种子、3000任务的模拟显示,资源ROI从7.09上升到16.67,而“博弈”(智能体针对指标进行操纵的行为)从0.333下降到0.115。这表明合理的激励设计不仅能提升产出,还能抑制投机行为。
价格加权成本(price-weighted cost) 是论文衡量资源投入的指标,它把不同运行点(如更高层级模型、更多测试时计算、更大记忆预算、更宽工具权限)按各自单价加权求和,反映“为了提升任务成功率到底多花了多少钱”。实验中运行时分配把最难任务族成功率从0.60提升到1.00,但价格加权成本变为4.8倍,意味着每单位成功率的边际成本显著上升。交换率定理给出的盈亏平衡基线0.21,表示只有当基线成功率低于该阈值时,追加资源才划算;高于该阈值则说明任务已较易完成,继续加资源不经济。这一指标把“值不值得投入”从直觉判断变成可计算的ROI决策,是逐任务路由规则的量化基础。
p值与统计显著性:论文报告提示词层面激励框架的效果不显著(p=0.62),而运行时分配的效果显著(p=0.008)。p值表示在原假设(即该干预没有真实效果)成立时,观察到当前或更极端结果的概率。p=0.62意味着提示词干预的结果与“毫无效果”高度一致,几乎不能拒绝原假设;p=0.008则远低于常用的0.05阈值,说明运行时分配带来的成功率提升不太可能由随机波动解释。需要说明的是,p值小只说明“效果不太可能是偶然”,并不直接等同于效应量很大;论文同时报告了成功率从0.60到1.00的绝对提升与4.8倍成本,读者应结合效应量与成本一起判断实际价值。
对AI智能体设计的启示
这项工作的核心贡献在于将激励从“语言层面”拉回到“机制层面”。对于构建长期个人AI智能体的开发者而言,这意味着:
- 资源分配本身就是激励信号。动态调整模型层级、计算预算和工具权限,比在提示词中承诺奖励更有效。
- 身份连续性需要被设计。智能体需要感知到自己的长期存在,才能对长期目标付出持续努力。频繁重置或替换智能体会破坏这种连续性。
- 验证机制需要多通道。单一的成功指标容易被智能体“钻空子”,多通道验证可以约束这种行为。
论文的代码、模拟器和所有结果均已开源,但实时部署仍属于未来工作。这为AI智能体的激励设计提供了一个可操作的理论框架和初步的实证支持。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。