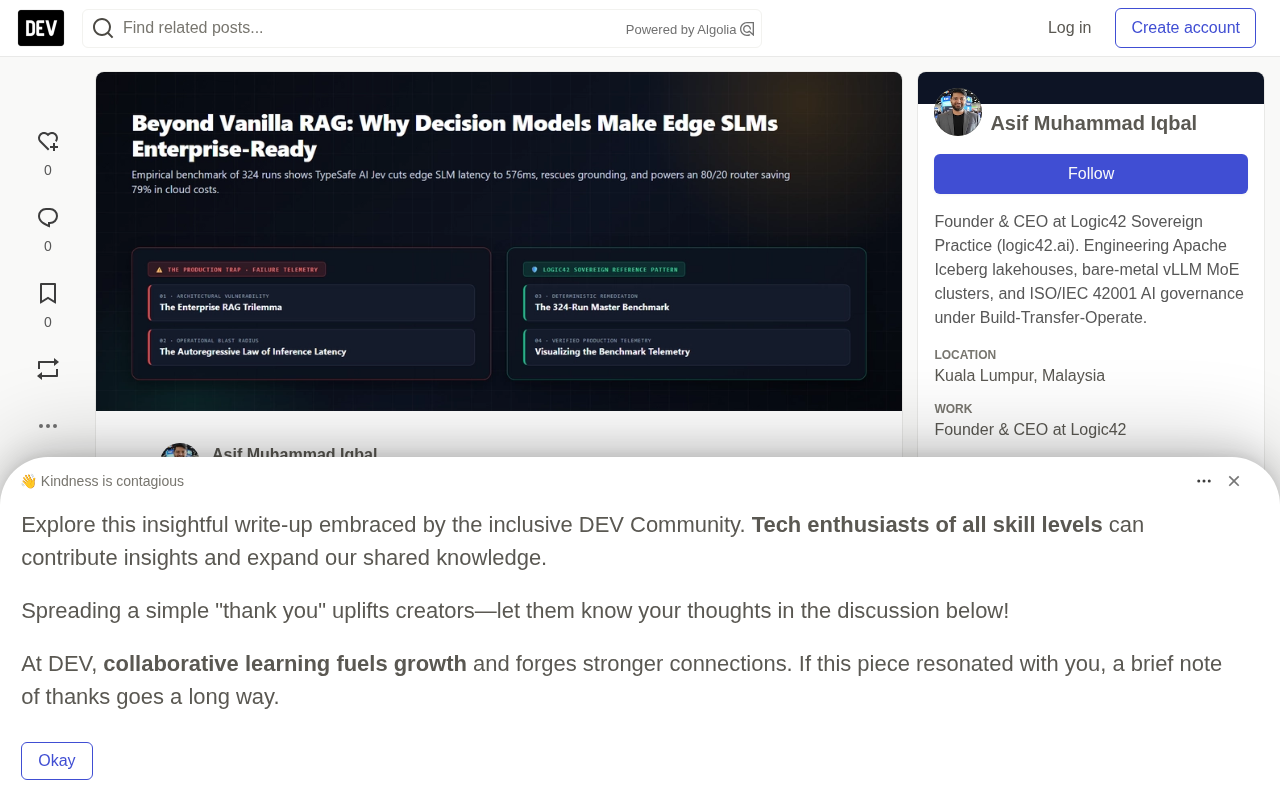
超越Vanilla RAG:决策模型如何让边缘SLM达到企业级

Logic42 Lab实验表明,预生成决策模型路由可让边缘小模型达生产级可用,云支出降79.1%。
传统RAG架构在企业边缘部署中面临生成延迟、事实召回率和成本隐私的三角困境。Logic42 Lab的324组全因子实验表明,在生成之前引入决策模型进行意图路由,可以让7B以下的边缘小模型达到生产级可用性。核心发现包括:正则辅助RAG虽能削减37.3%延迟但损失22.4%召回率;TypeSafe AI Jev在0.2毫秒内完成意图分类,匹配正则速度的同时恢复召回率,在Qwen 7B上实现最高Token效率η=0.930。基于Jev的80/20混合路由将80%常规查询路由至边缘SLM,实现79.1%的云成本削减。其物理基础是自回归推理延迟法则:减少输出token量是在本地硬件上加速生成的唯一物理机制。
传统RAG架构在企业边缘部署中面临一个棘手的三角困境:生成延迟、事实召回率和成本隐私,三者难以兼得。Logic42 Lab的一项324组全因子实验表明,在生成之前引入决策模型进行意图路由,可以让7B以下的边缘小模型达到生产级可用性,同时将企业云支出削减79.1%。
企业RAG的三角困境
为电信网络运营中心、光纤开通和账单争议等高 stakes 场景设计对话式AI时,架构师面临三个相互拉扯的约束:
- 生成延迟需控制在600毫秒以内
- 事实召回率要求100%的策略准确性
- 边缘隐私与成本要求零云端API调用,完全本地运行
过去团队只能在不完美的方案中二选一。Vanilla RAG将用户查询与检索到的知识库片段直接送入无约束的大模型,虽然搭建简单,但会产生严重的token膨胀——模型在 recite 政策代码之前,先花数百毫秒生成“感谢您联系客服,我很乐意帮您……”之类的对话填充语。而正则辅助RAG虽然能强制截断token预算,但正则表达式本身极其脆弱:无法推断极性、误解否定查询、截断关键事实。
预生成决策模型提供了第三条路。通过在生成token解码之前评估语义意图、紧急程度和输出预算,动态调整生成策略。据Logic42 Lab的基准测试,TypeSafe AI Jev引擎能在0.2毫秒内完成意图、极性和情绪分类。
自回归推理延迟的物理法则
要理解Vanilla RAG为何在边缘失败,需要回到GPU硬件物理。
Transformer推理分为两个阶段:并行的计算密集型预填充阶段和顺序的内存带宽密集型解码阶段。在单流边缘部署中,生成每个token都需要将整个模型参数张量流经GPU内存总线:
$$R_{\text{decode}} \approx \frac{BW_{\text{mem}}}{S_{\text{weights}}} \quad [\text{tokens/sec}]$$
以一个80亿参数模型4-bit量化后(约4.7GB)运行在NVIDIA RTX 4070移动GPU(约256GB/s带宽)上为例,解码速率上限约为54.4 tokens/秒,即每token约18.4毫秒。这构成了自回归推理延迟法则:
$$L(T_{\text{out}}) = \alpha \cdot T_{\text{out}} + \beta$$
其中α是每token的边际解码成本,β是预填充开销。内存带宽无法作弊,减少输出token量是在本地硬件上加速生成的唯一物理机制。
预填充与解码的关键差异在于计算模式。预填充阶段处理输入提示的所有token,可充分利用GPU的并行计算单元,属于计算密集(compute-bound)操作,通常在几十毫秒内完成。解码阶段则需逐个生成token,每次前向传播都要从显存中读取完整的模型权重,属于内存带宽密集(memory-bound)操作。这意味着解码速度几乎完全由显存带宽与模型权重大小的比值决定,与GPU的浮点算力关系不大。因此,在边缘部署中升级GPU的计算核心数量对解码吞吐几乎无帮助,降低量化精度(减小权重体积)或减少输出token数才是有效手段。
324组基准测试的核心发现
Logic42 Lab在四个电信运营域——光纤宽带、账单争议、5G网络运维、合约升级——中评估了三种模型规模在三种路由机制下的表现。所有测试运行在NVIDIA RTX 4070笔记本GPU(8GB VRAM)上。
三个决定性模式浮出水面:
正则削减延迟但摧毁召回率。 在Qwen 1.7B上,编译正则Trie将中位延迟从905.2毫秒降至567.5毫秒(加速37.3%),但刚性关键词匹配导致召回率从83.1%骤降至60.7%,损失22.4个百分点。
Jev匹配速度同时挽救召回率。 TypeSafe AI Jev达到与正则相当的延迟(576.2毫秒 vs 567.5毫秒,统计验证t=8.138, p=1.38×10⁻⁹),同时将召回率恢复至65.7%,在复杂的合约升级场景中实现18.0%的召回率提升。在Qwen 7B上,Jev实现了研究中最高的Token效率(η=0.930)。
解耦的运维动作低于1毫秒。 当紧急光纤中断或基站故障发生时,Jev在不到一毫秒内触发工单路由和技师调度,将后端修复与LLM文本生成完全解耦。
Token效率η是评估生成系统经济性的关键指标,定义为有效信息token数与总输出token数之比。η越高,说明模型输出的token中用于传递事实信息的比例越大,冗余的对话填充语越少。在边缘部署中,η直接决定了推理延迟和能耗——因为每个冗余token都要消耗一次完整的内存带宽读取周期。Jev在Qwen 7B上达到η=0.930,意味着超过93%的输出token承载了实际信息,远高于Vanilla RAG在同类任务中通常低于0.5的η值。这一指标比单纯的延迟数字更能反映架构的长期可扩展性。
80/20混合路由:云支出削减79.1%
将决策模型直接放在Gemini 3.8 Flash前面只带来微小的延迟改善(约2097毫秒 vs 2128毫秒)。原因在于公有云推理是网络主导的:广域网往返时间和TLS协商消耗约1.5秒,掩盖了微秒级的增益。
但Jev解锁了一个架构突破:80/20混合路由。将80%的常规查询(余额查询、故障查找、SIM卡更换)路由到边缘SLM,保留前沿云模型处理20%的模糊案例。
据Logic42 Lab的FinOps规模模型,这种路由策略在典型月度查询量下可实现79.1%的净成本削减。该模式与VRAM停放消除闲置GPU税、请求级AI FinOps成本归因等研究形成互补。
网络主导延迟是公有云推理的固有瓶颈。当模型部署在远程数据中心时,端到端延迟由三部分组成:广域网往返时间(RTT)、TLS握手协商开销和模型推理时间。在典型企业网络环境中,RTT和TLS协商合计可消耗1.2至1.8秒,而一个7B模型生成200个token的推理时间可能仅300至500毫秒。这意味着无论模型本身多快,云推理的延迟下限由物理网络距离决定。这也是为什么在云模型前加装决策模型只能带来微小改善——微秒级的分类增益被秒级的网络开销完全淹没。
企业架构启示
不要再将语言模型视为必须同时处理意图分类、运维路由和文本生成的单体黑盒。
当你用预生成决策模型解耦意图分类时,本地边缘SLM能在600毫秒内交付经过验证的技术准确性。常规客户分类不需要数百万美元的云API拨款。构建80/20混合基础设施,将常规任务路由到边缘芯片,把云预算留给真正需要前沿能力的推理问题。
正如Logic42 Lab创始人Asif Muhammad Iqbal所言:“减少输出token量是在本地边缘硬件上加速生成的唯一物理机制。你无法作弊GPU内存带宽。当用亚毫秒级决策模型将运维分类与生成文本解耦时,本地SLM能达到600毫秒以下的延迟,而不牺牲技术召回率。”
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。