ChatGPT vs Gemini vs Claude:谁能从零做出马里奥64?

三大AI模型克隆《超级马里奥64》对决,Gemini以可玩性胜出。
YouTube博主用同一提示词让ChatGPT 5.2、Gemini 3 Pro和Claude 4.5从零克隆《超级马里奥64》。ChatGPT生成2700行代码,画面最精美但帧率仅1-2帧;Gemini生成速度快、可玩性最强,迭代修复能力突出;Claude存在碰撞检测和操控问题,表现最弱。最终排名Gemini第一,测试表明3D游戏开发中多系统协调仍是AI的重大挑战。
当三大顶级AI模型被要求从零开始做一款《超级马里奥64》的克隆游戏时,结果会怎样?一位YouTube博主用同一个提示词分别测试了ChatGPT 5.2、Gemini 3 Pro和Claude 4.5,最终结果既有惊喜也有翻车。这场AI编程能力的正面对决,揭示了当前大语言模型在复杂3D游戏开发任务上的真实水平。
值得一提的是,《超级马里奥64》于1996年发布,是游戏史上第一款真正成功的3D平台跳跃游戏,由任天堂的宫本茂团队开发。尽管以今天的标准来看画面简陋,但其底层技术复杂度远超表面——游戏包含一套精密的角色状态机(马里奥有超过200种动作状态)、基于八叉树的碰撞检测系统、动态摄像机AI,以及针对N64硬件深度优化的渲染管线。原版游戏的C语言源代码约有50万行,经过数十位工程师两年多的开发和调试。要求AI在单次对话中复现这样一款游戏的核心体验,本质上是在测试AI对多个复杂系统协同工作的理解能力。
ChatGPT 5.2:画面最精美,帧率却只有1到2帧
测试从ChatGPT 5.2开始。开启思考模式后,ChatGPT花了整整8分钟才完成代码生成,一次性输出了2700行代码——这是博主见过的单次迭代中最多的代码量。
然而代码量大并不意味着质量高。第一次运行时,游戏画面看起来相当不错,但整个游戏处于冻结状态,完全无法操作。修复后的版本虽然可以移动了,帧率却低到令人发指——大约只有每秒1到2帧,基本处于"幻灯片"状态。
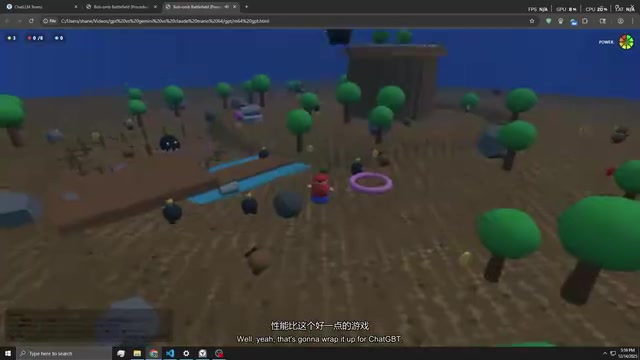
博主多次要求ChatGPT优化性能,甚至按照建议将某个参数调整为0.75来提升帧率,但效果微乎其微。最终ChatGPT的版本因为严重的性能问题无法正常游玩。不过从视觉效果来看,ChatGPT生成的画面质量确实是三者中最好的。
这暴露了一个值得关注的问题:ChatGPT倾向于生成更复杂、更精美的代码,但缺乏对浏览器端性能瓶颈的考量。 2700行代码中可能包含了大量未经优化的渲染逻辑,导致浏览器不堪重负。
浏览器中的3D游戏通常依赖WebGL(Web Graphics Library)技术,通过JavaScript调用GPU进行图形渲染。然而,与原生游戏引擎(如Unity或Unreal Engine)相比,WebGL存在显著的性能开销:JavaScript的垃圾回收机制会导致帧率波动,DOM操作与渲染管线的交互增加延迟,且浏览器的安全沙箱限制了对硬件资源的直接访问。一个未经优化的3D场景如果包含过多的draw call(绘制调用)、未合并的网格体或实时光照计算,很容易将帧率拖到个位数。专业的浏览器3D游戏开发者通常需要使用对象池、LOD(细节层次)系统和批量渲染等优化技术来确保流畅运行。ChatGPT显然没有将这些浏览器端特有的性能约束纳入考量。
Gemini 3 Pro:可玩性最强,综合体验最佳
Gemini 3 Pro的表现明显不同。首先它的生成速度快得多,几乎是即时完成。更方便的是,生成的游戏可以直接在聊天界面内运行,无需额外粘贴到HTML文件中。
初始版本存在一些明显的物理问题:地面摩擦力过大导致移动极慢,跳跃高度不够,Boss无法被击杀。但整体框架是可玩的,已经具备了基本的3D平台跳跃游戏体验。
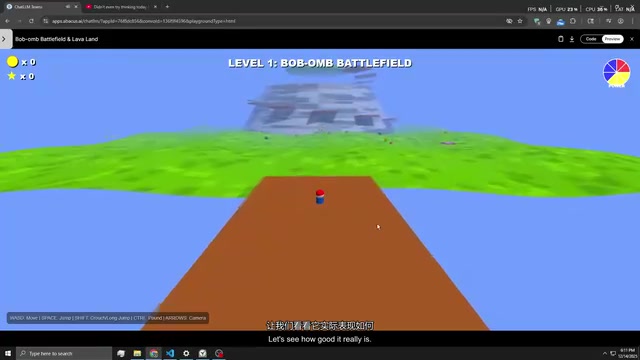
经过一轮反馈修复后,Gemini的版本有了质的飞跃:
- 移动手感大幅改善,角色操控流畅自然
- Boss战逻辑修复,可以通过跳踩击败敌人
- 新增了多个经典关卡,包括Womp's Fortress(砖块要塞)、Jolly Roger Bay(海盗湾)和Cool Cool Mountain(冰雪山)
虽然各关卡的质量参差不齐——Jolly Roger Bay几乎没什么可做的,Cool Cool Mountain只有一个雪人,但Womp's Fortress的设计相对完整,不会出现角色穿模等严重Bug。Gemini还自动生成了一个关卡选择的Hub区域,体现了它对游戏整体结构的理解。
Gemini的核心优势在于"可玩性优先"的策略。 它没有追求极致的视觉效果,而是确保了流畅的帧率和基本可用的游戏机制,这恰恰是游戏开发中最重要的基础。
Gemini在迭代修复中的优异表现,也反映了AI辅助编程正在从"一次性生成"向"对话式迭代开发"范式转变。这种模式类似于敏捷开发中的快速原型迭代:先生成一个最小可行产品(MVP),然后通过用户反馈不断改进。这对AI模型的能力提出了独特要求——不仅需要理解代码本身,还需要理解自然语言描述的Bug现象(如"移动太慢")与代码中具体参数(如摩擦系数、速度向量)之间的映射关系。Google DeepMind近期的研究表明,模型在"理解并修复已有代码"方面的能力增长速度,甚至超过了"从零生成正确代码"的能力增长。
Claude 4.5:中规中矩,碰撞检测问题严重
博主首先使用了Claude Sonnet 4.5进行测试。这个版本的问题非常明显:摄像机控制使用I、J、K、L键,操作极其反直觉,而且角色移动方向不会随摄像机旋转而改变,导致操控体验很差。
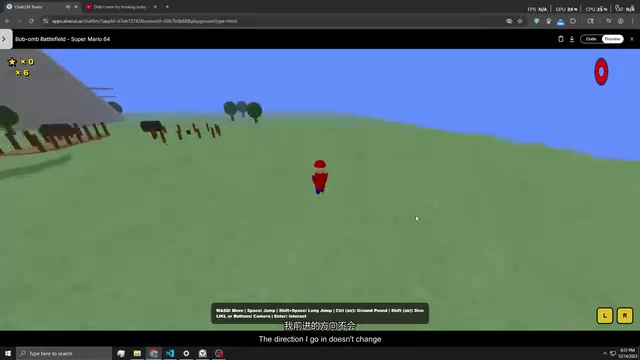
添加关卡后,各关卡的表现也不尽如人意。Cool Cool Mountain甚至出现了角色超音速移动的Bug,整体体验相当粗糙。
意识到使用了较弱的Sonnet模型后,博主又用Claude Opus 4.5重新测试。Opus版本确实有所改善:
- Goomba(栗子怪)的造型相对逼真,可以通过跳踩消灭
- 加入了Chain Chomp(铁球怪)等经典敌人
- 出现了一些有趣的交互,比如被敌人抓住后会被抛飞
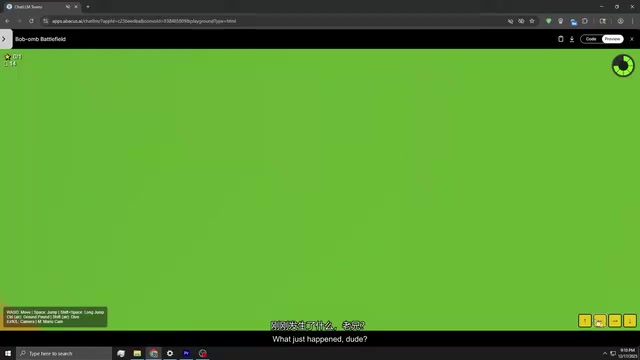
但Opus版本也有致命缺陷:平台碰撞检测存在严重问题,角色会直接穿过台阶,导致无法到达Boss战区域,还出现了莫名其妙的传送Bug。
碰撞检测(Collision Detection)是3D游戏开发中最具挑战性的技术之一。在3D空间中,碰撞检测需要实时判断数百个物体之间是否发生接触,常用方法包括AABB(轴对齐包围盒)、OBB(有向包围盒)和基于网格的精确检测。更复杂的是碰撞响应(Collision Response)——当角色踩上平台时,系统需要正确计算法线方向、阻止穿透、并施加适当的摩擦力。Claude版本中出现的穿模Bug通常源于离散碰撞检测中的"隧穿效应":当物体移动速度过快时,一帧内可能完全跨过薄平台而未被检测到。专业引擎通常使用连续碰撞检测(CCD)或射线投射(Raycasting)来解决这一问题,但这些技术的正确实现需要深厚的数学和物理学基础——这显然超出了当前AI单次生成代码的能力范围。
总体来说,Claude的两个版本都过于简单,缺乏完整的游戏体验。
三大AI模型编程能力排名与详细对比
博主给出的最终排名是:Gemini第一、ChatGPT第二、Claude第三。
| 模型 | 视觉效果 | 性能表现 | 可玩性 | 关卡丰富度 |
|---|---|---|---|---|
| ChatGPT 5.2 | ⭐⭐⭐⭐ | ⭐ | ⭐ | ⭐⭐ |
| Gemini 3 Pro | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| Claude 4.5 | ⭐⭐ | ⭐⭐⭐ | ⭐⭐ | ⭐⭐ |
三个模型表现出截然不同的编程风格,这与它们的训练数据、对齐策略和架构设计密切相关。ChatGPT(基于GPT系列)倾向于生成详尽、注释丰富的代码,这可能源于其训练数据中大量教程和文档类代码的影响;Gemini(基于Google的多模态架构)更注重实用性和运行效率,可能受益于Google内部大规模工程代码库的训练;Claude(基于Anthropic的Constitutional AI方法)则相对保守,倾向于生成安全、简洁但可能功能不完整的代码。此外,模型的上下文窗口大小也影响着代码生成质量——更大的上下文窗口允许模型在生成后续代码时"记住"前面的架构决策,从而保持代码的一致性和系统性。
这次测试反映了几个值得深思的趋势:
代码量≠代码质量
ChatGPT一次性生成2700行代码,但最终产出了一个几乎不可玩的游戏。相比之下,Gemini可能生成了更精简的代码,却实现了更好的游戏体验。在评估AI编程能力时,不能只看代码的"规模",更要看代码的"效率"和"实用性"。这一现象在软件工程领域有一个经典的对应概念——"代码膨胀"(Code Bloat),指的是程序包含了超出实际需要的代码量,导致性能下降和维护困难。优秀的软件工程实践强调YAGNI原则(You Aren't Gonna Need It),即不要实现当前不需要的功能。ChatGPT的表现恰恰违反了这一原则。
迭代修复能力决定实际可用性
Gemini在接收反馈后的修复能力表现最佳,能够准确理解"移动太慢""Boss无法击杀"等问题并有效修复。这种对话式迭代开发的能力,可能比一次性生成完美代码更有实际价值。在真实的软件开发流程中,需求变更和Bug修复占据了开发者60%以上的工作时间,因此AI模型的"修复智能"可能比"生成智能"更具实用意义。
3D游戏开发仍是AI编程的硬骨头
即便是表现最好的Gemini版本,距离真正的《超级马里奥64》也有天壤之别。3D游戏开发涉及物理引擎、碰撞检测、关卡设计、AI行为等多个复杂系统的协调,目前的大语言模型在单次对话中还难以处理这种级别的系统复杂度。这本质上是一个"组合爆炸"问题:当多个子系统需要同时正确工作时,任何一个环节的错误都会导致整体体验崩溃。物理引擎需要与碰撞系统配合,碰撞系统需要与关卡几何体配合,摄像机系统需要与角色控制配合——这种多系统耦合的复杂度呈指数级增长,远超当前AI模型的规划能力。
AI距离独立开发3D游戏还有多远
这场AI编程对决虽然带有娱乐性质,但它提供了一个直观的视角来观察不同模型的编程风格差异。ChatGPT追求"大而全",Gemini注重"稳而用",Claude则相对保守。对于开发者来说,选择哪个AI编程助手,取决于你更看重哪个维度——如果追求快速原型验证,Gemini目前是更务实的选择。
随着模型能力的持续进化,也许在不久的将来,AI真的能够从零生成一款完整可玩的3D游戏。但至少在今天,它们还需要人类的持续引导和反馈才能交出及格的答卷。从技术路线来看,未来的突破可能来自几个方向:更长的上下文窗口允许AI维护更复杂的代码架构;多智能体协作让不同的AI分别负责物理、渲染、关卡设计等子系统;以及与专业游戏引擎的深度集成,让AI不必从零实现底层技术,而是专注于创意层面的设计决策。
核心要点
- Gemini 3 Pro在三者中表现最佳,以流畅的帧率和可玩性取胜,成功实现了基本的3D平台跳跃游戏体验
- ChatGPT 5.2生成了2700行代码,视觉效果最好,但严重的性能问题(1-2帧/秒)导致游戏几乎不可玩
- Claude 4.5(包括Sonnet和Opus版本)整体表现最弱,存在操控反直觉、碰撞检测失败等问题
- Gemini的迭代修复能力最强,能准确理解反馈并有效改进物理系统、Boss逻辑和关卡设计
- 3D游戏开发仍是当前AI的重大挑战,涉及物理引擎、碰撞检测等多系统协调,单次对话难以完美处理
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。