Chess.com疑遭数据抓取,730万用户信息外泄
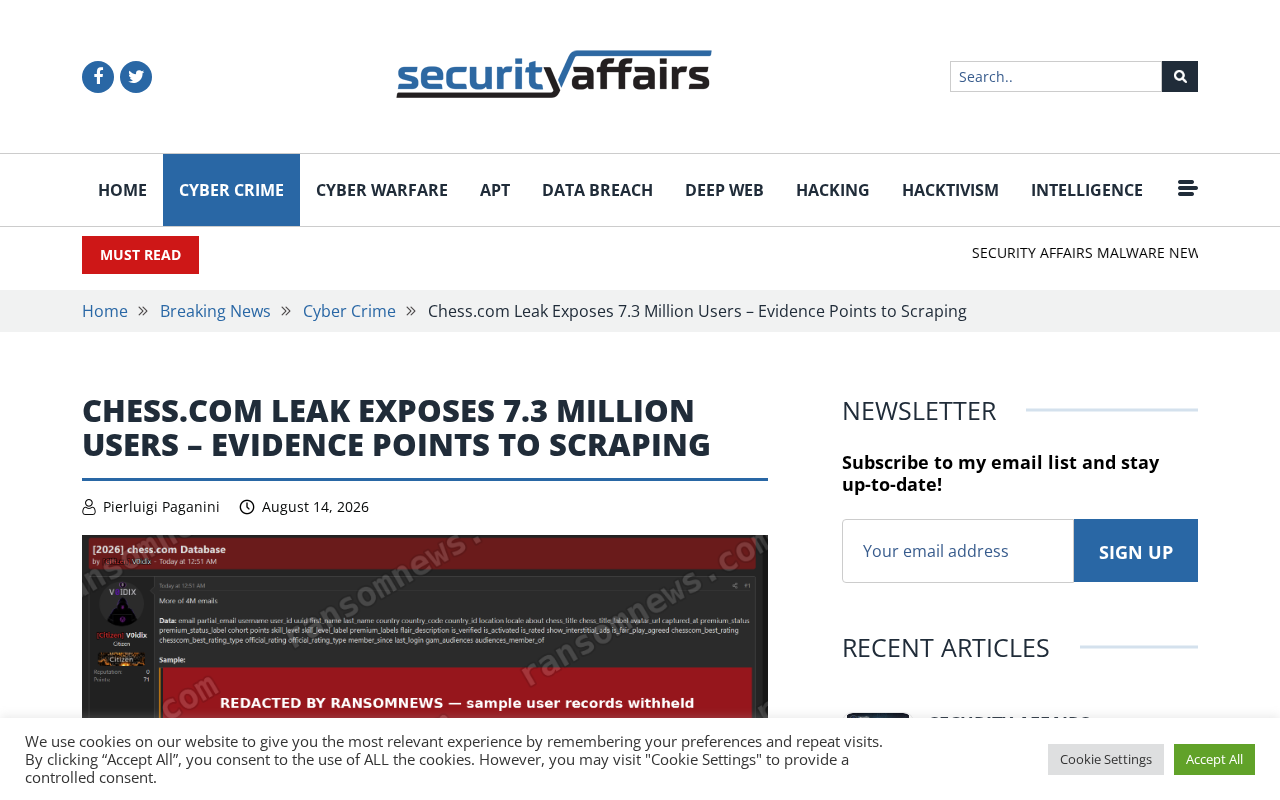
Chess.com约730万用户数据疑遭自动化抓取外泄,暴露API访问控制不足的行业痼疾。
Chess.com被曝约730万用户数据外泄,现有证据指向数据抓取而非传统黑客入侵——攻击者可能利用平台API访问控制与速率限制的不足,系统性地批量采集用户信息。此类事件的核心风险在于数据的规模化聚合:即便单条信息看似无害,数百万条结构化记录一旦落入攻击者手中,即可成为精准钓鱼和跨平台撞库攻击的弹药。这一模式与LinkedIn、Facebook等平台此前遭遇的大型抓取事件如出一辙,折射出API经济时代平台安全防护的系统性短板。用户当下应优先修改密码、避免跨平台复用,并启用双重验证,同时对涉及Chess.com的可疑邮件保持高度警惕。
事件概览
知名在线国际象棋平台Chess.com被曝出现大规模用户数据外泄,涉及约730万名用户的信息。与传统意义上的系统入侵不同,目前的证据更倾向于指向数据抓取(scraping)——即攻击者通过自动化手段大规模采集平台公开或半公开的用户数据,而非直接攻破核心数据库。
这一区分至关重要。数据抓取往往利用的是平台API接口的设计缺陷或访问控制不严,而非传统黑客攻击那样突破身份验证系统。对普通用户而言,这意味着泄露的数据可能主要是平台上原本就可被检索到的资料,但被大规模聚合后,其潜在滥用风险显著上升。
数据抓取为何值得警惕
很多人容易低估抓取类泄露的危害,认为"反正都是公开信息"。但现实情况远比这复杂。当数百万条用户资料被系统性汇总成一个结构化数据集时,它就成了钓鱼攻击、账户撞库和社会工程的高价值弹药库。
攻击者可以借助这些聚合数据,针对特定用户群体发起精准钓鱼——例如伪装成Chess.com官方发送"账户异常"通知,诱导用户点击恶意链接或输入密码。用户名与邮箱地址的对应关系一旦泄露,还可能被用于跨平台的撞库攻击,尤其是那些在多个网站复用同一密码的用户。
近年来包括LinkedIn、Facebook在内的多起大型数据事件,本质上都属于抓取而非直接入侵。这类事件反复提醒行业:仅靠"数据是否敏感"来评估风险已经不够,数据的规模与结构化程度同样是关键变量。
平台API安全的老问题
如果外泄确实源于抓取,那么问题的根源很可能在于API访问控制与速率限制(rate limiting)的不足。当一个接口允许在短时间内被高频调用而缺乏有效监测时,攻击者就能悄无声息地遍历大量用户数据。
对于用户体量庞大的平台,如何在开放性与安全性之间取得平衡始终是个难题。过于严格的限制会影响正常用户和第三方开发者的体验,而过于宽松则给自动化爬虫留下可乘之机。理想的做法包括:对敏感字段的访问施加更严格的鉴权、对异常访问模式进行行为分析、以及在数据聚合层面设置额外的防护。
用户应采取的应对措施
面对这类事件,用户端能做的防护相对有限,但仍然必要。首要的是修改Chess.com账户密码,并确保该密码未在其他平台复用。启用双重验证(2FA)能显著降低账户被撞库攻击接管的风险。
同时应对近期收到的、涉及Chess.com或象棋相关内容的邮件保持警惕,尤其是那些要求点击链接、验证账户或提供凭证的消息。可以通过Have I Been Pwned等服务查询自己的邮箱是否出现在已知的泄露数据集中。
结语
这起涉及730万用户的事件再次凸显,数据安全的边界早已超出"防止黑客入侵"的传统范畴。在API经济与开放数据日益普及的今天,如何防范大规模自动化抓取,已成为所有主流平台必须直面的课题。
需要说明的是,目前公开信息仍较为有限,事件的具体细节、Chess.com官方的回应以及泄露数据的完整构成尚待进一步确认。本文基于现有报道进行分析,后续进展仍需持续关注。
相关推荐
研发正在分叉:Token充裕型与Token匮乏型研究的未来之争
科技观察者指出研发世界正分叉为Token充裕型与Token匮乏型两条道路,头部AI团队和新型实验室凭借算力优势快速领跑。本文解析这一分化背后的算力竞争逻辑及其对高等教育研究的警示。
Atlas世界模型解析:下一视角预测如何统一生成与重建
Atlas世界模型以"下一视角预测"为核心,统一像素级生成与重建任务,为空间智能建模提供新思路。本文解析这一设计理念的技术意义与潜在价值。
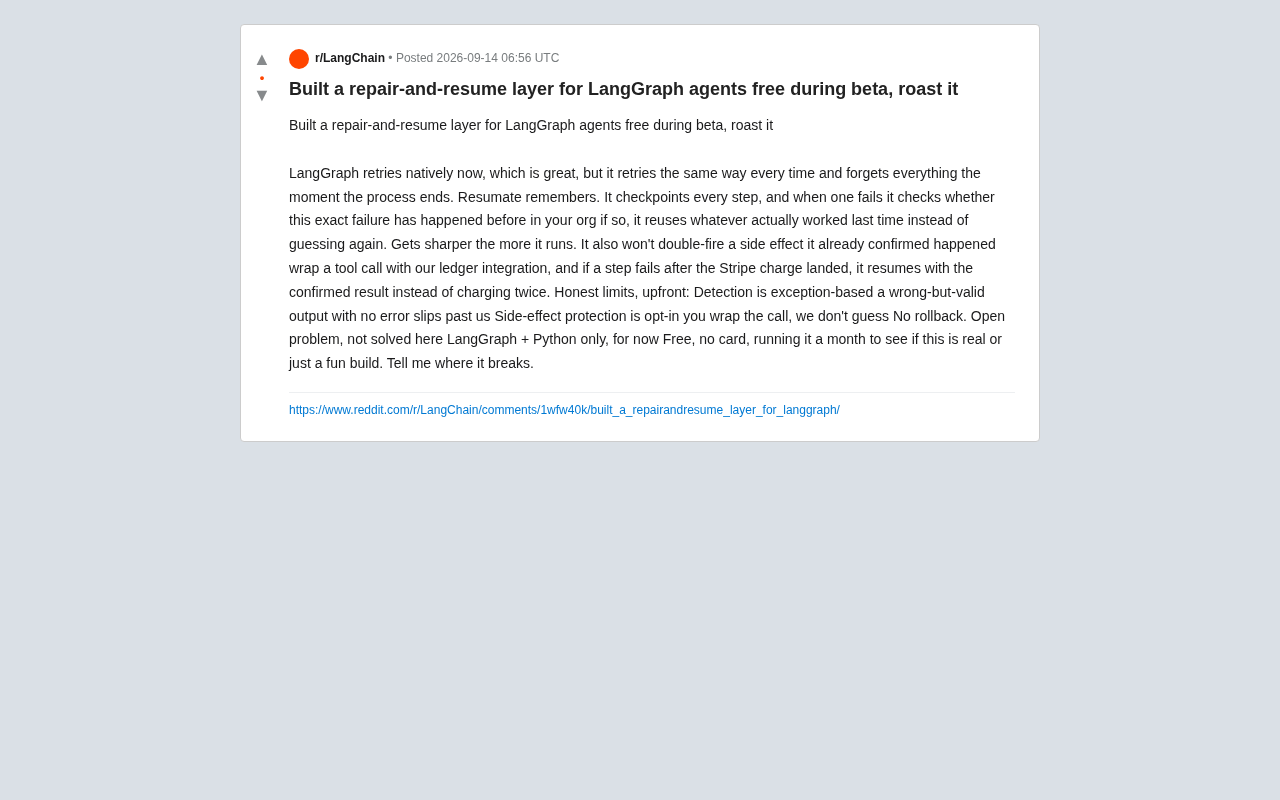
Resumate:为LangGraph智能体打造的修复与续跑层解析
开发者为LangGraph智能体打造修复与续跑层Resumate,通过检查点记忆失败、复用有效方案并防止Stripe扣款等副作用重复触发。本文解析其核心机制、坦诚局限与工程价值。