Claude 4.6之后走下坡路?一位两年老用户的深度吐槽
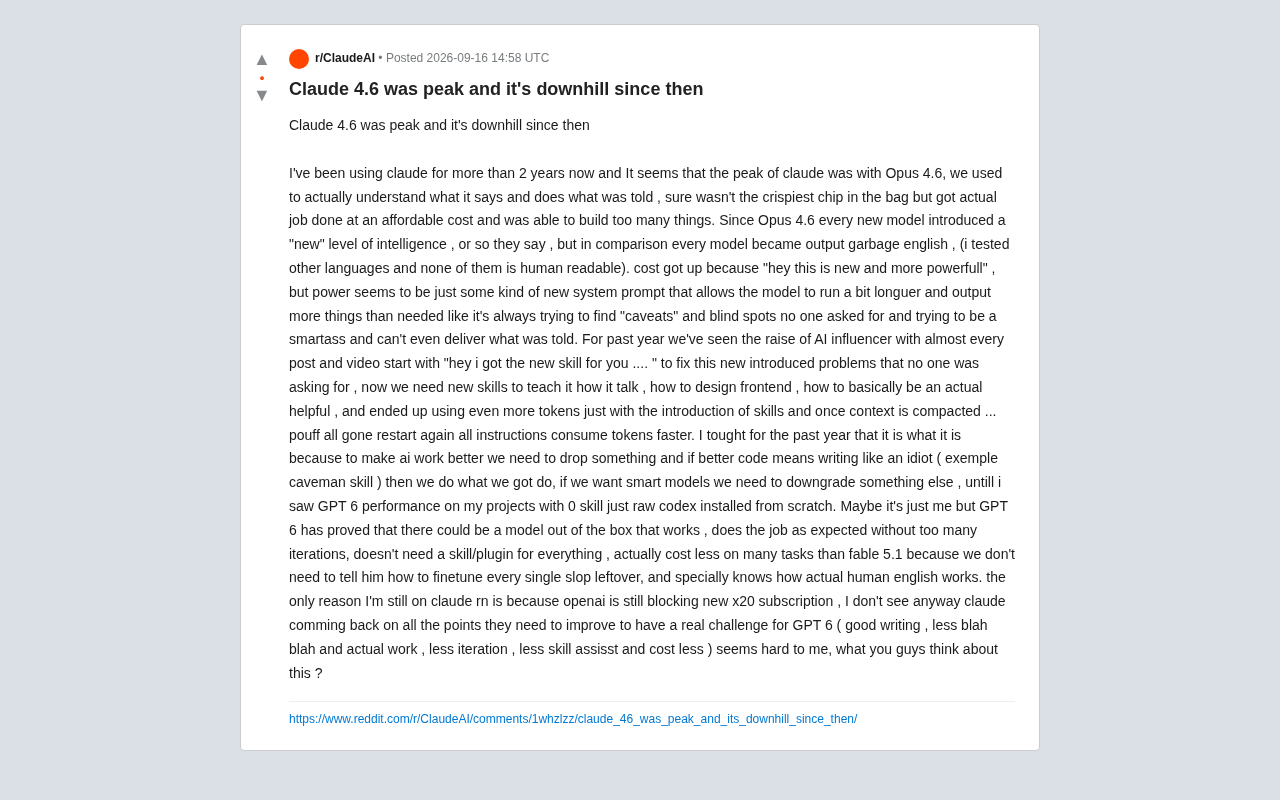
一位两年资深用户认为Claude巅峰已过,以"开箱即用"的竞品为由质疑"更强即更好"的模型迭代逻辑。
一位使用Claude超过两年的Reddit用户发帖称,Claude的最佳体验停留在早期版本,此后每次迭代反而带来输出质量下降、语言啰嗦、成本上升、以及需要大量"技能"才能驯服模型等问题。他以另一款AI产品"开箱即用、无需调教"的表现作为对比,指出当前Claude需要用户通过繁琐的提示词工程和自定义技能来弥补默认行为的缺陷,这些技能本身又加速了上下文消耗,形成成本恶性循环。帖子引发了一场关于"模型进步应如何定义"的讨论:更长的推理链、更高的基准分数,是否真的等于对用户更有价值的产品?文章在如实转述用户观点的同时,也提示这属于主观个体体验,不能代替系统性评估。
一位资深用户的失望:Claude的巅峰已过?
近期一位在Reddit上活跃的老用户发帖表示,自己使用Claude已超过两年,但认为Claude的巅峰停留在了Opus 4.6版本,此后的每一次迭代反而让体验持续走低。这篇帖子引发了不少关于AI模型"进化方向"的讨论——更强的模型,是否真的等于更好用的模型?
这位用户的核心观点很直接:Opus 4.6时期的Claude,虽然"不是最锋利的那把刀",但能真正理解指令、按要求完成任务,成本可控,能帮他构建大量项目。而在此之后,每个新版本都号称带来"新的智能水平",实际使用体验却在他看来不升反降。
需要说明的是,帖子中出现的"Opus 4.6""GPT 6""fable 5.1"等版本命名,部分可能为用户的口误、代称或调侃,本文如实转述其观点,不对具体版本号做事实背书。
用户眼中的三大退步
输出质量下降,语言变得"不像人话"
发帖者抱怨新版本的英文输出越来越"垃圾",他还测试了其他语言,认为可读性同样糟糕。在他看来,模型似乎总在寻找"没人问过的注意事项和盲点",试图显得聪明(being a smartass),却连最基本的"按要求交付"都做不到。
这种"过度思考"的现象,其实是不少用户对新一代推理型模型的共同感受。模型倾向于输出更长、更"全面"的内容,附带大量免责声明和边界讨论,但对于只想快速完成具体任务的用户来说,这些冗余反而成了负担。
成本上升,"更强"却更贵
用户指出,新版本以"更强大"为由抬高了价格,但他认为所谓的"更强",本质上可能只是换了套系统提示词(system prompt),让模型运行更久、输出更多不必要的内容。换句话说,用户为"啰嗦"付了更多的钱。
这触及了一个真实的行业张力:当模型以"思考链更长"作为能力提升的标志时,token消耗量随之上升,用户的实际账单也在增加。能力与成本的权衡,正成为专业用户越来越关注的评估维度。
思考链(Chain-of-Thought)与token消耗的关系
推理型模型(如Claude 3系列的扩展思考模式)在生成最终回答之前,会先产出一段内部"思考过程",这段过程同样以token计费。对于简单任务,这意味着用户为模型"自言自语"付出了额外成本,而这些中间步骤往往对最终答案贡献有限。以Anthropic的定价结构为例,输出token的单价通常是输入token的3-5倍,思考链越长,账单增幅就越显著。这种设计初衷是提升复杂推理任务的准确率,但对于日常代码生成、文本编辑等结构化任务,过长的思考链带来的收益往往难以覆盖成本增量,专业用户因此需要在模型版本或参数配置上做出取舍。
"技能"泛滥:修补本不该存在的问题
帖子里有一段颇具画面感的吐槽:过去一年,AI博主的视频几乎都以"嘿,我给你带来了新技能……"开头,用来修复那些新版本引入、却没人要求的问题。用户需要额外的skill去教模型"如何说话""如何设计前端""如何变得真正有用"。
更糟的是,这些技能本身也在消耗token,而一旦上下文被压缩(context compacted),所有指令又"啪"地消失,需要重新加载,token消耗更快。用户原本以为这是"要让AI变好就得牺牲点什么"的必然代价——比如为了更好的代码,就得用"穴居人式"(caveman skill)的简陋表达。
上下文压缩(Context Compaction)的机制与影响
当对话长度接近模型的上下文窗口上限时,部分AI工具(如Anthropic的Claude.ai及第三方客户端)会自动触发"上下文压缩"机制:将早期对话内容总结为更短的摘要,以腾出空间容纳新的输入。这一操作会导致之前注入的系统提示词(system prompt)和自定义"技能"指令被稀释甚至丢失,模型行为因此出现漂移,原本已调教好的输出风格或任务规则需要重新加载。对于依赖大量自定义技能的工作流,这意味着每次压缩后都要重新消耗token来"唤醒"模型记忆,形成一个持续累积成本的循环,也是发帖者抱怨的"技能消耗-压缩-重加载"恶性循环的技术根源。
GPT 6的对比:开箱即用的冲击
真正动摇这位用户信念的,是他所称的"GPT 6"在自己项目上的表现。他描述:零技能配置,从头安装原生codex,模型就能按预期完成工作,不需要反复迭代,不需要为每件事配一个skill/plugin,很多任务的成本甚至更低——因为"不用手把手教它微调每一处残留的垃圾",而且它"真的懂人类英语该怎么写"。
这个对比揭示了一个耐人寻味的产品哲学差异:一边是需要大量外部"技能"和精细调教才能发挥的模型,一边是"开箱即用"、默认行为就贴合用户预期的模型。对于追求效率的开发者而言,后者的吸引力显而易见。
值得留意的是,这毕竟是单一用户基于个人项目的主观体验,样本有限,不同任务、不同工作流下的结论可能大相径庭。但它反映出的诉求具有代表性:用户要的是更少的废话、更少的迭代、更少的技能辅助、更低的成本,以及真正可用的输出。
"开箱即用"与"可调教性"的产品哲学分歧
大型语言模型在部署时面临一个根本性的产品取舍:是将默认行为调校得尽量贴合大多数用户的直觉预期(高"开箱即用性"),还是保留更大的可塑空间供专业用户通过提示词工程深度定制(高"可调教性")?前者的代表做法是在RLHF(基于人类反馈的强化学习)阶段引入大量"日常用户"的偏好数据,使模型默认更简洁、直接;后者则倾向于在默认状态下保留更多"能力储备",由用户通过指令激活特定行为。两种策略并无绝对优劣,但当模型的主要用户群从研究者转向效率导向的开发者时,"开箱即用"的权重往往会显著上升。帖子中的对比折射出的正是这一分歧:Claude被部分用户感知为偏向后者,而竞品则被认为在前者上投入更多。
为什么还留在Claude?
这位用户坦言,目前仍在用Claude的唯一原因,是OpenAI还在限制新的x20订阅(高级订阅档位)。他并不看好Claude能在他列出的几个关键维度上追回来——好的写作、少废话多干活、更少迭代、更少技能依赖、更低成本。在他看来,要在这些点上全面反超,"对Claude来说很难"。
一场关于"智能"定义的争论
剥开个人吐槽的外壳,这篇帖子实际上抛出了一个值得整个行业深思的问题:什么才是模型的"进步"?
如果"更智能"意味着更长的推理、更多的边界讨论、更高的token消耗,却需要用户用一堆技能和提示词工程去"驯服"它,那这种进步对普通用户的实际价值有多大?相反,一个默认行为就克制、精准、贴合意图的模型,或许才是多数人真正想要的。
当然,我们也要对这类观点保持审慎。单一用户的体验带有强烈主观性和特定使用场景的局限,模型的实际能力评估需要更系统的基准测试和更大规模的样本。但这类来自一线深度用户的反馈,恰恰是产品团队最该倾听的声音——它提醒着开发者:能力的堆叠,不该以牺牲易用性和交付质量为代价。
相关推荐
百行代码从0手写一个Agent:拆解OpenClaw神话的极简实现
用不到200行代码从0手写一个Agent,拆解OpenClaw、Hermes等智能体的本质。涵盖大模型调用、while循环、history记忆、系统提示词、工具调用与Skill渐进式披露六大核心步骤,附AI应用开发学习路线参考。
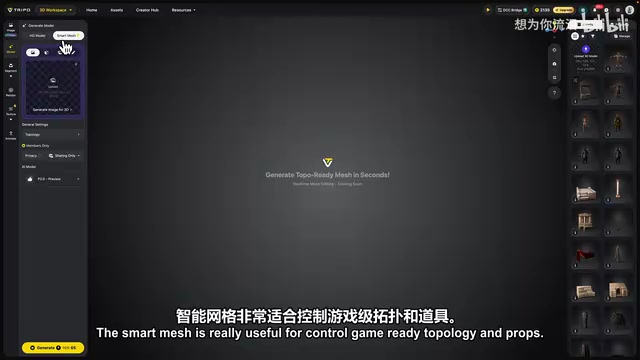
4个顶级AI从零打造角斗士游戏:多智能体协作的实战拆解
一位创作者用Fable 5、Opus 5、GPT、GROK四个AI模型协同,从零打造角斗士游戏。本文拆解多智能体协作、独立评审循环、Trippo 3D生成等工作流,以及AI骗过评审的真实失败案例。
AI Agent零基础入门:从大模型认知到智能体开发全景图
AI Agent零基础入门教程:从人工智能、机器学习、深度学习到Transformer与大模型的技术脉络,再到提示词、RAG、MCP、LangChain等Agent开发四阶段学习路线,帮助你系统掌握智能体开发核心技能。