Claude Code Advisor模式解析:Fable 5.2与Sonnet 5.5协作写代码
Claude Code 的 Advisor 模式让主模型在关键节点调用更强顾问模型,按需付费但需注意版本与计费门槛。
Anthropic 为 Claude Code 终端加入了实验性工具 Advisor,采用模型分层思路:日常编码由主模型(如 Sonnet 5.5)完成,在架构规划、死循环排障和终检等关键节点调用能力更高的顾问模型(Fable 或 Opus 5 档)。顾问模型能力不得低于主模型,弱顾问会被自动禁用。功能仅限 Anthropic API 与 AWS Claude Platform,且有最低版本要求。启用方式包括 `/advisor` 交互选择、直接指定和 `--advisor` 单次参数。计费上 Fable 有独立规则,首次启用需授权确认;官方仅确认按需调用可降低成本,X 帖子所称"降本 3.4 倍"及四模型串联流水线均无官方依据。
Claude Code Advisor模式解析:Fable 5.2与Sonnet 5.5协作写代码
Anthropic 在 Claude Code 终端里加入了一个实验性工具 Advisor(顾问)。它的思路并不复杂:与其让每一个编码步骤都跑在最贵的模型上,不如在关键决策点请一个更强的"顾问"介入。土耳其创作者 Hikmet Tanrıverdi 的 AI 分身在一期视频里,依据 Anthropic 官方文档把这个工具从安装到计费完整拆解了一遍,也顺手核实了社交平台上流传的一些说法。
需要说明的是,这条视频是单一来源的技术解读,其中大部分事实性描述可以追溯到官方文档,但涉及社区流传的"降本倍数"时,作者明确提醒那不是官方数字。
Advisor 的定位:关键节点上的强模型介入
Advisor 的核心逻辑是模型分层。日常编码交给主模型(例如视频中反复提到的 Sonnet 5.5),当遇到架构规划、反复报错的死循环、或者任务收尾前的终检时,主模型会主动把问题抛给一个能力更高的顾问模型。
官方文档中,顾问模型的能力等级不能低于主模型。如果主模型是 Sonnet 5.5,顾问只能从 Fable 或 Opus 5 这一档里选;像 Haiku 4.5 这类更小的模型无法担任顾问。若用户强行选了比主模型弱的顾问,Claude Code 不会直接关闭会话,而是默默把顾问禁用——这个设计细节说明 Anthropic 宁愿降级也不愿让弱模型给出误导性建议。
顾问模型本身不写代码、不接管键盘。它只在被调用时输出策略判断或复核意见,实际执行仍由主模型完成。
访问条件与版本门槛
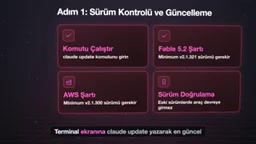
这个功能目前通过 Anthropic API 和 AWS 上的 Claude Platform 开放。Amazon Bedrock、Google Cloud Agent Platform、Microsoft Foundry 这些基础设施上暂不支持。视频里还提到,土耳其用户可以用 Anthropic API 账号或 Claude 订阅,在终端里以土耳其语与模型交互。
版本要求是另一道坎。使用 Fable 5.2 作为顾问,Claude Code 至少需要 2.1.321 版本;跑在 AWS Claude Platform 上的用户至少要 2.1.300。版本过低时系统不认识顾问模型,工具根本不会生效,会话会以普通模式启动。升级方式很简单,在终端执行 /update 即可。
Claude Platform on AWS 与 Bedrock 的区别
文中提到的 "AWS 上的 Claude Platform" 与 Amazon Bedrock 是两套不同的接入路径。Bedrock 是 AWS 面向多家模型厂商的统一托管服务,Claude 只是其中一类模型;而 Claude Platform on AWS 是 Anthropic 与 AWS 合作、专门承载 Claude 的独立平台,接口和功能节奏更贴近 Anthropic 自家 API。这解释了为什么 Advisor 在 Claude Platform on AWS 上可用,却在 Bedrock、Google Cloud Agent Platform、Microsoft Foundry 这类第三方多云托管服务上暂不支持——后者通常要等各平台自行完成适配和功能对齐,新实验特性的上线往往滞后。
/update 与版本语义
Claude Code 的 /update 是终端内的自更新命令,会拉取官方发布的最新版本并替换本地可执行文件,无需手动重装。文中出现的 2.1.321、2.1.300 属于语义化版本号,前两段表示主次版本、末段为修订号;Advisor 这类实验工具常以较小修订号逐步放开,因此不同部署环境(直连 API 与 AWS 平台)对应的最低版本会不一致。
三种启用方式与调用细节
在终端会话中启用顾问有三条路径:
- 交互式选择:输入
/advisor,会列出可选的顾问模型; - 直接指定:输入
/advisor opus或/advisor fable,选择会写入用户设置并长期保留; - 单次试水:启动时加
--advisor opus参数,只对当前会话生效,关闭后恢复默认。
想手工配置的话,也可以在用户目录的 settings.json 里写入顾问模型字段。
顾问被调用时,终端会出现带模型名的 "advising" 状态行;调用结束后显示 "reviewed",按 Ctrl+O 可以阅读顾问给出的建议。若顾问拒绝给出方向,会显示 "declined";调用出错则是 "unavailable"。
值得留意的是,主模型并非无条件采纳顾问意见。如果项目里的现有证据与顾问建议冲突,主模型会把分歧呈现给用户,而不是盲目执行。
一次调用只能配一个顾问
X 上有一条流传较广的帖子,把 Fable 5.2 描述为"思考者"、Sonnet 5.5 为"编码者"、Opus 为"审查者"、Haiku 为"子代理",看起来像一条四模型流水线。视频作者核对官方文档后指出:Claude Code 在一个会话里只允许一个主模型配一个顾问,这条帖子描述的四模型串联不是官方提供的单命令模式,而是用户自己搭建的工作流。子代理可以在各自任务中独立使用模型,但顾问工具每个会话只监听一个模型。
计费规则:Fable 的特殊待遇
Advisor 本身不是免费插件,调用产生的 token 按被调模型的费率从账户扣费。Fable 系列由于推理能力最高,有一项单独的计费规则:即便用户有订阅套餐,Fable 的用量也可能直接从使用额度里扣除。所以第一次启用 Fable 顾问前,终端会要求一次性确认额度授权;不确认的话,系统会引导到 /model fable 命令,顾问不会激活。
关于成本,X 帖子声称该功能让成本降低 3.4 倍。视频作者明确表示这个数字不在官方文档里。官方只确认了一个定性结论:只在决策时刻调用强模型,而不是全程使用昂贵模型,确实能降低成本。但顾问每次被调用都要重新通读整个会话上下文,其自身的读取不会进入缓存,虽然主模型的缓存不会被破坏,返回的建议也会在后续步骤中本地缓存。
Prompt Caching 与"重读上下文"的成本来源
Anthropic API 的 prompt caching 允许把会话中重复出现的前缀内容缓存起来,后续请求命中缓存时按更低价格计费、并降低延迟。Advisor 的成本痛点正在于此:顾问被调用时会把当前完整会话作为输入重新读取,而这部分读取被设计为不进入缓存,因此每次召唤都按全价计算输入 token。主模型一侧的缓存不受影响,顾问返回的建议也会在后续步骤中于本地缓存,避免重复传输。理解这一点就能明白,为什么"只在关键节点调用"能省钱,而"频繁召唤"反而会显著推高账单——成本几乎完全由顾问的输入 token 规模与调用次数决定。
如何关闭
不再需要顾问时,会话内执行 /advisor off 即可关闭。要从系统层面彻底移除,可以设置环境变量 CLAUDE_CODE_DISABLE_ADVISOR_TOOL=1,此时 /advisor 命令在终端里就不可用了。
实践判断
Advisor 模式的价值在于把"贵"和"快"拆开:主模型保持高频低成本输出,强模型只在架构决策、死循环排障、终检这几个真正需要深度推理的节点上介入。它更像一个随时可召回的资深同事,而不是接管整条流水线。对于经常被同一错误卡住、或在动手前需要架构把关的项目,这个开关值得一试;代价是每次召唤都要重读上下文,滥用反而推高成本。
视频中的完整命令清单和官方来源链接放在该视频的说明栏中,感兴趣可以自行核对。
相关推荐

Punchcutter:一句话或手写体,生成真实字体家族
Punchcutter 是一款免费开源的 AI 字体生成工具,兼容 Claude、ChatGPT、Codex 和 Cursor。输入一句话或手写照片,即可生成 TTF、OTF、可变字体和 Web 字体家族,自带 Studio 应用。
OffiAI:把AI编程会话搬进3D办公室的Mac应用
OffiAI 是一款免费 Mac 应用,将 Claude Code、Codex、Cowork 和 Gemini 会话放入 3D 办公室工位,支持多代理任务管理,无需账号且本地处理数据。

Puffin:为AI智能体提供身份与收件箱,接管你的数字沟通
Puffin为AI智能体提供独立邮箱、Discord/Slack/Telegram席位和日历,支持审批与全自动驾驶双模式,让智能体以数字身份融入团队协作。