Claude Code 每轮烧掉15% token,只为显示三个字
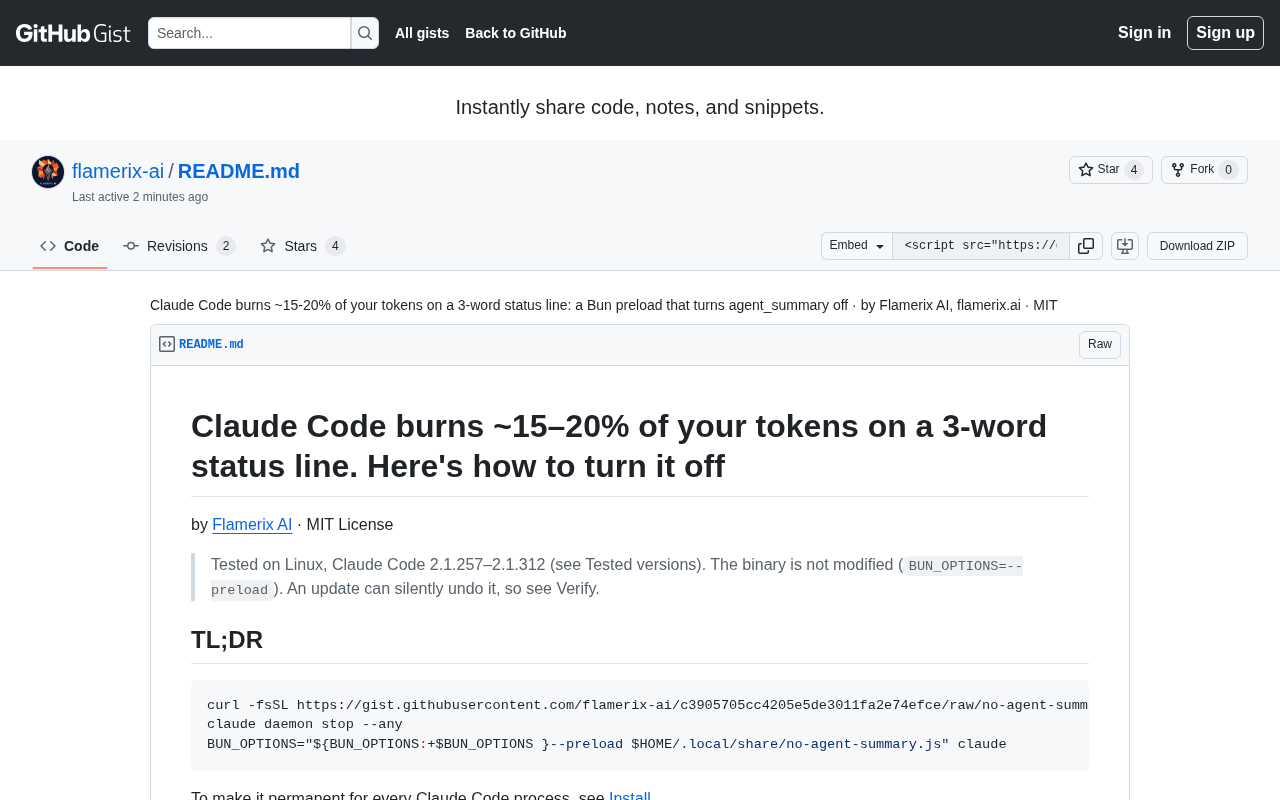
Claude Code 约 15–20% 的 token 花在每轮重复注入的三词状态行上。
文章从 Hacker News 一则低热度帖子出发,拆解了一个容易被忽视的成本黑洞:Claude Code 会把约 15–20% 的 token 消耗在一条仅三个词的状态行上。核心解释在于,状态行并非纯 UI 元素,而是作为提示词的一部分被注入每一轮请求,并计入输入 token,属于“小常量 × 高频次”的重复性开销。这种固定注入既推高按 token 计费的账单,也挤占有限的上下文窗口,降低长会话中的有效信息密度。文章进一步指出,类似问题可能普遍存在于系统提示、工具定义等常驻内容中,建议开发者审计上下文构成,并把 token 效率纳入工具选型指标。
一个三字状态行,如何吃掉你的 token 预算
在 Hacker News 上出现了一条引发讨论的帖子,标题直指一个容易被忽视的成本黑洞:Claude Code 会把大约 15–20% 的 token 消耗在一条只有三个单词的状态行上。帖子本身点数不高(34 点、零评论),但问题本身足够具体,值得拆开来看。
对于按 token 计费的 AI 编程工具来说,这类“隐形开销”直接对应真金白银。开发者往往只关注对话内容本身,却忽略了工具在每一轮交互中默认携带的上下文。
状态行不是“显示”,而是“注入”
token 花在哪里
很多人把状态行理解为界面上的装饰元素,似乎只是渲染几个字。但在 Claude Code 这类基于对话上下文的工具里,状态信息通常作为提示词的一部分被注入到每一轮请求中。也就是说,它不是一个静态的 UI 控件,而是一段反复出现在上下文里的文本。
一旦它进入上下文,就会被计入输入 token。随着对话轮次累积,这段固定内容的成本会被不断重复支付。原始帖子给出的 15–20% 比例,描述的正是这种重复性开销在整体 token 消耗中的占比。
理解这一开销的关键在于区分大语言模型 API 的计费结构。主流 API(如 Anthropic、OpenAI)按输入 token 与输出 token 分别计价,其中输入 token 包含系统提示、历史对话以及每一轮新附加的上下文。由于模型本身无状态,每次请求都必须把完整上下文重新发送一遍,这意味着任何在会话中始终存在的内容都会被逐轮重复计费。Claude Code 这类命令行智能体还会在上下文中保留工具调用记录与文件读取结果,进一步放大了常驻内容的基数,使固定注入部分的占比随会话长度动态变化。
为什么三个字也有代价
单个状态行本身并不长,问题在于“每一轮都算”。在多轮编程任务中,模型需要持续读取上下文来保持一致性,固定注入的内容因此被反复计费。这与“一次性的系统提示”不同,后者通常只在会话开始时出现。
从工程角度看,这属于典型的“小常量 × 高频次”成本结构。单次看微不足道,乘上交互次数后就会变成可观的比例。
对开发者的实际影响
成本与上下文的双重挤压
token 消耗不只关乎账单。上下文窗口是有限资源,被固定内容占用的部分,就无法留给代码、日志和用户指令。在长会话中,这种挤占会降低有效信息的密度,让模型更早触及窗口上限。
对于依赖 Claude Code 进行多轮重构、调试的开发者,这意味着更频繁的上下文清理,以及可能更差的任务连续性。
上下文窗口指模型单次请求能够处理的最大 token 数量,是硬性上限而非可弹性扩展的资源。一旦会话中累积的内容逼近该上限,工具通常会触发上下文压缩(compaction)或截断,把较早的对话摘要化或丢弃。常驻的状态行、系统提示与工具定义虽然体积固定,却会被每一轮请求重复计入窗口占用,相当于持续侵蚀可用于代码与日志的剩余空间。因此固定开销既体现为账单上的重复支付,也体现为有效上下文容量的净减少。
值得关注的工具设计问题
这条帖子之所以有讨论价值,在于它指向了一类普遍现象:AI 编程工具在设计提示词结构时,往往优先考虑功能完整性,而把 token 效率放在次要位置。状态行只是其中一个可见的切口,类似的固定注入内容可能还包括环境信息、工具描述、格式约束等。
据 Hacker News 上该帖的表述,15–20% 是一个明确的比例区间,而非模糊的定性判断。这提示开发者应当把 token 审计纳入日常使用习惯,而不只是关注单次对话的长短。
可以怎么做
审计你的上下文构成
开发者可以主动检查会话中哪些内容是固定注入的,哪些是真正必要的。对于 Claude Code 这类工具,关注状态行、系统提示、工具定义等常驻内容的体积,是控制成本的第一步。
把 token 效率当作选型指标
在评估 AI 编程工具时,token 效率应当和代码质量、响应速度一样成为考量项。一个在功能上强大但固定开销过高的工具,长期使用的综合成本可能明显高于表面价格。
这条 HN 帖子的价值不在于给出解决方案,而在于把“看不见的消耗”摆到了台面上。对于每天与 Claude Code 打交道的开发者,这个 15–20% 的数字值得记在心里。
目前多数 AI 编程工具并不会在界面上展示单次请求的 token 构成,开发者只能通过 API 返回的 usage 字段、代理日志或第三方计量工具来间接观察。常见的审计手段包括对比开启与关闭某项功能时的输入 token 差异、统计单轮请求中系统提示与工具定义的固定体积,以及按会话长度绘制 token 消耗曲线。将 token 效率纳入选型时,可以把“完成同一任务的总 token 消耗”作为横向比较的基准指标,而不仅看单次响应速度或功能清单。
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
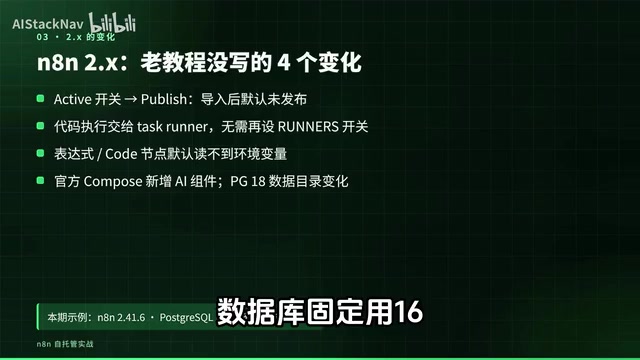
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。