Ollama本地部署指南:零基础跑通开源大模型
Ollama是跨平台开源模型管理工具,让本地部署大模型变得简单经济。
文章介绍了Ollama这一开源模型管理工具,旨在解决在线大模型需联网、按Token计费的问题。Ollama支持macOS、Windows、Linux和Docker等环境,提供命令行和Web UI两种管理方式,可下载、删除和创建模型并在本地运行。其优势包括免费开源降低调用成本、同时利用GPU和CPU降低硬件门槛、提供API接口便于多语言调用和二次开发。使用流程为安装、下载模型、运行交互,并可基于现有模型注入知识库构建领域问答机器人。文章同时提醒,模型越大对内存和算力要求越高,部署前需评估硬件配置。
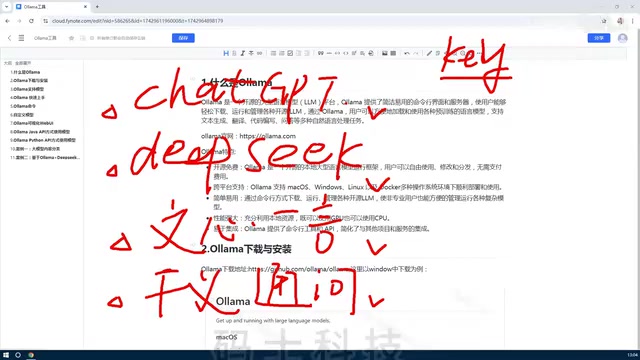
在线大模型如ChatGPT、DeepSeek、文心一言等,使用方便但需要联网,且通过API调用时按Token计费。对于希望个性化开发或不想持续付费的用户,将开源模型部署到本地成为更经济的选择。Ollama正是为此设计的模型管理工具,它让本地运行大模型变得简单。
Ollama是什么?
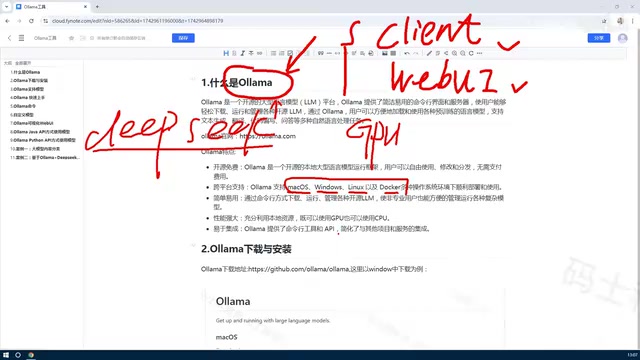
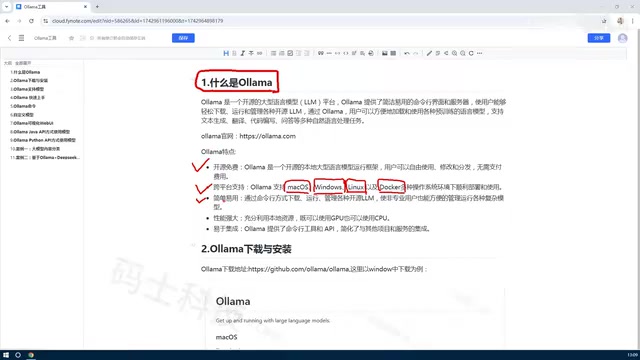
据B站教程介绍,Ollama是一个管理各类大模型的平台工具,支持命令行和Web UI两种使用方式。你可以通过它下载、删除、创建和管理开源模型,将模型部署到本地运行。它支持macOS、Windows、Linux和Docker等多种环境,跨平台能力强。
开源模型与本地部署:开源模型指权重和推理代码公开、允许用户自由下载和修改的大语言模型,如Llama、Qwen、DeepSeek广告等。与通过API远程调用闭源模型不同,本地部署是将模型文件下载到自己的电脑或服务器上运行,数据不出本地,隐私性更好,也无需按Token付费。代价是需要自行准备足够的存储空间(模型文件通常数GB到上百GB)、内存和算力,并承担模型加载和推理时的硬件开销。Ollama的作用就是把这些繁琐的下载、格式转换、运行参数配置封装成简单命令,让本地部署像安装普通软件一样容易。
为什么选择Ollama?
免费开源,降低成本
Ollama本身开源免费。通过它部署的模型在本地运行,不产生API调用费用,适合需要频繁调用模型的开发场景。
Token计费与API调用:在线大模型服务通常按Token计费,Token是模型处理文本的基本单位,一个汉字大约对应1到2个Token,一段较长的对话可能消耗数千Token。API调用是按使用量付费的模式,开发者通过接口把请求发送到服务商的服务器,由对方完成推理并返回结果。这种方式前期成本低、无需硬件投入,但在高频调用、批量处理或长期运行的场景下费用会持续累积。本地部署则把推理成本转化为一次性的硬件投入和电费,调用次数不再产生边际费用,因此更适合调用量大、对数据隐私敏感或需要离线运行的开发场景。
资源利用灵活
Ollama能充分利用机器资源,同时支持GPU和CPU。即使没有独立显卡,也能用CPU运行模型,降低了硬件门槛。
简单易用,扩展性强
Ollama提供命令行和Web UI两种管理方式,简化了模型部署流程。它还提供API接口,方便用Python、Java、Rust等语言调用,扩展性强。
模型API接口:Ollama在本地启动后会监听一个HTTP服务端口(默认11434),提供与OpenAI风格相近的REST API,包括生成补全、对话、嵌入等端点。开发者可以用Python、Java、Rust等语言的HTTP客户端直接请求该地址,也可以借助官方或社区封装的SDK调用。由于接口在本机,请求延迟低且不受网络波动影响。这一设计让Ollama不仅能作为聊天工具使用,还能作为本地推理后端接入LangChain、Dify等应用框架,或嵌入到自己的业务系统中,实现文档问答、代码助手等定制功能。
如何使用Ollama?
- 安装Ollama(从官网下载对应系统版本)。
- 通过命令行或Web UI下载开源模型(如DeepSeek等)。
- 运行模型,通过命令行或API与模型交互。
- 可基于现有模型创建私有模型,注入内部知识库,构建领域问答机器人。
注意事项
模型越大,对机器配置要求越高。部署前需评估硬件资源。Ollama简化了GPU环境配置,但大模型仍需足够内存和算力。
模型规模与硬件配置:大模型的参数量决定其对硬件的要求。7B(70亿参数)模型在量化后通常需要约4到8GB内存,13B模型约需8到16GB,70B级别则往往需要数十GB内存甚至多张显卡。量化技术(如4-bit量化)能显著压缩模型体积、降低内存占用,但可能带来一定的精度损失。没有独立显卡时,CPU可以运行较小模型,但推理速度较慢;有GPU时则依赖显存容量,显存不足会退化为CPU推理或直接加载失败。因此部署前应根据可用内存、显存和预期响应速度选择合适的模型规模与量化版本。
总结
Ollama降低了开源大模型的使用门槛,让个人开发者和小团队也能在本地轻松部署和调用模型。无论是学习测试还是构建私有应用,Ollama都是一个值得尝试的工具。
相关推荐
WorkBuddy AI智能体实战:从大模型到Agent的落地差异
通过批量转PDF实战对比,解析WorkBuddy AI智能体与大模型产品的本质差异,涵盖授权执行、积分消耗、场景适配与落地认知,帮你判断Agent工具是否适合当前工作流。
GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景AI工程师分享GrokBot工作流:一个月合入约千个PR,智能体自动合并20个。核心方法论围绕验证技能、EVAL测试、Dune架构与硬性CI约束,揭示如何从本地信任走向云端代理自动化。
Bright Data评测:免费额度、AI智能体MCP服务器与定价
Bright Data 提供免费 5000 额度、开源 MCP 服务器及代理/抓取 API。了解其定价模式、AI 助手集成方式和合规注意事项。