Claude Code Mods 是什么?深入解析 Anthropic 全新扩展机制

Anthropic推出Mods机制,首次允许开发者深入Claude Code内部改变agent行为,而非只能外挂扩展。
Anthropic为Claude Code推出Mods机制,这是其扩展体系的一次架构级升级。此前的skills、hooks和MCP server均以「外挂」方式运行于Claude Code之外,开发者只能在工具周围添加能力,无法触及核心运行逻辑。Mods则直接驻留在Claude Code内部,常驻于整个会话生命周期,能够控制agent harness的行为。与无状态、一次性的hook脚本相比,Mods可以跨多轮对话保持状态、展示实时信息面板,并在执行高危操作前主动暂停询问。这标志着Claude Code从「可扩展工具」向「可深度定制平台」的质变,开发者第一次有能力重塑agent本身的行为边界。
Anthropic 为 Claude Code 推出了全新的 Mods 机制,这是官方首次真正意义上向开发者「开放」Claude Code 本体。与过去的 skills、hooks、MCP server 不同,Mods 直接运行在 Claude Code 内部,能够深度干预 agent 的行为逻辑。这意味着开发者第一次有能力去改变工具本身,而不只是在它周围做文章。
Mods 与过去扩展方式的本质区别
在 Mods 出现之前,Claude Code 的扩展能力主要依赖三类组件:skills(技能)、hooks(钩子)和 MCP server(模型上下文协议服务)。这些组件有一个共同特征——它们都存在于 Claude Code 之外,由 Claude Code 在需要时主动调用。
换句话说,过去的扩展模式是「外挂式」的:你可以给 Claude Code 添加周边能力,但无法触碰它的核心运行逻辑。而 Mods 彻底改变了这一点,它直接驻留在 Claude Code 内部,能够控制 agent harness(代理执行框架)的行为。
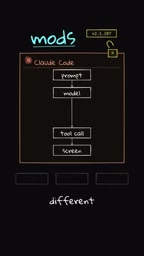
这种架构差异带来的最直接后果是:Mods 可以在 Claude Code 即将执行某个动作之前「介入」,修改这个动作,甚至直接阻止它。这是外挂式组件永远做不到的事情。
MCP(Model Context Protocol,模型上下文协议)是 Anthropic 推出的一套开放标准,旨在让 AI 助手能够与外部数据源、工具和服务进行标准化通信。MCP server 作为独立进程运行,Claude Code 通过协议接口向其发起请求来获取额外能力——例如读取数据库、调用外部 API 或执行特定领域的计算任务。Skills 则类似于预定义的能力包,告诉 Claude Code「它能做什么」;Hooks 是基于事件触发的脚本,在特定操作发生时被调用执行。这三者共同构成了 Mods 出现之前 Claude Code 的扩展体系,其架构逻辑本质上都是「Claude Code 作为调用方,扩展组件作为被调用方」,控制流始终掌握在 Claude Code 手中。
Mods 为什么比 Hooks 更强大
很多开发者第一反应可能是:我们已经有 hooks 了,不是也能干预行为吗?为什么 Mods 还值得单独拿出来讲?
关键差异在于生命周期和状态保持能力。Hook 本质上是一个 shell 脚本:它针对某个事件触发一次,运行后返回结果,然后就结束了——它是无状态、一次性的。
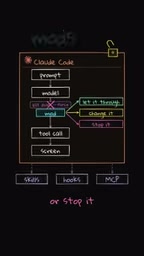
而 Mods 则完全不同。它在会话开始时被加载一次,然后在整个会话期间持续运行。这个看似简单的区别,实际上打开了一整类新的可能性。
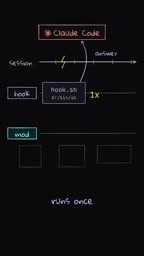
因为 Mods 常驻运行,它能够:
- 记住状态:在多轮交互之间保留上下文和数据,而不是每次从零开始
- 提供实时面板:展示一个随每一轮对话实时更新的信息界面
- 暂停并询问:在执行命令前先停下来,征求你的确认
这些能力的本质,是把 Claude Code 从一个「被动响应事件」的工具,变成了一个可以被持续「驻场改造」的平台。
Agent harness(代理执行框架)是指驱动 AI agent 完成多步骤任务的调度层,负责管理模型调用、工具执行、结果解析和下一步决策之间的循环流转。在 Claude Code 的架构中,harness 决定了「何时调用哪个工具」「如何处理工具返回的结果」以及「何时向用户汇报进展」。过去的扩展组件只能作为被调用的「工具」挂载在 harness 外围,而 Mods 能够直接介入 harness 的执行循环本身——这使得 Mods 可以在 agent 做出行动决策的关键节点上插入自定义逻辑,而非只能在动作完成后被动响应。
「改变工具本身」意味着什么
作者用一句话精炼概括了 Mods 的意义:同样的内核,加上不同的 Mods 组合。
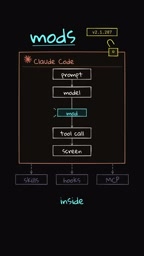
过去你能做的,是「在它周围添加东西」(add things around it);而现在,你可以「改变这个东西本身」(change the thing itself)。这是从扩展到定制的质变。
对于希望深度定制 AI 编程工作流的团队来说,这意味着可以根据自身需求重塑 agent 的行为边界——比如为高危操作强制加入人工审批、为特定项目注入持久的上下文记忆、或者构建专属的实时监控视图。这些此前要么无法实现,要么只能用脆弱的脚本拼凑。
该如何理解这次更新
Mods 的推出,标志着 Anthropic 对 Claude Code 开放策略的一次重要转向。从「允许你围绕工具搭建生态」到「允许你介入工具内部」,这是一个控制粒度上的根本提升。
当然,更强的控制权也意味着更高的责任——能够拦截和修改 agent 行为的组件,天然带有更大的影响面。对开发者而言,Mods 既是机会,也要求更谨慎的设计。随着这一机制逐步被社区采用,围绕 Claude Code 的定制化生态很可能会迎来新的爆发点。
相关推荐

AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。

@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。

ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。