Claude Code 入门实战:用好 CLAUDE.md 与 Plan Mode
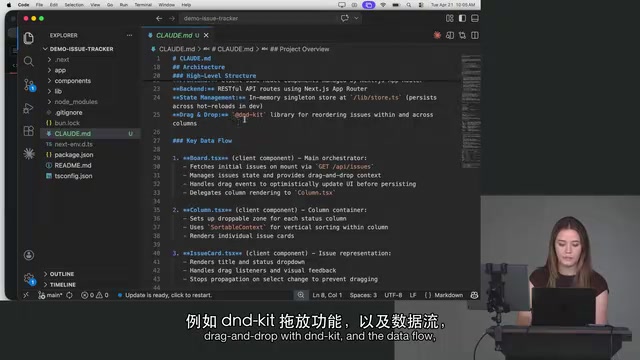
Claude Code工作坊演示CLAUDE.md与Plan Mode如何将AI从随机生成器变为可靠协作者
本文整理自一场Claude Code官方工作坊,聚焦两个核心协作机制。CLAUDE.md是一份注入到每次请求上下文的项目说明文件,通过`init`命令自动生成,用于固化技术栈、架构约定等重复性信息,减少模型无谓的探索调用;但其内容会占用上下文窗口,应精简维护,随着模型意图理解能力增强,其必要性也在相对下降。Plan Mode则是在提示层强制插入"先规划、不写代码"的步骤,让开发者在执行前就能发现方向偏差;演示中强调工作流里必须存在可验证对象(如设计截图或测试用例),以将模糊意图转化为模型可对照的具体目标。两者共同推动开发者角色从"代码编写者"转向"意图定义者与结果审稿人"。
Claude Code 作为 Anthropic 推出的命令行编程助手,正在改变开发者与 AI 协作的方式。在一场官方工作坊中,讲师围绕两个核心能力展开实操演示:用来固化项目上下文的 CLAUDE.md 文件,以及动手写代码前先规划的 Plan Mode(计划模式)。这两个功能看似简单,却是让 Claude 从「随机生成代码」变成「可靠协作者」的关键。
CLAUDE.md:把重复的话写进文件里
CLAUDE.md 是加入到用户提示(user prompt)里的第一样东西。在已有项目里生成它非常简单——直接运行 init 命令即可。Claude Code 会在后台探索整个代码库,理解你的约定与结构,然后据此自动生成一份 CLAUDE.md。
讲师给出的判断标准很直白:如果你发现自己在提示里要重复说某件事多次,就把它写进 CLAUDE.md。生成后的文件会包含项目总览、所用技术栈、常用命令、架构说明等信息。比如演示项目里使用了 DND(拖拽库),这些信息对模型极为有用——如果模型不知道这些,它可能会发出更多工具调用去反复确认「仪表盘在哪里」「哪些组件依赖它」。CLAUDE.md 的价值正在于减少这类无谓的试探,一次性给足上下文。
关于 init 用什么模型,有观众提问是否该用 Opus。讲师的回答是:init 阶段生成的内容本就存在于代码库中,模型不需要对更深层任务做批判性思考,答案就摆在那里,用 Sonnet 完全够用。
文件不是越大越好
一个容易被忽视的点是:整份 CLAUDE.md 会被拼进组装后的提示里,也就是说它会占用你的上下文窗口。如果文件很大,而大部分内容模型根本用不上甚至是无用信息,那么它只会让你的用量消耗得更快。
讲师分享了自己的工作流:有时会尽量删减 CLAUDE.md,然后观察模型在哪里开始「翻车」,再把必要内容补回去。他还指出一个趋势——CLAUDE.md 的重要性其实与模型能力相关。随着模型越来越擅长理解意图,它的必要性在逐渐下降。在早期的 Opus 4.5 等模型上它尤为关键,而新一代模型对意图的理解更强,依赖程度相对降低。
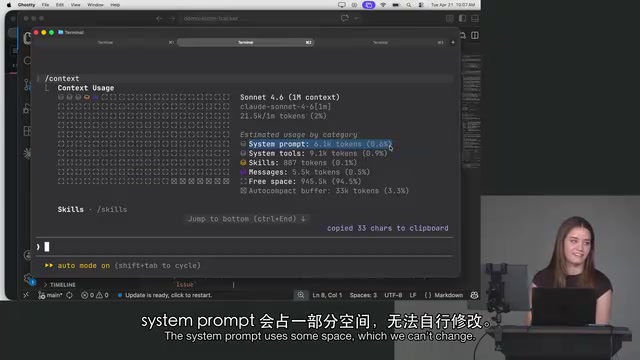
想随时查看上下文占用,可以用 context 命令。演示中显示,当前只用了约 2.1 万 / 100 万 token,系统提示占了一部分(这部分无法更改,只能接受),消息往来仅占 0.5%。后续的插件和技能(skills)也会填充上下文,因此养成「我是不是往上下文里加了多余东西」的意识很有必要。
从技术机制角度看,CLAUDE.md 本质上是一种系统级上下文注入。Claude Code 在组装每次请求的提示时,会把 CLAUDE.md 的内容拼接到用户消息之前,相当于在每次对话开始前都默默"交代一遍背景"。这与直接在对话里重复说明的效果相近,但把维护成本从分散在每条消息中转移到了一个集中管理的文件里。对于有多个开发者协作的项目,把 CLAUDE.md 提交进版本库还意味着团队成员使用 Claude Code 时能获得一致的上下文起点,避免因人而异的提示习惯导致模型行为差异。
Mono Repo 下的 CLAUDE.md 层级
针对单仓多项目(mono repo)的场景,有观众问该如何组织 CLAUDE.md。讲师解释说这里存在层级机制:你可以在用户主目录放一个根级 CLAUDE.md,它几乎对所有项目生效;然后一路向下,到具体仓库、子仓库都可以各自放一份。
具体用哪一份,取决于你在哪个目录启动 Claude——它会从当前目录逐级向上查找。实践建议是:共享的项目设置放进项目级的 CLAUDE.md,想保持本地私有的内容则放进根目录(如 ~/.claude 下的用户级文件)。
Plan Mode:先规划,再写代码
讲师把 Claude 比作任何一位同事:动手实现之前,你总会先问同事「你觉得这事该怎么做?」在这种模式下,开发者的角色更像是产品经理(PM)。
开启 Plan Mode 有几种方式——在 CLI 里按 Shift+Tab,在桌面应用里用下拉选择,或者干脆直接告诉 Claude。因为 Plan Mode 本质上只是往提示里加了一句话:「现在是计划模式,先别写任何代码」。所以哪怕只是在普通对话里这样提示它,效果也一样。
验证环节必须在循环里
演示中的关键理念是:Claude Code 的工作流里必须有「可验证」的东西。讲师准备了一个故意做得很丑的 to-do list demo,然后想把它变漂亮。问题在于——怎么让 Claude 明白你说的「漂亮」和「设计」到底指什么?
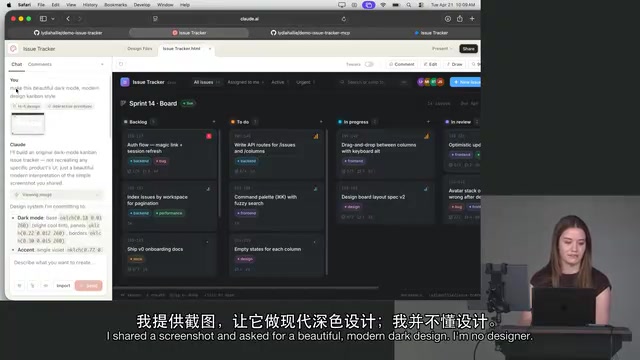
他的做法是借助 Claude 的设计能力:先截图,用一句很随意的提示「把它做成好看的深色模式现代设计」,让 Claude 生成一套新设计稿。有了这张设计图,就有了可供模型对照验证的目标——这个验证对象可以是图片,也可以是测试用例。
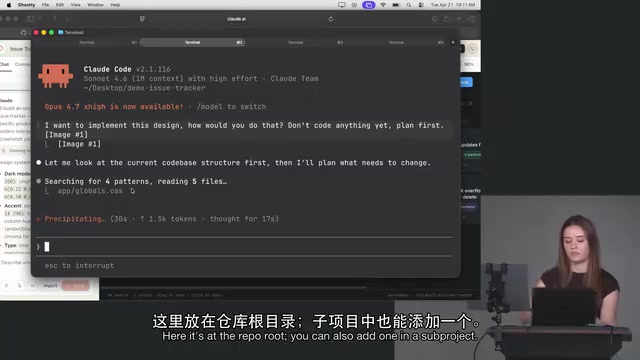
接着他新开一个会话,把设计截图拖进 CLI,提示「我想实现这个设计,先别写代码,先做计划」。即便 CLI 里不会渲染图片,Claude 依然能读取并理解图像内容。
「可验证对象」这一概念在 AI 辅助开发中尤为重要,因为自然语言描述本身具有高度歧义性。「漂亮」「现代感」「简洁」等形容词在不同人脑中映射的视觉结果可能截然不同。将模糊意图转化为具体的参照物——无论是设计截图、测试用例、数据样本还是已有页面——能够为模型提供一个明确的「收敛目标」。在软件工程实践中,这与测试驱动开发(TDD)的思路有异曲同工之处:先定义「什么算通过」,再让实现去满足这个标准。对 Claude Code 而言,这个标准可以是图像、可运行的断言,也可以是用户验收标准(Acceptance Criteria)的文字描述——关键是要让模型和开发者对「完成」的定义达成共识。
开发者变成审稿人
生成实现计划后,软件工程师的角色就从「写代码」切换成「审稿人兼 PM」——核心任务变成判断「这份计划是否符合我的预期」。
演示中 Claude 注意到了一些讲师自己都没想到的细节:新字段需要 issue 编号、标签、优先级,还要在 store 里加东西才能让设计跑起来,需要新的 API 路由和组件。如果计划有偏差,你完全可以继续和它来回沟通修正——「这跟你设想的一致吗?」「其实不太一致」——把它当同事对待就好。
讲师也坦言,这类演示的「不确定性」正是它真实的地方:以往的工作坊都很确定,对就是对、错就是错;而每个人的 Claude Code 都可能给出不同结果,所以最好的学习方式就是亲自上手试。
Plan Mode 背后体现的是 AI 辅助开发中的一个核心矛盾:大语言模型天然倾向于「立即生成」,一旦接收到任务描述,就会直接输出代码,而非先确认方向。这种倾向在任务简单时无害,但面对需要跨越多个文件、模块或 API 的复杂变更时,往往导致大量返工。Plan Mode 通过在提示层面强制插入一个"暂停-规划"步骤,利用模型的推理能力先产出结构化的实施路径,让开发者在投入执行成本之前就能发现潜在的方向偏差。这类似于软件工程中的「设计评审」环节被嵌入到了单次 AI 对话的节奏里。
小结
CLAUDE.md 和 Plan Mode 代表了与 AI 编程助手协作的两种基本功:前者解决「上下文一致性」,让模型少走弯路;后者解决「方向正确性」,让你在写代码前就把分歧暴露出来。两者共同指向同一个转变——开发者正从「代码的编写者」走向「意图的定义者与结果的审稿人」。随着模型能力提升,这些工具的使用方式也会继续演化,但「给够上下文、先规划后执行、保留验证环节」的原则大概率会长期成立。
相关推荐
用生活场景看懂竞态条件:从咖啡机到银行取款的并发难题
通过咖啡机、买牛奶、银行取款、三向环岛等生活化例子,深入浅出讲解竞态条件、死锁、活锁、幂等性与锁机制等并发编程核心概念,帮你建立对并发问题的直觉理解。
亚马逊Alexa平板上手:NanoMAT屏幕叫板iPad Pro?
亚马逊推出全新Alexa平板系列,起售价499美元,升级铝合金机身并运行完整Android。重点体验NanoMAT抗眩光屏幕,对比iPad Pro的Nano Texture屏幕,解析其是否构成威胁。
5个比问ChatGPT更好用的CSS生成器工具
介绍5个比问ChatGPT更高效的CSS生成器工具:Mesher网格渐变、Fuel的SVG纹理、Temani Afif的CSSGenerators、Easing Wizard缓动曲线和Dice Bear头像生成,快速搞定难写的CSS效果。