Claude Code + Skills 一键生成Web测试用例实战解析
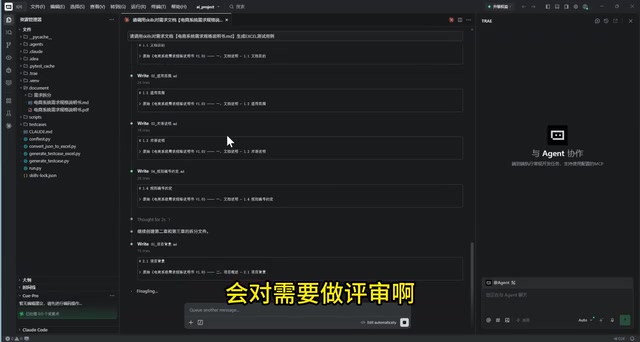
用Claude Code三阶段Skills流水线,十分钟将需求文档自动转化为可落地的Web测试用例。
本文介绍了一套基于 Claude Code Skills 机制的测试用例自动化生成方案。整个流程分三个阶段:首先按章节原样拆分需求文档,并将表格、图片统一转为纯文字;其次智能过滤概述性章节,结构化提取带测试设计方法标注的测试点;最后生成包含步骤、预期结果、优先级和人工评审列的完整用例。整个流程约十分钟完成,生成的用例保留测试点溯源链路,可直接纳入现有测试流程。文章同时指出"效率提升10倍"属宣传口径,实际价值在于将模糊任务拆解为可控环节、解决多模态需求的结构化难题,以及将测试方法论固化进 AI 流程,而非追求"一步到位"的自动化。
在软件测试领域,编写测试用例长期是耗时耗力的重复劳动。一位 B 站 UP 主分享的实战案例展示了如何用 Claude Code 结合 Skills 技能机制,将需求文档自动转化为可落地的 Web 测试用例,整个流程不到十分钟就能完成过去需要数天的工作量。本文基于该演示,梳理其核心工作流与技术要点。
三阶段自动化流水线
整套方案的核心是一条由 AI 驱动的三阶段流水线。用户只需发出一条自然语言指令——"请调用技能对需求文档生成测试用例"——AI 便会自动解析意图,依次调用三个独立的 Skill 完成任务。
第一阶段是需求文档拆分,第二阶段是测试点提取,第三阶段是测试用例生成。每个阶段对应一个专门的技能,各司其职、层层递进。这种把复杂任务拆解为多个可复用技能的设计,是 Claude Code Skills 机制的典型用法,既保证了流程的可控性,也便于针对每个环节单独调优。
演示中的需求文档共有九个章节,其中三、四、五、六章包含最核心的业务需求。AI 识别到文档后,先规划出完整的三阶段流程,再逐步执行,整个过程对用户透明可见。
Claude Code Skills 机制是 Claude Code 提供的一种可复用任务模块化能力,允许用户将常见操作封装为独立的"技能"(Skill),并在对话中通过自然语言调用。每个 Skill 本质上是一段预设的提示词模板或脚本,定义了输入格式、处理逻辑和输出规范。多个 Skill 可以通过编排(Orchestration)串联成流水线,前一个 Skill 的输出自动成为下一个的输入。这种设计的优势在于:复杂任务被分解为职责单一的模块,每个模块可以独立测试和优化,出错时也更容易定位问题所在的环节,而非面对一个难以调试的"黑箱"。对团队协作而言,固化了测试方法论的 Skill 库还可以在成员之间共享复用。
第一阶段:原样拆分与需求评审
需求拆分环节遵循一个关键原则:按章节原原本本地拆分,不增不减、不做提取,只做"切分"。最终九个章节被拆分成九个独立文件夹,保持原始需求不变。
这一阶段的难点在于对表格和图片的处理。演示中要求 AI 将表格形式的需求(如商品详情页的字段说明)和图片形式的流程图统一转换为纯文字描述。UP 主解释了背后的逻辑:文字格式更利于大模型后续理解和处理,"会更清晰"。这是一个值得关注的工程细节——多模态内容的结构化转换,直接影响下游测试点提取的质量。
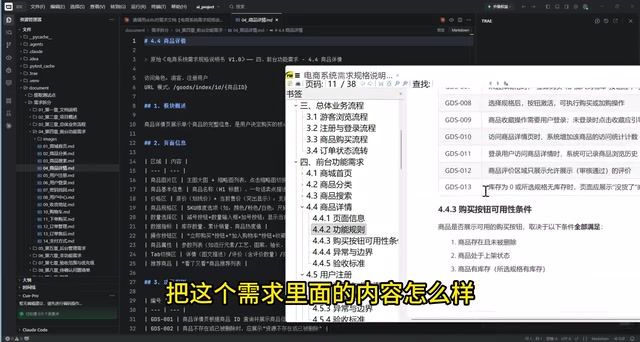
拆分的同时,AI 还会做一轮需求评审,重点标记出需求中不明确、模糊的地方。以第三章的"游客浏览流程"为例,拆分结果会标注原始位置(第三章 3.1)、模块概述、转换后的文字流程、功能规则,以及条件异常、边界和验收标准。这种结构化输出让后续处理有据可依。
第二阶段:智能提取测试点
第二阶段的价值在于"去噪"。AI 会自动跳过第一、第二章这类文档说明和概述性内容——它们并非实际需求,而是聚焦于真正需要测试的功能章节。
每个测试点都以统一的结构化格式输出,包含所属模块、标题、状态、步骤、预期结果、优先级,以及所使用的测试设计方法。例如"验证游客访问商城首页"这类正常流程会被单独识别为一个测试点。演示强调,所有提取出的测试点在最后都会经过 AI 自动评审,确保覆盖完整性。
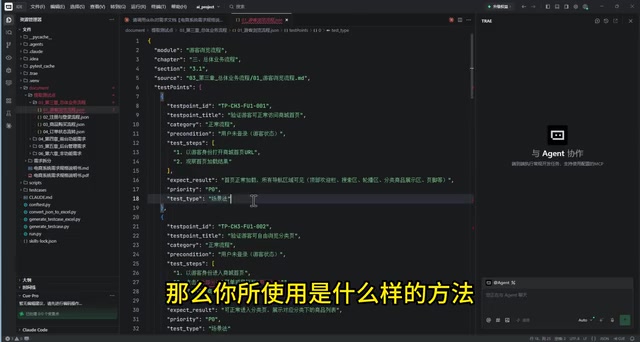
每个章节下的功能都生成了这种带方法标注的测试点结构,形成了从需求到用例之间的中间层。这一层的存在让整个流程更接近专业测试人员的思维路径:先分析出测什么,再决定怎么测。
测试点中提到的测试设计方法标注,指的是软件测试领域的经典用例设计技术。常见方法包括:等价类划分(将输入数据划分为有效与无效等价类,各取代表值测试)、边界值分析(重点测试边界附近的值,如最大值、最小值)、判定表法(适用于多条件组合的复杂业务逻辑)、场景法(基于用户操作流程设计端到端场景)等。AI 在提取测试点时自动标注所用方法,意味着生成的用例不只是"凭感觉"罗列,而是遵循了有据可查的测试工程规范。这也是该方案声称产出质量较高的底层原因之一——方法论被固化进了 Skill 的提示词设计中。
第三阶段:生成可落地的测试用例
最后一步调用导出测试用例的技能,将测试点转化为完整用例。生成结果先给出一份总结,列出每个章节包含多少条用例,再展开到具体功能层级。
以第三章游客浏览的第一个功能为例,一句原始需求被拆解成了八条测试用例:正常访问首页、分类浏览、搜索功能、商品详情,以及涉及购物车、收藏、下单、用户中心时的登录引导流程。每条用例都包含标题、测试类型、优先级、前置条件、测试数据、操作步骤、预期结果,并额外保留一列供人工评审,同时关联对应的测试点,实现可追溯。
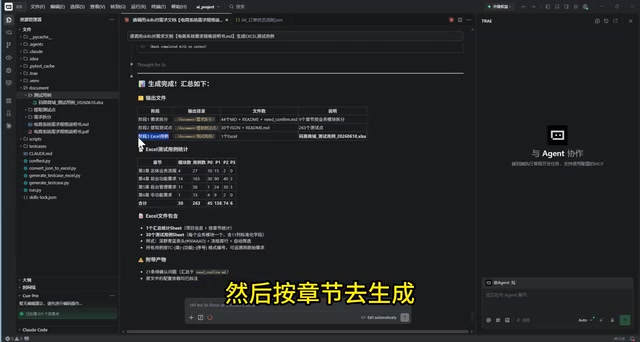
UP 主评价这些是"落地级别"的测试用例,认为质量甚至优于部分手工编写的成果。
效率对比与理性看待
从效率角度看,整个流程从指令下达到用例生成完成,耗时不到十分钟。UP 主称相比手工编写,效率提升"至少不止一倍"。说一下,标题中"提升10倍"的说法更多是宣传口径,实际提升幅度取决于需求文档的规模和复杂度,演示中并未给出严格的量化对照。
这套方案真正的价值不在于绝对速度,而在于三点:一是通过多技能编排把模糊的"生成用例"任务拆成了可控、可评审的环节;二是解决了表格、图片等多模态需求的结构化难题;三是保留了人工评审列和测试点溯源,让 AI 产出可以纳入现有测试流程而非另起炉灶。
对测试团队而言,这类工作流的启示是:AI 辅助测试的关键不是让模型"一步到位",而是设计合理的分阶段技能链,把人类的测试方法论固化进流程中。当然,AI 生成的用例仍需人工把关,尤其是对边界条件和异常场景的判断,短期内仍离不开测试工程师的经验。
需要注意的是,演示中的需求文档属于结构化程度较高的标准 PRD(产品需求文档),章节清晰、字段规范,这类文档最适合当前方案发挥效果。实际项目中,需求文档往往存在口语化描述、逻辑矛盾、需求散落在会议纪要或聊天记录中等情况,此时 AI 的拆分和提取质量会显著下降。此外,本演示并未涉及接口测试、性能测试、安全测试等测试类型,主要覆盖的是基于用户界面操作的功能测试场景。评估这套方案对自身团队的适用性时,文档质量和测试类型范围是两个关键变量。
相关推荐
Boox Palma 3发布:新增手写笔支持与全新设计
Boox Palma 3正式发布,新增手写笔支持并采用全新简洁设计。作为口袋尺寸的黑白电子墨水屏阅读器,它在功能升级的同时价格明显上涨。本文解析Palma 3的核心变化与升级价值。
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。