Claude Code Subagents 实战:隔离上下文与并行代理

Claude Code 子代理通过隔离上下文、匹配模型、支持并行,解决长对话的上下文污染问题,但需警惕其较高的 token 冷启动成本。
Claude Code 的子代理(Subagent)机制通过为每个子任务创建独立的上下文、工具集与系统提示,从架构层面解决了长对话中的上下文污染问题。子代理在隔离环境中运行,完成后只将结果返回主对话,不留中间过程噪声;多个子代理可并行运行,也可通过 fork/branch 选择性继承主对话上下文。内置代理(如用 Haiku 的 Explore)与自定义代理支持按任务复杂度匹配不同模型,兼顾性能与成本。然而子代理每次从零建立上下文、无缓存复用,token 消耗显著高于主对话,需定期通过 `usage` 命令排查后台静默运行的代理,并在创建时谨慎设定触发描述和模型选择,避免不必要的高额消耗。
什么是 Subagents(子代理)
在 Claude Code 中,默认情况下所有操作都发生在同一个循环、同一段对话里。每一次工具调用结果、每一条用户消息,都会被追加进那个底层的 messages 数组。问题也随之而来:上下文里塞进的随机内容越多——各种文件、工具返回值、与初始任务无关的信息——模型给出的回答就越容易偏离主线。你可能最初只想「加一个按钮」,结果对话里堆满了与此无关的噪声。
子代理(Subagent)正是为了解决这种上下文污染而生。按照 B 站 UP 主 Lydia 在 Claude Code 入门教程中的说法,子代理本质上是一个独立的循环:它拥有自己的上下文、自己的工具集、自己的系统提示词。主代理可以派生出一个子代理,让它在后台的「分叉环境」里独立运行,最终只把结果返回给主代理。
这意味着子代理运行过程中产生的所有工具调用结果、中间文件读取等等,都不会污染主对话。更关键的是,子代理还能并行派生——你可以同时跑多个进程,它们甚至可以同时触碰同一个文件,最后各自带着结果回来,主循环再决定「我到底想要哪一个」。
从技术实现角度看,「上下文污染」的本质是大语言模型的注意力机制对所有输入 token 一视同仁——随着 messages 数组膨胀,早期关键指令的有效权重被稀释,模型更容易被最近输入的噪声内容「带偏」。这在长对话中尤为明显:当上下文窗口里堆满了中间文件内容、工具返回的调试日志时,模型对原始任务目标的「记忆」会逐渐模糊。子代理通过物理隔离上下文来规避这一问题,而非依赖提示词工程去对抗注意力稀释——这是架构层面的解法,而非提示层面的补丁。
内置代理与自定义代理
在 Claude Code 里运行 agents 命令,就能看到当前可用的子代理。工具自带了几个内置代理:
- Claude Code Guide:拥有访问官方文档的权限,当你向 Claude Code 询问关于它自身的问题时,就会调用这个子代理
- Explore:用于在代码库中查找内容,这是日常会话中出现频率最高的代理之一
- General Purpose / Plan / Status Line Setup:通用、规划与状态栏配置
值得关注的一个细节是模型选择。Explore 代理用的是 Haiku 模型——因为「在代码库里找东西」这类任务不需要推理能力,用 Haiku 既快又省。这其实点出了子代理设计的核心思路:为合适的任务匹配合适的模型。
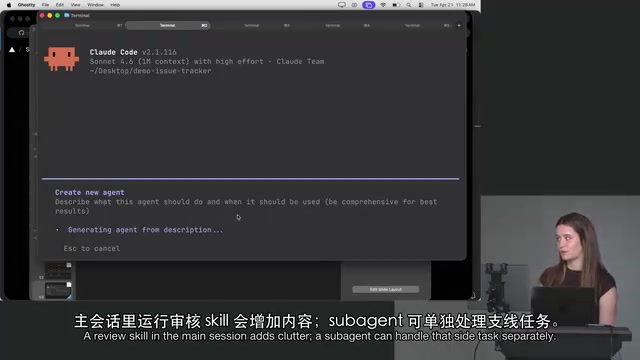
创建自定义代理也很简单。运行创建命令后,Claude Code 会先问你把代理建在项目级还是个人级——个人级意味着这个代理能在多个项目、多个仓库之间复用。接着你可以让 Claude Code 直接帮你生成,比如「写一个执行代码审查的代理」。生成过程中它会询问:这个代理应该拥有哪些工具?用什么模型(代码审查用 Sonnet 就够了)?要不要设置颜色标识?
子代理 vs 技能(Skill)
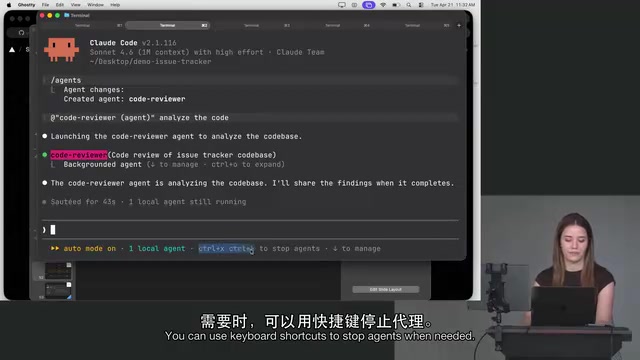
一个常见的疑问是:为什么不直接用 Skill?Lydia 给出的判断标准很实用。如果你在一段「加按钮」的会话中途插入一个代码审查 Skill,审查过程会给当前上下文带来大量杂乱内容。而对于这种一次性任务,用子代理更合适——它在自己独立的环境里运行,拥有自己的小型系统提示(「你是一位专家级代码审查员……」),完成后只返回结果,不会把过程污染进主对话。
Skill(技能)在 Claude Code 中通常指可复用的、嵌入主对话流程的指令模板或工具调用序列,类似「宏」或「函数」——调用时它的执行过程和产物仍然留在当前 messages 数组里。子代理与 Skill 的核心区别不在于功能强弱,而在于执行环境的隔离性:Skill 是在主对话「内部」运行,子代理是在主对话「外部」运行后返回结果。因此选择标准可以简化为:如果任务的中间过程对主对话有价值,用 Skill;如果只关心最终输出、不希望过程污染上下文,用子代理。
代理如何被调用与运行
自定义的 code reviewer 代理生成后,Claude Code 会自动给它写一段相当到位的描述,例如「当代码被编写或修改、需要就质量和正确性进行审查时使用此代理」。这段描述不只是注释——它决定了模型何时自动触发该代理。
代理可以手动调用,也可以由模型自动判断调用。从机制上看,代理运行本质上就是模型向 harness(运行时框架)发起一次 agent 工具调用,由 harness 决定派生这个子代理。运行时你能看到它读取文件、执行工具调用,界面上甚至还带着你设定的颜色(教程里用的是粉色)。
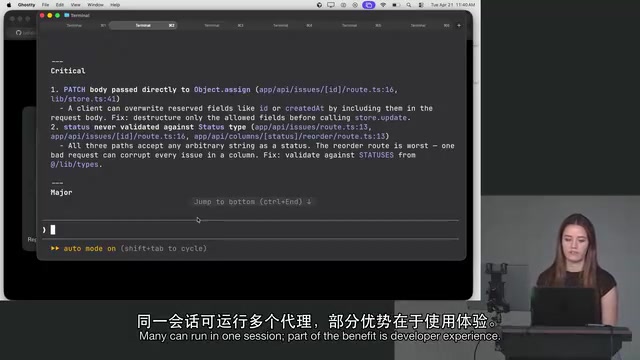
尽管看起来像在主线程里发生,这些操作并不会追加到主对话的 messages 数组中。你还可以把代理放到后台运行,一边继续在主线程写代码,一边看它消耗了多少 token、做了哪些工具调用。如果想中止代理,用 Control-X 加 Control-K 即可。
Fork / Branch:带上下文的子代理
默认情况下子代理不共享主对话的上下文,它们只拿到主代理生成的、关于项目概况与任务目标的摘要版系统提示。但 Claude Code 还提供了 fork(现在似乎改叫 branch)机制:如果此前已有对话,使用 branch/fork 会让子代理继承原有对话,同时仍在并行的子环境中运行。这是在「完全隔离」与「继承上下文」之间的折中选项。
Git 中的 fork 与 branch 概念在这里被借用来描述上下文继承方式,但含义有所不同:branch(或早期的 fork)机制让子代理获得主对话的一份「快照副本」,在此基础上独立运行,主对话本身不受影响。这类似于函数式编程中的「不可变数据结构」思想——子代理读到的是继承时刻的上下文,此后双方的修改互不干扰。实际使用中,当你希望子代理了解当前任务的完整背景(而非仅靠摘要推断),但又不想让它的探索性操作污染主线程时,branch 是更精确的工具。
Token 消耗:子代理的隐藏成本
子代理虽然强大,但有一个容易被忽视的代价——它们很费 token。原因在于每个子代理几乎都是从头开始建立基础上下文,此时没有任何缓存的提示词(cached prompts)可以复用。多个子代理并行运行,尤其是在你并不知情的情况下,token 消耗会迅速累积。
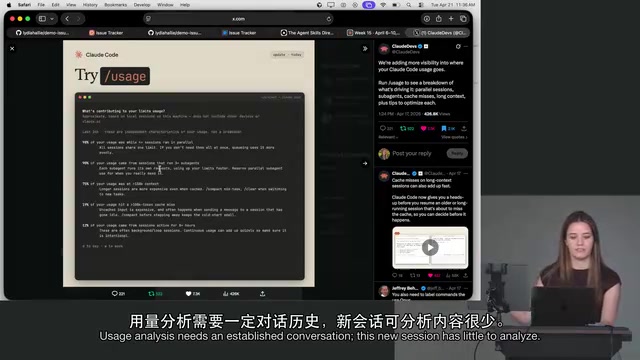
Lydia 提到一个即将上线的用量分析功能:在足够长的会话里,运行 usage 可以看到类似「你 98% 的用量来自并行运行的四个以上会话」或「你的用量来自运行了三个以上子代理的会话」这样的归因。很多人根本不知道自己在后台跑着子代理,而这往往是用量去向的大头。
实用建议有两条:定期运行 usage 排查是否有不想要的后台代理在跑;创建代理时选对模型——别用 Opus(还开 effort max)去跑代码审查,Sonnet 甚至 Haiku 就够了,Opus 固然强但你要为它付费。另外,代理描述写得太宽泛也有风险——如果 code reviewer 的触发条件写成「代码被修改即审查」,它可能在每一次文件编辑后都自动运行,而你未必察觉。
「无缓存复用」的代价值得进一步理解。Claude 的 API 支持 prompt caching——对于重复出现的长前缀(如系统提示、项目文档),缓存命中后的 token 费用大幅低于首次处理。主对话在持续运行过程中会逐渐建立起这种缓存优势;而每个新派生的子代理都是全新会话,缓存从零开始,前几轮交互的 token 成本最高。在高并发场景下(同时派生 4 个以上子代理),这种「冷启动」成本会同时叠加多份,导致单位时间内的 token 消耗出现脉冲式峰值,这正是 usage 分析功能试图让用户看见的隐藏账单。
Subagent、Session 还是 Work Tree?
关于「该用子代理、新会话还是 Git work tree」,Lydia 坦言答案是「视情况而定」。
- 子代理的优势在于结果会回到主对话,适合与当前任务相关、且需要主代理后续处理的场景;同时能在同一会话内大量并行运行。
- Git work tree 则会在不同分支下创建目录的小型克隆,包括 node_modules,因此每次都要重装依赖,相当笨重。Lydia 个人并不偏好 work tree 的体验,尽管承认很多人在用,官方桌面应用也默认使用它。
- 对于可重复的任务,子代理比每次都要手动跑 Skill 的新会话摩擦更小——让模型自己决定「这该跑一下」再回到主线程,这是主会话做不到的。
教程里一个更有价值的观点是:使用 Claude Code 很大程度上是在建立自己的直觉。Lydia 把不同模型类比成团队角色——Opus 像无所不知、热衷钻研的资深工程师,Haiku 则像擅长重复性任务的实习生。这种心智模型的转变,比任何「最佳实践」清单都更能改变你使用工具的方式。
她还提醒:每当新模型发布(比如 Opus 4.7),都值得重新评估你的 CLAUDE.md 与 Skill 配置。例如 Opus 4.7 在遵循指令方面明显更强,很多人过去在 CLAUDE.md 里堆砌感叹号、「不要做这个」的强调写法,到了新模型可能不再必要。两个月前有效的配置今天或许仍能工作,只是不再高效。工具和模型都在持续演进,使用者也需要跟着一起成长。
相关推荐

空陆两栖变形无人机:除了省电100倍,还有什么真需求?
空陆两栖变形无人机是否只是噱头?从M4 Morphobot的100倍功耗差异出发,探讨变形无人机的真实应用场景与论文选题思路,分析纯无人机和纯地面机器人均失效的边界条件。

Warhound融资2亿美元:基因工程“战犬”搭配Anduril装备
Warhound完成2亿美元融资,由Ben Lamm和Palmer Luckey推动,通过基因工程改造犬类用于军事和执法,并搭配Anduril装备。本文分析其技术方向、融资逻辑与伦理争议。

Claude API登陆Google Cloud:IAM集成与SDK接入指南
Anthropic将完整Claude API托管在Google Cloud上,通过Google Cloud IAM控制权限并统一计费。本文梳理Vertex AI与Anthropic托管两个服务入口、IAM角色配置要点及SDK接入方式,帮助企业复用现有云治理框架引入Claude模型。