Claude Code ultrathink 升级:单轮推理强度拉满 xhigh
Claude Code 2.1.311 起 ultrathink 可将单轮推理强度提升至 xhigh。
Claude Code 从 2.1.311 版本开始,在输入框输入 ultrathink 即可将当前这一轮对话的推理强度临时提升至 xhigh effort,而不再只是提示词彩蛋。该行为覆盖 Opus 5.5、Sonnet 5.5、Haiku 5.5 与 Fable 5.1 四个模型,但存在生效边界与上限约束,并非无条件拉满。其核心价值在于把推理强度从全局配置变为单轮可调,让开发者在一个长会话中按需分配算力:复杂重构、跨文件调试时加码,日常补全时回归默认。文章还指出这一变化反映 effort 正逐步成为与 temperature、context window 并列的标准调节参数。
Claude Code 的「ultrathink」关键字不再只是一个提示词彩蛋。从 2.1.311 版本开始,在输入框里敲下 ultrathink,当前这一轮对话的推理强度会被直接拉到 xhigh effort。这条变化看似只是多了一个档位,实际上把「按需分配算力」的控制权交还给了开发者。
ultrathink 到底改变了什么
在 Claude Code 里,effort(推理强度)是一个贯穿每次请求的隐形旋钮。档位越高,模型在给出答案前「愿意花的时间」越长,中间推理链更完整,面对复杂重构、跨文件调试这类任务时出错率更低。ultrathink 的作用是在单轮对话内临时把旋钮拧到 xhigh,而不是全局修改配置。
这意味着你可以在一个长会话里保持默认强度,只在真正需要深度思考的那一轮喊一声 ultrathink。对习惯了「一个会话从头到尾同一档位」的用户来说,这是更精细的算力调度方式。
推理强度(effort)与中间推理链
在现代大模型 API 中,effort 通常指模型在返回最终答案前允许投入的计算量预算,常见实现方式是控制「思考 token」的数量或采样步数。开启高 effort 后,模型会先生成一段不直接展示给用户的内部推理过程(即中间推理链,chain of thought),再基于它给出结论。这条链路越长,模型越有机会拆解子问题、自我检查、回溯错误分支,因此在多步推理任务上准确率更高。代价是响应延迟增加、token 消耗上升——推理链本身也计入计费。这意味着 effort 本质是一个成本与质量的权衡旋钮,而非单纯的「更聪明」开关。
支持范围与生效条件
据源信息,该行为覆盖 Opus 5.5、Sonnet 5.5、Haiku 5.5 以及 Fable 5.1 四个模型。换句话说,从旗舰到轻量型号都在生效范围内,ultrathink 不是某个大模型专属的待遇。
源信息同时提到「when it works, when it does not, and caps」——即存在生效边界和上限约束。这一点值得留意:ultrathink 并非无条件把推理拉满,实际行为会受具体场景和额度限制影响。原文没有展开细则,但它提醒我们不要把 ultrathink 当成万能开关,它更接近「在当前条件下尽量提高」而非「无视一切约束」。
「xhigh」档位与 caps 的含义
在多数推理强度分级体系中,档位通常从 low、medium、high 到更高的 xhigh 逐级递进,xhigh 属于接近顶格的档位而非绝对上限。所谓 caps(上限约束),一般指服务端对单次请求或单会话设置的推理 token 预算、速率限制或额度配额。当模型实际可用的推理预算被这些约束截断时,即便指定了 xhigh,真实生效的强度也可能低于名义值。这解释了为什么连续多轮 ultrathink 的收益可能递减:触达阈值后,后续请求会被削顶。理解这一点有助于正确归因——效果不佳更可能是额度受限,而非关键字未被识别。
对日常开发工作流的影响
最直接的变化是成本与延迟的心智模型变了。过去想用高强度推理,要么全局调高配置、要么换更强的模型;现在同一会话里可以逐轮切换。调试一个诡异的并发问题时 ultrathink 一轮,改完再回到普通强度写样板代码,算力花在刀刃上。
另一个隐性收益是协作场景。团队共享的 Claude Code 配置通常偏保守,避免每次都触发高消耗。ultrathink 提供了一种「个体临时加码」的路径,不需要改动团队级设置,也不会影响其他人的默认体验。
使用建议与注意事项
第一,把 ultrathink 留给真正需要多步推理的任务,比如跨文件的架构调整、难以复现的 bug 定位、对现有代码逻辑的深度审查。日常补全、改错别字这类任务上用它,收益不明显。
第二,留意 caps 的存在。既然存在上限约束,连续多轮 ultrathink 可能触达阈值,实际表现未必线性提升。遇到效果不及预期时,先确认是否已经顶到上限,而不是怀疑关键字没生效。
第三,模型选择依然重要。ultrathink 提升的是推理强度,不改变模型本身的能力边界。轻量模型拉满强度,和旗舰模型默认强度之间如何取舍,需要按任务类型实测。
一个信号:推理强度正在成为一等公民
从全局配置到单轮指令,推理强度的控制粒度在变细。这背后是模型能力提升后,用户对「可控性」的需求在上升——大家不再只关心模型能不能做对,还关心它花了多少代价做对。ultrathink 是这条演进线上的一小步,但它指向的方向很明确:未来的 AI 编程工具,effort 会和 temperature、context window 一样,成为开发者日常调节的标准参数。
为什么 effort 正走向「一等公民」
在 AI 编程工具的参数谱系里,temperature 控制输出随机性,context window 决定可见信息量,而 effort 控制的是「思考深度」,三者分别对应创造性、信息面与推理投入三个正交维度。早期产品往往把 effort 藏在全局配置里,原因是模型能力有限、调参收益不稳定;当模型在复杂任务上的表现对推理预算越来越敏感时,把 effort 暴露为可逐轮调节的参数,就从业余选项变成了必要能力。这也符合成本工程的逻辑:并非每个请求都值得高预算,按需分配比全局拉满更经济。ultrathink 这类关键字本质是把 effort 参数做成了会话内的轻量语法糖。
相关推荐
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
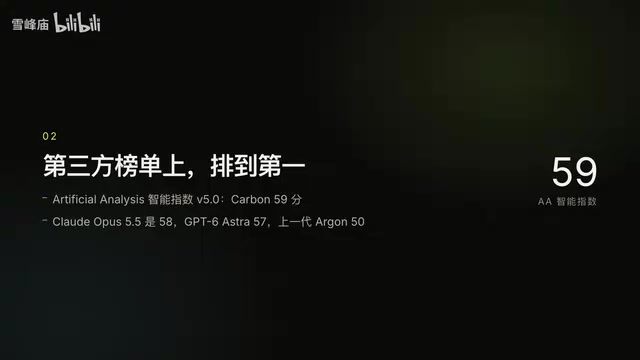
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。