Claude Code工程化实战:用Harness方法写出可维护的AI代码

从"AI幻觉"到工程化:AI编程的真实痛点
用过AI编程工具的开发者,几乎都踩过同一个坑:上下文一旦丢失,AI就开始"一本正经地胡说八道"。不管你问什么,它都能给出一段逻辑自洽的代码或解释——看着像对的,实际上问题重重。
这就是业界熟知的幻觉(Hallucination)问题。AI幻觉本质上源于大语言模型的生成机制:LLM基于概率分布预测下一个token,而非从知识库中检索事实。当模型缺乏足够上下文、训练数据存在偏差或问题超出训练分布时,它会以高置信度生成听起来合理但实际错误的内容。
从更底层的技术视角看,这一问题与Transformer架构的注意力机制(Attention Mechanism)密切相关。Transformer由Vaswani等人在2017年的论文《Attention Is All You Need》中提出,其自注意力机制通过计算序列中每对词元之间的相关性权重来捕捉长距离依赖关系。然而,这一机制在处理超出训练分布的输入时会产生一种"置信度虚高"的现象——模型无法区分"我知道答案"与"我在统计上最可能续写的是这个"之间的本质差异。这在编程场景中尤为危险:代码的正确性要求是二元的(要么对要么错),而语言模型的输出却是连续的概率分布。模型通过自注意力在序列中捕捉词元依赖,但对超出训练分布的输入极度敏感——它会倾向于"补全"自认为最合理的续写,而非承认知识边界。在编程场景中,这表现为调用不存在的API、生成语法正确但逻辑错误的代码、混淆不同版本的库接口等。
上下文窗口(Context Window)的限制进一步加剧了这一问题——主流模型的窗口从早期的4K token扩展到今天的100K乃至200K token,但这仍无法解决根本矛盾:企业级项目的完整代码库、历史决策记录和业务约束往往远超任何窗口容量。更深层的隐患在于"注意力稀释"现象,斯坦福大学2023年的研究论文《Lost in the Middle: How Language Models Use Long Contexts》通过实验验证了一个反直觉的结论:即使将关键信息完整放入上下文窗口,当该信息位于窗口中间位置时,模型的检索准确率会显著下降——相比信息位于开头或结尾,性能损失可达20%以上。这一现象的本质原因在于Transformer的位置编码机制和训练数据分布的双重影响:模型在预训练阶段更多接触的是"开头和结尾信息密度高"的文本结构,导致其注意力权重在长序列中分布不均。学界将其称为"Lost in the Middle"效应——窗口越长,模型对早期注入的关键约束的关注度反而下降。一旦关键的项目约束、已有代码结构或业务规则超出窗口被截断,模型便失去"锚点",开始依赖统计规律而非真实需求进行生成。对于企业级项目而言,这意味着即使扩大上下文窗口,也无法线性地提升AI对复杂项目约束的理解准确率,这正是RAG和结构化记忆系统存在价值的核心技术动因。个人练手项目里无伤大雅,但在企业级交付场景中,这种不可控性会带来严重的质量隐患。
如何用AI写出可控、长期可维护的代码,而不是一次性"玩具代码",正在成为大厂和优质IT公司共同关注的核心命题。本文结合B站实战课内容,围绕这一痛点,重点拆解 Harness AI工程化编程 这套方法论在真实项目中的落地路径。
工具只是载体,方法论才是核心
课程演示环境是 VS Code + Claude Code,但作者反复强调一点:工具本身并不是关键。无论你用 Claude Code、Codex 还是 Cursor,本质上没有太大区别——它们只是承载工程化方法的载体。
为什么不在工具细节上纠结
AI编程工具的基础操作其实相当简单,入门内容交给配套文档即可,宝贵的实战时间应该用在讲清楚企业级项目中真实遇到的问题和解决思路上。
这个取舍值得每个开发者深思:当大多数人追逐"某某工具的100个技巧"时,真正拉开差距的往往是对底层工程化方法的理解。掌握了方法,换任何工具、任何语言都能快速迁移。

反向拆解:Claude Code背后的Harness工程
一个值得关注的技术细节是:Claude Code 之所以功能强大,根本原因在于它的后端本质上就是一套标准的 Harness 工程。
Harness工程化编程并非特指某款产品,而是一套将AI能力嵌入软件工程流程的方法论框架,其名称本身即来源于"驾驭"(harness)AI能力、而非被其随机性左右的核心理念。从技术实现角度,它综合运用三类机制:结构化提示词模板(通过角色设定、约束注入和少样本示例将AI输出锚定在预期范围)、外部记忆系统(通过向量数据库将超出窗口的项目上下文持久化,并在每次调用时通过RAG检索增强生成动态注入)、以及输出验证管道(通过静态分析、单元测试自动执行和代码审查规则拦截幻觉产物)。这三者的有机组合,构成了将AI从"概率生成器"转变为"可信工程组件"的完整闭环。
Claude Code之所以被认为是Harness工程的典型实现,在于它系统性地解决了上下文持久化与任务分解编排两大核心工程问题,而非仅仅提供更好的代码补全体验。课程中作者计划打开 GitHub 上 Claude Code 的开源源码,带大家分析其 Harness 工程设计——据其评价"设计得相当扎实"。
这为开发者提供了一条高价值的学习路径:与其停留在使用层面,不如反向研究顶级工具的工程架构,理解它们是如何组织提示词策略、管理上下文和编排协作流程的。
规范驱动开发(SDD)与Agent化趋势
课程的核心知识体系,覆盖了当前AI编程领域几个最前沿的方向。
SDD:规范驱动开发
SDD(Specification-Driven Development,规范驱动开发) 是目前稍具规模的IT公司和大厂都在推行的开发范式。
SDD脱胎于Bertrand Meyer在1986年提出的**契约式设计(Design by Contract, DbC)**理念。Meyer在设计Eiffel编程语言时将这一理念系统化为可执行规范,通过前置条件(require)、后置条件(ensure)和类不变量(invariant)在代码层面直接表达语义约束。此后,Z符号语言、Alloy等形式化规约工具进一步推动了规范与实现的分离。在AI编程时代,这一理念完成了从"人机协作规范"向"人-AI协作规范"的范式迁移:其核心三要素——前置条件(Preconditions)、后置条件(Postconditions)和不变量(Invariants)——为系统行为提供了形式化描述框架。在编写任何代码之前,先用结构化的规范文档(Spec)精确描述系统行为、接口契约、数据模型和边界条件——这份规范既是人类团队协作的共识文档,也是AI生成代码时的强约束锚点。规范文档不再只是人类工程师之间的沟通媒介,更成为约束LLM输出行为的"对齐文档"。
与OpenAPI规范(面向接口描述)、ADR架构决策记录(面向设计决策)等传统工程文档不同,现代SDD实践中的Spec是面向AI可消费性(AI-consumable)专门设计的,常用的规范格式包括JSON Schema(约束数据结构)、OpenAPI/AsyncAPI(约束接口行为),以及专为AI设计的自然语言+结构化标注的混合格式——后者在保持人类可读性的同时,针对LLM的token消费模式进行了语义密度优化。其颗粒度、语义密度和结构化程度均针对LLM的输入特性做了优化。与测试驱动开发(TDD)相比,SDD的粒度更粗、更偏向业务语义而非实现细节,能让AI在更宽泛的任务范围内保持输出一致性。在多Agent协作场景下,Spec文档还扮演着"共享记忆"的角色,有效缓解了不同Agent之间因上下文不一致导致的输出漂移问题。
现实情况是:如果你去面试Java、Python或Go岗位,被问到规范驱动开发却答不上来,很可能会直接暴露出对技术迭代不够敏感这一短板,在内卷的就业环境下,丢掉offer的概率不小。
Agent化:从"写代码"到"编排智能体"
Agent(智能体)化开发是当下AI大模型领域最热的方向。不论你主攻Java、Python还是Go,Agent 都是绕不过去的话题。甚至有观点认为:未来开发者不再写具体代码,而是转向"开发和编排一个个 Agent"。
多Agent系统(Multi-Agent System, MAS)的理论根源可追溯至1980年代的分布式人工智能研究,但以LLM为底座的现代Agent与经典MAS存在本质差异:每个Agent不再需要手工编程定义行为逻辑,而是通过自然语言的角色描述(Persona)和工具调用能力(Tool Use / Function Calling)获得自主执行特定任务的能力。
Agent化开发的兴起,本质上是将软件工程中的"关注点分离"原则延伸到了AI协作层面。每个Agent被设计为具备特定职责边界的自主执行单元:需求分析Agent负责将模糊的用户故事转化为结构化Spec,编码Agent在Spec约束下生成实现,评审Agent执行代码质量检查,测试Agent生成并运行用例,CI/CD Agent负责流水线编排与部署。这种分工的核心价值在于"局部上下文最优化"——每个Agent只需维护其职责范围内的精简上下文,从而显著降低幻觉概率并提升输出可控性。
主流的Agent编排框架(如LangGraph、AutoGen、CrewAI)普遍采用有向无环图(DAG)或状态机(State Machine)模型定义Agent间协作流程,确保任务流转的可预测性。值得关注的是,Agent间通信的协议标准化正成为新的工程挑战——Anthropic于2024年11月发布的MCP(Model Context Protocol)协议,采用客户端-服务器架构,定义了AI模型(Client)与外部工具/数据源(Server)之间标准化的上下文传递和工具调用协议,支持Resources(文件、数据库记录等静态资源)、Tools(可执行函数)和Prompts(可复用提示词模板)三类原语。MCP的战略意义在于将过去各AI工具私有化的集成逻辑标准化为可互操作的开放协议,类似于USB统一了设备接口,或LSP(Language Server Protocol)统一了语言服务与编辑器的集成方式——其重要性可类比于Web服务时代REST架构风格的确立。目前已有VS Code、Claude Desktop、Zed等主流工具宣布支持MCP,生态正在快速形成。从更宏观的视角看,这与微服务将单体应用拆解为职责单一的服务单元在理念上高度同构,只不过协作单元从代码模块变成了智能体。
课程在企业级实战项目中落地了约 6个核心 Agent,完整覆盖需求分析、编码实现、项目评审、测试、持续集成到上线部署的全流程。这套 Agent 设计,正是从"人写代码"向"人编排 Agent"过渡的真实样本。
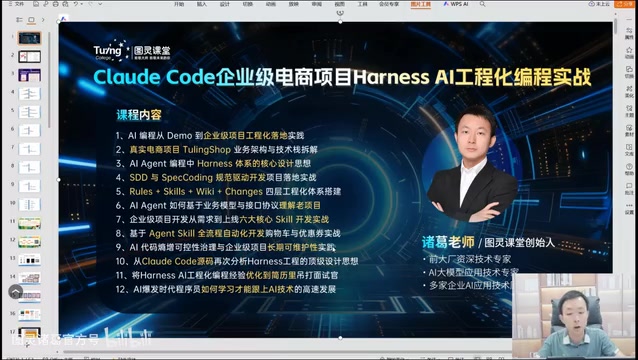
以电商项目为例:方法论不挑语言、不挑场景
课程选择电商项目作为实战载体,理由很务实:大多数开发者对电商业务足够熟悉,无需花大量时间解释陌生领域逻辑,可以把精力集中在 Harness AI 工程方法本身。
普适性:换语言不换方法
Harness AI 工程化编程既不挑项目也不挑语言。演示代码以 Java 为主,但 PHP、Go 等语言的项目,方法完全一致。一旦理解了核心方案,切换到任何技术栈都没有本质障碍。
这正是工程化方法的价值所在——它抽象于具体技术栈之上,是一套关于"如何与AI高效协作交付软件"的通用范式。
实战优先:解决"看完还是不会用"的困境
市面上关于 Harness Engineering 的视频和文档并不少,但很多开发者反映:概念听了一堆,依然不知道"这东西到底怎么落地"。这种"看完仍不会用"的挫败感,是纯理论教学的通病。
本课程的差异化在于以实战为主、理论为辅:直接从真实企业级项目出发,让抽象概念真正落地,让学习者在动手过程中理解方法、并能立即应用到自己的项目中。
写在最后:AI编程的下一站是工程化
随着 AI 编程工具能力的持续跃升,单纯"会用工具"已经不再是竞争壁垒。真正的核心竞争力,在于能否用 AI 写出可控、可维护、可交付的工程级代码,能否理解 SDD、Agent 编排这些正在重塑软件开发流程的新范式。
无论你使用哪种工具、哪种语言,投入时间理解 Harness 这类工程化方法论、反向研究顶级工具的架构设计,都是当下开发者最值得做的技术投资之一。AI 编程的下一站,一定是工程化。
核心要点
核心要点
核心要点
相关推荐

离子推进器:赢得太空竞赛的慢速火箭
离子推进器以极低推力、极高效率成为太空深空探测与货运物流的关键技术。本文解析离子引擎的工作原理、氙气推进剂的选择、太阳能与核电推进的权衡,以及它为何可能成为建造星际文明的"慢速火箭"。

人类造过最快的东西:帕克太阳探测器的43万英里时速
人类建造过最快的物体不是旅行者号或火箭,而是NASA帕克太阳探测器,时速约43万英里。本文解析它如何借助金星引力辅助与太阳引力井加速,以及为何以光速衡量人类仍刚刚起步。

美光CEO警告:内存供应将在未来两年持续趋紧
美光CEO表示存储芯片供应将在未来两年比当前更为紧张,AI需求激增与产能扩张滞后是主因。本文分析内存供应趋紧的原因及其对市场和消费者的影响。