Claude Code进阶工作流:命令、子代理、技能三层分工实战

用三层分工把Claude Code从问答机器人升级为有规划、会审查、能复盘的自动化开发团队。
这套由UP主公开的Claude Code工作流,将AI编程能力组织成命令、代理、技能三层结构:17个斜杠命令作为手动触发的流程节点,强制"先规划后动手"并设置质量门禁;14个子代理在独立上下文中各司其职,分规划开发、审查、修复三组,避免污染主对话;105个技能按需加载,覆盖从工程工作流到视频动效的广泛场景。三层串成一条完整流水线,最终经验通过PostgreSQL陷阱库沉淀为可查询的结构化知识,已积累83条根因与解法,同类报错不再踩第二次。整套体系的核心哲学是:把AI从万能助手变成有明确分工、会持续复盘的团队。
从聊天框到自动化团队:重新理解Claude Code
很多人用Claude Code,还停留在把它当成一个聊天框——提问、得到回答、复制代码。但真正把它的能力压榨出来,需要一套结构化的工作流。这套由B站UP主分享的自用体系,把17个斜杠命令、14个子代理、105个技能组织成三层分工,最底层还有全局规范和陷阱库兜底。
核心思路只有一句:把AI组织成一个有分工、会复盘的团队,而不是一个单打独斗的问答机器人。命令层由人手动触发,代理层负责委派任务,技能库存放按需加载的专业知识。三层各司其职,形成一条可复用的开发流水线。
第一层:17个斜杠命令,手动触发的入口
斜杠命令是整套工作流的手动触发点,按用途分成六组:开发流程、经验沉淀、环境规范、技能管理、生图和通知开关。输入斜杠加名字即可调用。
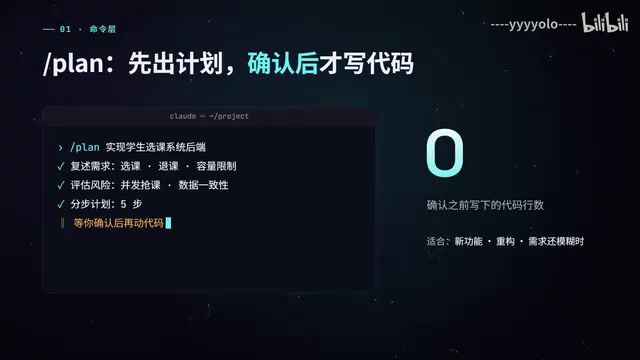
最常用的是 /plan。它会先复述需求、评估风险、拆出分步计划,然后停下来等确认——确认之前一行代码都不写。这个"先规划后动手"的约束,恰恰是很多人用AI写代码时最缺失的一环。
代码写完后,还设了三道关卡:/build-fix 按最小改动修复关键报错,/quality-gate 做单文件质量门禁,/test-coverage 找出覆盖率缺口并补测试。这三道关把"写完就完事"变成了"写完只是开始"。
第二层:14个子代理,独立上下文里干活
子代理最大的价值,是它们在独立的上下文里工作,不会挤占主对话。用法很直白,直接说"用Code Reviewer审查这次改动",或者让主对话按任务自动委派。
14个代理分成三组。规划与开发组里,Planner负责拆需求,Architect做架构选型,TDD Guide带你测试先行,Docs Lookup查最新官方文档,Front-end Scout专门核实前端库的许可证和体积——这个细节颇有工程意识,因为许可证和包体积正是前端选型中最容易踩坑的地方。
审查组负责把关:Code Reviewer每次改完代码必用,Security Reviewer专查注入和密钥泄漏,Database Reviewer管SQL和表结构,C++和Java各有专属审查员。修复组则负责救火,编译报错交给Build Error Resolver,Reflector Cleaner负责清理死代码,且只做最小改进、不碰架构。

代理分组的逻辑清晰:规划、审查、修复三个阶段对应软件开发的不同环节,让专业的代理干专业的事,比一个通用助手包揽全部要可靠得多。
所谓"独立上下文",指的是每个子代理启动时拥有一个全新的对话窗口,不携带主对话的历史记录。大型语言模型存在上下文窗口限制(Claude目前最高约20万token),当主对话积累了大量代码、讨论和中间结果后,继续追加内容会导致早期关键信息被"挤出"窗口,模型开始遗忘细节、产生前后矛盾。把审查、修复等任务交给独立的子代理,等于给每个专项任务开一张白纸,既保留了主对话的完整上下文,又让子代理以最清醒的状态处理局部问题。这也是为什么"Code Reviewer每次改完代码必用"——它始终以新鲜视角审视改动,而不会受到主对话中大量背景信息的干扰。
第三层:105个技能,按需加载的知识包
技能是这套体系里数量最庞大的部分。它们平时不占用上下文,提到关键词时自动触发,也可以点名调用。按来源分成几个系列:
- 宝玉系列(14个):主攻中文内容,涵盖AI生图、文章配图、封面、信息图、三档精度的翻译,还能把网页和YouTube字幕转成Markdown,甚至总结微信群聊。
- Superpower Hours系列(11个):一套开发纪律——先头脑风暴,再写计划,按计划执行,请求评审,最后必须跑验证拿到证据才能说"完成"。
- 工程工作流系列(18个):多来自Mapacock。Grillme对方案连环拷问,Handoff把长对话压缩成交接文档,Prototype用丢弃式原型验证设计,Setup Precommit一键配好提交前检查。

- UI设计系列(12个):UI UX Pro Max是风格和配色数据库,Frontend Design给页面定视觉方向,Fixing Accessibility补齐无障碍。
- 动效与视频系列(26个):数量最多,核心是Hyperframes,用HTML写视频、宣传片、讲解视频和字幕。据UP主介绍,这条视频本身就是用它做出来的。
- 文档与图表系列:处理PDF、PPT、Excel,Archify能一句话生成可交互的架构图。
此外还有UP主自写的工具链:Toolchain记住本机每个工具的路径,Trap和Retrospect管理陷阱库,以及7个本地私有技能,比如Conventions规定注释一律用中文。

技能的"按需加载"机制在工程上类似于动态链接库(DLL)或懒加载模块:平时不占用内存(上下文),只在被引用时才载入。这与把所有规范、知识直接写进系统提示词(System Prompt)的做法形成对比——后者会让每次对话一开始就消耗大量token预算,且大多数内容在当次任务中根本用不到。通过关键词自动触发或点名调用,技能库实现了"用到什么加载什么"的精细化上下文管理。对于105个技能这种规模的知识体系来说,这种机制几乎是唯一可行的组织方式,否则仅技能说明本身就会把可用上下文耗尽。
三层如何配合:一条可复用的流水线
单看三层各自的功能还不够,真正的价值在于它们如何串成一条流水线。写一个功能的完整流程是这样的:
/plan 出计划 → TDD Guide 先写测试 → Code Reviewer 审查 → Verification 拿证据验收 → /retrospect 复盘。
复盘环节尤其关键。每次复盘的经验会写进PostgreSQL陷阱库,目前已经积累了83条。下次遇到同类报错,用 /trap 加关键词就能直接查到当时的根因和解法——同一个坑,不踩第二次。这套机制把个人经验沉淀成了可查询的结构化知识,是整套工作流最有复利价值的部分。
技能本身也需要维护:每两三个月更新一次,先备份再用SkillsAd拉新版本,最后运行 /help 让说明书自动刷新。
PostgreSQL在这套体系里扮演的是持久化外部记忆的角色。大语言模型本身没有跨会话记忆——每次对话结束,对话中产生的经验和教训都会消失。将陷阱库存入关系型数据库,意味着这份知识独立于任何一次对话存活,可以被检索、被更新、被版本管理。选用PostgreSQL而非纯文本文件或向量数据库,还意味着可以用结构化查询精确匹配报错类型、根因分类等字段,而不是依赖语义相似度的模糊搜索。83条记录听起来不多,但每条都对应一次真实踩坑的根因与解法,其密度远高于泛泛的文档说明。这种"把失败货币化"的机制,是整套工作流产生复利效应的关键。
这套工作流的启发
抛开具体的命令和技能名称,这套体系真正值得借鉴的是它的组织哲学:把AI能力拆分成有明确职责的角色,用手动命令控制关键节点,用独立上下文避免污染主对话,用陷阱库实现经验的持续沉淀。
工具会过时,分工不会。当AI从"一个万能助手"变成"一个有分工、会复盘的团队"时,它的可靠性和可复用性才真正上了一个台阶。对于每天大量使用AI编程的开发者来说,投入时间搭建这样一套流程,回报是明确的。
相关推荐

两年AI Agent工程师面试复盘:Token成本、LangGraph与生产事故
通过一场两年经验AI Agent工程师的真实面试复盘,深入解析LangGraph节点与边的成本关联、MCP协议、多Agent架构、Token成本工程,以及一次研究Agent死循环生产事故的完整排查过程。

DAWIS:用窗口化逆采样统一数据同化的滤波与平滑
DAWIS 是一种基于多任务随机插值器的统一数据同化方法,通过窗口化逆采样实现滤波、固定延迟平滑与块平滑。它能随新观测回溯修正历史状态,并在稀疏、含噪声、非线性观测下超越现有基线。

SDECast:用神经随机微分方程实现连续时间天气预报
SDECast 提出用神经随机微分方程(Neural SDE)实现连续时间概率性天气预报,解决自回归模型误差累积问题,并在逐小时全球预报中实现最长五天的技巧性预报。