Claude Code深度解析:Vibe Coding如何重塑AI编程

Claude Code 通过项目级上下文与自动纠错,把 AI 编程从补全代码推进到接管任务。
文章基于 B 站 UP 主「豹哥」的直播分享,梳理了 Claude Code 相较网页端对话式编码的核心差异:它能读取整个项目作为上下文,并在生成后自动调整错误,输出可运行版本。横向对比 Copilot、Cursor、TRAE、OpenCode 后,UP 主认为 Claude Code 准确度更高,但这一结论带有主观体感色彩,且对 Codex 实操经验有限。文章进一步讨论了 Vibe Coding 的成立前提是模型可靠性,准确度直接决定提效还是返工,并指出 Claude Code 本地安装门槛不高、实际用过的人却不多,工具选型还需考虑调用成本与网络可用性。
AI编程助手正在经历一轮肉眼可见的迭代。从早期的代码补全插件,到能自主读写项目文件的Agent式工具,开发者与代码的交互方式已经发生了实质变化。B站UP主「豹哥」在一场直播公开课中,围绕Claude Code展开了一场偏实战的分享,并将其与Copilot、Cursor、TRAE、OpenCode等工具做了横向对比。本文基于该分享的核心观点,结合当前AI编程工具的演进脉络,尝试梳理Claude Code到底改变了什么。
从对话式编码到项目级Agent
UP主在直播中反复强调一个区分:在DeepSeek广告或ChatGPT网页端对话写代码,和在IDE里运行Claude Code,是两种不同的工作模式。前者给出的是代码片段,需要开发者自己粘贴、运行、调试,再把报错贴回去继续对话;后者则能直接读取项目目录,把多个文件作为上下文交给模型,生成贴合当前工程结构的代码。
这个差异听起来只是「方便一点」,实际影响却很大。对话式编码的瓶颈在于上下文窗口——模型看不到你的项目全貌,只能基于你手动粘贴的片段做局部推理。而Claude Code这类工具把「读项目」变成了默认动作,模型拿到的信息量级完全不同。UP主的判断是,Claude Code能通读项目所有内容并作为上下文,还能在生成后自动调整错误,最终给出可运行的版本。
上下文窗口(Context Window) 是大模型单次推理能处理的 token 总量上限,token 大致对应英文单词或中文汉字的一部分。对话式编码时,开发者手动粘贴的片段往往只有几百到几千 token,模型只能看到局部代码;而 Claude Code 这类工具会把项目目录中的多个文件、依赖声明甚至目录结构一并打包进上下文,动辄消耗数万 token。这解释了两者输出质量的差距:模型看到的工程信息越完整,越不容易生成与现有函数签名、命名规范冲突的代码。上下文窗口的大小也直接决定了工具能「理解」多大的项目,超出窗口的部分通常需要靠检索或摘要策略来压缩。
横向对比:Copilot、Cursor、TRAE与OpenCode
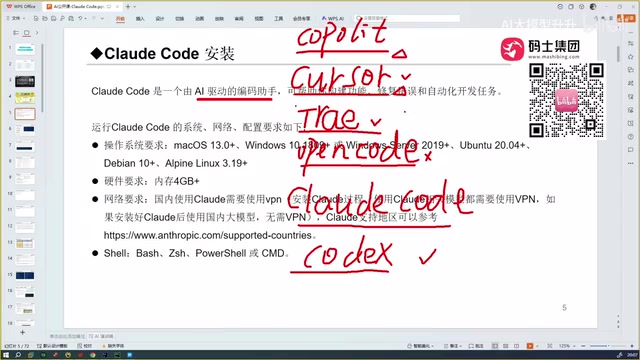
直播中有一段比较坦率的工具点评。UP主回顾了自己的使用路径:最早用Copilot,感觉补全能力有颠覆性;Cursor出现后,自动化编码更进一步;TRAE国内版免费且对中文理解到位,一度是他认为最顺手的工具;OpenCode则被他直接评价为「所有编程工具里比较难用的一个」。
转折点出现在使用Claude Code之后。他的原话是,遇到Claude Code后不再认为TRAE是最完美的,Claude Code「比TRAE还要上一个等级」。原因归结到大模型本身——所有编程助手的能力上限取决于背后模型,Claude Code调用的Sonnet系列模型在代码生成的准确度上表现突出。他也提到Codex(配置GPT-5)同样很强,业内认为可与Claude Code相媲美,但他本人对Codex的实操经验有限。
你可能没注意到,UP主对TRAE的评价是「免费是优势,但稍偏的技术栈写出来就比较不行」。这其实点出了一个现实问题:免费工具和付费工具在模型能力上的差距,会直接体现在边缘场景的代码质量上。
文章中提到的 Sonnet 系列是 Anthropic 推出的 Claude 模型分支,定位在能力与成本之间取得平衡,常被用于编程、长文档处理等任务;Codex 则是 OpenAI 的代码模型系列,GPT-5 是其后续通用模型的代号。需要说明的是,这类模型版本迭代极快,具体版本号与能力排名在几个月内就可能变化,因此「哪个模型写代码更强」的结论具有时效性。工具层面的差异(如上下文管理策略、文件读写权限、纠错循环设计)同样会影响最终体验,不能简单归因于底层模型。
Vibe Coding的实质:准确度决定体验
直播中观众问Claude Code相比Cursor的优势在哪,UP主的回答很直接:准确性。这几个工具都能做到自动编程,但用下来的体感差异集中在「一次生成能否跑通」。
这背后是Vibe Coding这个概念的核心矛盾。所谓Vibe Coding,指的是开发者用自然语言描述意图、由AI完成实现、人更多扮演审阅者角色的工作方式。它成立的前提是模型足够可靠——如果生成的代码需要大量返工,那所谓的「氛围编程」就退化成更繁琐的对话调试。UP主提到「程序员用了之后会有深深的危机感」,这句话的潜台词是,当工具能在项目级别自主读写和纠错时,初级编码工作的价值锚点正在移动。
Vibe Coding 一词由 Andrej Karpathy 在 2025 年初提出,形容一种「完全沉浸在氛围中」的编程方式:开发者用自然语言描述需求,接受 AI 生成的代码而不逐行审查,遇到报错就把错误信息丢回给模型继续迭代。它与传统的「AI 辅助补全」不同,人从写代码的人变成了描述意图和验收结果的人。这种模式对模型可靠性的要求被显著放大——一次生成能跑通,就是效率倍增;需要反复返工,调试成本反而超过手写。业界讨论中常把它与「AI 结对编程」区分开,后者仍强调人对每一行产出的审阅。
上手门槛与适用人群
一个容易被忽略的信息是,Claude Code的安装门槛并不高。UP主在开场就点明,这个工具不需要登录任何网站,直接在本地电脑安装,然后在开发工具里调用即可。它对系统有要求,但绝大多数主流系统都支持。
他在直播中做过一个现场调研:问观众有没有用过Claude Code,用过的敲6,没用过的敲0,结果是「没用过的还是挺多的」。这反映出一种认知落差——工具在技术社区讨论度很高,但实际动手用过的人比例并不高。对于零基础学习者,UP主的建议是先跑起来,不必先啃原理。
直播中还提到了配套的学习资源,包括四天训练营的课堂笔记、实战代码、DeepSeek论文、一份号称220多万字的面试宝典,以及Java和人工智能的零基础课程。这部分属于课程推广内容,与工具本身的技术讨论需要区分看待。
几点冷静的判断
这场分享的信息密度不低,但有几处需要读者自己权衡。
模型能力的对比带有较强的主观体感色彩。UP主承认自己「用的国外的比较少」,对Codex的实操经验有限,因此Claude Code最强的结论更接近个人使用偏好而非严格评测。准确度这个维度也很难用单一案例说明,不同技术栈、不同项目规模下的表现可能有差异。
另外,Claude Code背后模型的调用成本、国内网络环境下的可用性,直播中没有展开。这些因素对实际落地的影响不比模型能力小。工具选型最终还是要回到自己的项目类型、预算和团队协作方式上,而不是单纯比较榜单。
不过有一点判断是成立的:AI编程助手已经从「补全一行代码」进化到「接管一个任务」,开发者的核心技能正在从写代码向描述需求、审阅产出、把控架构迁移。这个趋势不会因为某个具体工具的强弱而改变。
相关推荐

Claude Code免费不限量方案:Agnes AI+CC Switch配置指南
无需付费订阅,用免费AI平台Agnes AI配合开源工具CC Switch为Claude Code提供后端,实现文本、图片、视频模型不限量免费调用。本文梳理安装配置全流程、实测效果与使用边界,帮助开发者低成本上手Claude Code。

国内新手零成本上手Claude Code完整指南
面向国内新手的 Claude Code 入门指南:两种安装方式(命令行与 IDE 插件)、用国产免费模型 LongCat 替代官方 API 的完整配置步骤,以及用自然语言开发小工具的实操演示与技巧。

当NSA都介入:开源CVE与API密钥劫持背后的AI供应链危机
一天内多个开源项目曝出严重CVE,PHP漏洞惊动FBI,Railway与OpenCode遭入侵致API密钥被窃。本文拆解漏洞窗口、AI加速利用与API密钥黑市背后的AI供应链危机,并给出开发者防御清单。