Claude Code省钱指南:四大暗坑与三层成本优化

标价虽降,缓存断崖、子代理偷跑、高档溢价与低效输出四个暗坑仍在推高账单。
文章指出,许多团队升级到 Opus 5.5 后虽享受了官方降价与缓存折扣,月度账单却依然高企,根源在于四个藏在后台的成本暗坑:一是缓存寿命在 API 或云网关下缩短到 5 分钟,12 万 Token 停 6 分钟后读取成本从 0.024 美元涨到 0.60 美元;二是内置 Explore 代理默认继承主模型,多智能体场景成本可达常规用法的 7 倍;三是上下文跨过 10 万 Token 后 High 档涨价 5 倍、高分辨率大图溢价约 2.5 倍;四是低效升级与冗余输出。文章进而给出官方三层账本方案:按任务分配模型、用轻量模型先跑全量再升级难题、日常用 Medium 档,并强调离席前趁热执行上下文压缩。作者提醒这些数字属于单一来源参考值,建议先小范围对照测试再全面调整。
为什么标价降了,账单却更贵了?
很多团队升级到 Opus 5.5 后发现一个反常现象:官方标价降了 20%,缓存成本降了 60%,但月度账单依然烧得飞快。据 B 站 UP 主在视频中引用 Anthropic 连发的 5 篇官方成本手册,问题不在定价,而在四个藏在后台的"漏钱暗坑"。
这些暗坑的代价可以用一个简单场景说明:喝杯咖啡离开 6 分钟,回来让模型继续下一句话,成本可能贵了近 30 倍。理解这些机制,比单纯换模型更能决定账单量级。
暗坑一:缓存断崖与输出刺客
缓存的寿命不是一小时,而是五分钟
套餐内的缓存保留时间是一小时,但一旦走 API、云网关或额外点数,寿命会缩短到 5 分钟。视频给出了一个实测数据:12 万 Token 的上下文停 6 分钟后,原本 0.024 美元的缓存读取,秒变成 0.60 美元的上下文重写。
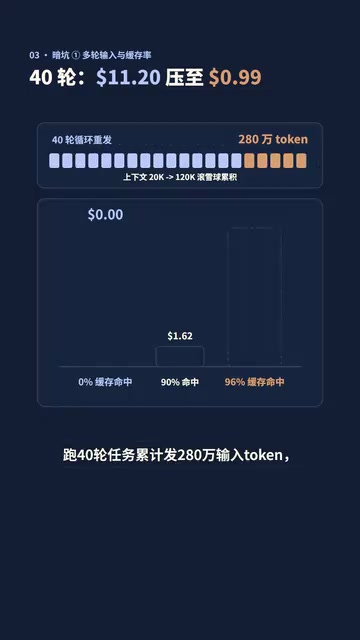
更值得记住的是缓存的整体收益量级。跑 40 轮任务累计发送 280 万输入 Token 时,零缓存要花 11.20 美元,而 96% 缓存命中只要 0.99 美元。差了一个数量级,这也解释了为什么"停一会儿再聊"是很贵的操作。
什么是 Prompt Caching? 大模型 API 通常按输入 Token 计费,而 Prompt Caching 允许服务端把一段较长的前缀(如系统提示、代码库上下文)的中间计算结果(KV Cache)保留一段时间。下次请求若命中相同前缀,就可直接复用,按远低于正常输入的价格(常见为 10% 左右)计费,从而大幅降低成本。但缓存有 TTL(存活时间),过期后需重新计算并写入,价格回到正常输入水平。因此「停一会儿再聊」会导致缓存冷掉,原本廉价的缓存读取变成昂贵的上下文重写——这正是文中 5 分钟寿命带来的成本断崖。
输出 Token 的定价权重
视频中提到的另一个隐蔽点是:一个输出 Token 的成本相当于 100 个缓存 Token,而模型的隐藏思考也会被计入输出。也就是说,让模型"多想一会儿",账单的压力主要来自输出侧,而不是输入侧。

为什么输出比输入贵? 大模型 API 的定价中,输出 Token 单价通常远高于输入 Token(常见为 3-5 倍甚至更高),因为自回归生成需要逐 Token 串行计算,无法像输入那样并行处理,对算力和延迟的占用更大。此外,部分模型(尤其是推理型模型)会把「隐藏思考」或推理过程也计入输出 Token,即便这些内容不展示给用户。当模型被要求「多想一会儿」时,额外生成的思考 Token 全部按输出单价结算,账单压力自然集中在输出侧。文中「1 个输出 Token 相当于 100 个缓存 Token」的对比,正是这一权重差距的极端体现。
暗坑二:子代理偷跑,主模型高价买单
内置的 Explore 代理默认继承主模型。当它去搜文件、读日志时,这些本可以交给轻量模型的活,全按 Opus 的高价结算。视频指出,在多智能体规划场景下,成本甚至可以达到常规用法的 7 倍。
这是一个容易被忽略的架构问题:多智能体的编排逻辑本身没错,但如果没有为"读日志、找文件"这类低价值高频率任务指定更便宜的模型,成本会被无声地放大。
什么是子代理(Sub-agent)与多智能体编排? 在 Claude Code 等 Agent 框架中,主模型可以派生出子代理去执行特定子任务,例如 Explore 代理负责搜索文件、读取日志、定位代码。子代理默认往往继承主模型的配置与定价,意味着这些低价值的检索类工作也会按主模型(如 Opus)的高价结算。多智能体编排的价值在于分工,但如果不对子代理单独指定更便宜的模型,成本会被无声放大——尤其是在规划阶段频繁调用多个子代理时,累积的 Token 消耗可达常规用法的数倍。
暗坑三:High 档与高分辨率图像
当上下文跨过 10 万 Token 后,High 档的价格会暴涨 5 倍。发高分辨率大图同样会触发约 2.5 倍的溢价。这两条规则叠加起来,长篇对话加图片输入的组合是最容易失控的场景。
什么是 High 档与上下文分档计价? 部分模型服务会按任务难度或上下文长度划分档位(如 Medium / High / Max),不同档位对应不同的推理强度与单价。当上下文超过一定阈值(如 10 万 Token)后,部分档位会触发更高的计价倍率,因为长上下文对显存和计算的开销显著上升。高分辨率图像输入同理:图片会被切分为大量视觉 Token 参与计算,分辨率越高 Token 数越多,溢价也就越明显。长篇对话叠加图片输入,恰好同时触发这两条规则,是最容易失控的组合场景。
暗坑四:低效升级与废话输出
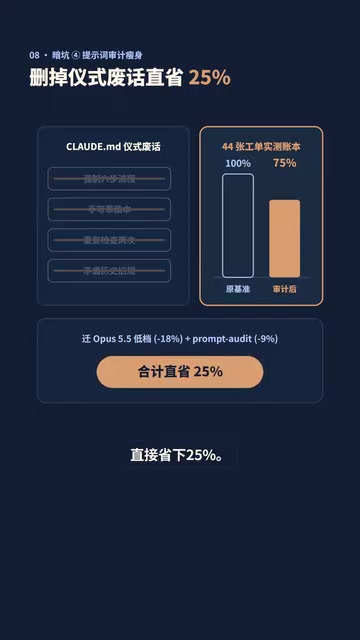
最后一个坑更偏使用习惯:不必要的档位升级,以及模型输出中的冗余内容,都会推高账单。视频提到,由低档起步并配合官方审计清理规则,可以直接省下 25% 左右。
官方三层账本:一套可落地的止血方案
视频把优化方案归纳为三层,逻辑是从"谁干什么活"到"怎么控制轮数"再到"按任务难度选档"。
第一层:按任务分配模型
把 Explore 和读日志这类任务锁死在 High 档,核心改代码的工作留给 Opus 5.5。视频提到一个 220 万 Token 源码排查的实测:一个 Opus 领队配合轻量模型的组合,准确率持平,成本直降三分之一。这是性价比最高的一层改动,因为它不牺牲结果质量。
第二层:自动化测试压缩轮数
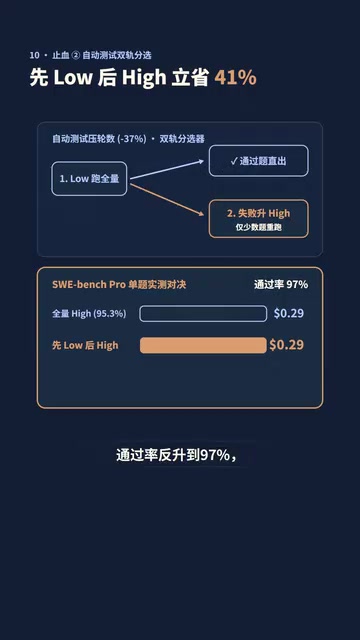
先用轻量模型跑全量,失败的用例再升到 High 档重跑。视频给出的结果是:通过率反而升到 97%,单次成本从 0.29 美元降到 0.17 美元,节省 41%。这里的洞察是,贵模型用在"筛选后的难题"上,比用在"全量任务"上更划算。
第三层:日常用 Medium,极难任务换档
日常任务稳定使用默认 Medium 档,极难任务切到 Fable 5.2 的 High 档。视频称该组合得分与 Opus 的 Max 档持平,成本还能省一半。
离席前的收尾动作
视频还提到一个具体操作:离开前趁上下文还热,跑一次 Contact 压缩,成本约 0.25%;如果等缓存冷掉,光输入就要 0.75。这一条看似细节,但直接对应了第一个暗坑的成因。
这些数字该怎么看
需要说明的是,以上成本数字和节省比例均来自该 UP 主引用的官方手册与个人实测,属于单一来源的参考值。不同团队的任务结构、上下文长度和调用方式差异很大,实际节省幅度会有出入。建议先按三层账本做小范围对照测试,再决定是否全面调整配置。
核心逻辑并不依赖具体数字:把高频低价值任务交给便宜模型,把贵模型留给筛选后的难题,并避免让缓存在不必要的时候冷掉。这三条在任何定价体系下都成立。
相关推荐

阿尔茨海默病真实体验:从自知到遗忘的五年
一位家属讲述陪伴父亲走过阿尔茨海默病最后五年的真实经历:早期患者自知却否认,中期问题从自身转向家人,终末期一切功能逐一关闭。揭示患者视角下最令人恐惧的疾病体验。

单个图超网络零样本生成多架构权重,开源实现跨模态泛化
Reddit开发者开源图超网络GHN,单次前向传播为零样本生成ResNet、MLP-Mixer、MobileNet和Transformer权重,覆盖视觉、文本、波形模态,并公布零样本准确率。
图注意力网络+低成本硬件:癫痫检测新方案
解读一项基于图注意力网络(GAT)与可获取硬件的癫痫检测研究:为何选择图神经网络处理EEG信号、低成本硬件带来的信号挑战,以及该方案在低资源地区落地的现实障碍与社区质疑。